Il dizionario di un encoder LZW è sempre di una voce avanti rispetto al decoder che leggerà il suo output, quindi i due lati non possono condividere un'unica soglia di larghezza codice. PDFlibPas dà a TPLLZWEncoder e TPDFLZWDecompressor soglie separate derivate dallo stesso flag EarlyChange, e quel vantaggio di una voce è esattamente il motivo per cui il flag esiste
Quasi ogni implementazione LZW fatta a mano sbaglia lo stesso punto. Scrivi prima il decoder, perché è quello che ti serve per aprire i file. Funziona. Poi scrivi l'encoder, rispecchi la logica del decoder riga per riga perché LZW è simmetrico, lanci un test di round-trip e passa. Lo pubblichi. Sei mesi dopo un cliente apre il tuo output in un viewer che non è il tuo, ed è spazzatura da un punto a metà dello stream in poi. Il rispecchiamento era il bug: le due metà di LZW non sono simmetriche, e far finta che lo siano produce stream che solo il tuo codice sa leggere
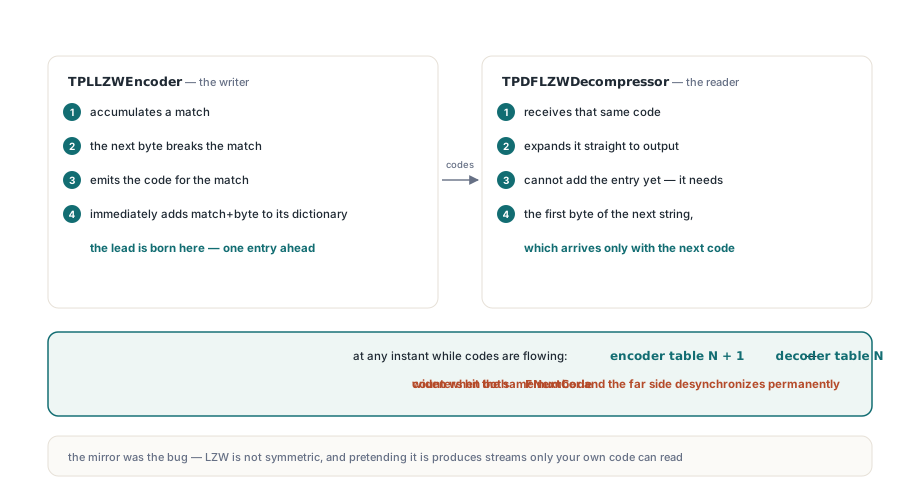
Perché l'encoder ha bisogno di una soglia diversa dal decoder?
Perché l'encoder impara ogni voce del dizionario un passo prima di quanto possa il decoder. Non è una scelta di design in PDFlibPas: è intrinseco a come funziona LZW, e ogni implementazione corretta deve compensarlo da qualche parte. Percorri il ciclo e vedi da dove arriva il vantaggio. L'encoder accumula una corrispondenza, scopre che il byte successivo la rompe, emette il codice della corrispondenza e aggiunge subito corrispondenza-più-byte al suo dizionario. Il decoder riceve lo stesso codice e lo espande, ma non può ancora aggiungere la voce corrispondente, perché la nuova voce ha bisogno del primo byte della stringa successiva, che arriva solo con il codice seguente. Quindi in ogni istante in cui scorrono i codici, la tabella dell'encoder contiene una voce in più di quella del decoder. Se entrambi i lati allargano il codice da 9 a 10 bit quando il loro FNextCode raggiunge lo stesso numero, si allargano a un codice di distanza e il lettore di bit dall'altra parte si desincronizza per sempre. In TPDFLZWDecompressor.ResetDictionary la soglia del decoder viene calcolata una volta sola e salvata in FChangeCode:
// TPDFLZWDecompressor.ResetDictionary: il lato decoder della soglia
FCodeSize := FInitialCodeSize;                 // 9 per LZWDecode in PDF
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // allarga quando FNextCode arriva a 511
else
  FChangeCode := FBitMask + 1;                 // allarga quando FNextCode arriva a 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
Il ciclo di decodifica allarga subito dopo aver aggiunto una voce, testando (FNextCode = FChangeCode) and (FCodeSize < 12) e ricalcolando sia FBitMask sia FChangeCode per la nuova larghezza. Nove bit scattano a 511 o 512, dieci bit a 1023 o 1024, undici bit a 2047 o 2048, e dodici bit è il tetto oltre il quale il dizionario va svuotato con un ClearCode invece di crescere. L'encoder non può riusare nessuno di quei numeri. Il suo GrowCodeSize aggiunge uno per compensare il vantaggio, quindi con EarlyChange attivo allarga a 512 mentre il decoder allarga a 511:
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 mentre siamo a 9 bit
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 mentre siamo a 9 bit
  // Il decoder aggiunge la sua ultima voce in sospeso prima di leggere EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;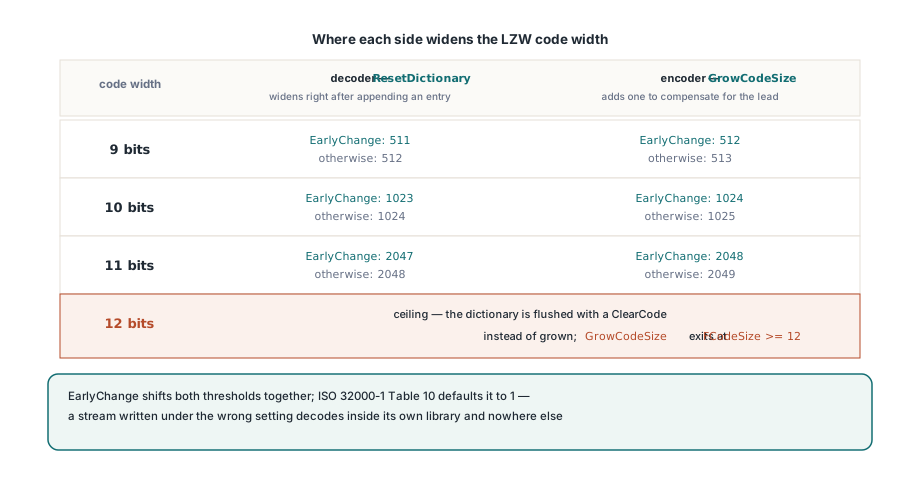
L'ultimo data code è dove i due lati finalmente si incontrano
La fine dello stream è l'unico punto in cui l'encoder deve smettere di fare da guida e pensare come il decoder, ed è a questo che serve il parametro FinalDataCode di GrowCodeSize. Se emetti il codice EOI alla larghezza sbagliata, tutto ciò che lo precede resta perfettamente valido, quindi il difetto si nasconde dietro migliaia di byte corretti. La sequenza è questa. L'encoder emette il suo ultimo data code e, a differenza di ogni iterazione precedente, dopo non aggiunge nulla al suo dizionario, perché non resta alcun byte successivo con cui estendere la corrispondenza. Il decoder fa l'opposto: riceve quel codice finale, e solo ora può completare la voce che teneva in sospeso dal codice precedente. All'ultimo passo il decoder raggiunge l'encoder, il vantaggio crolla a zero, e la larghezza con cui leggerà l'EOI è decisa da una voce che l'encoder non ha mai creato. Dec(ChangeCode) è l'encoder che finge, per esattamente una chiamata, di essere il decoder:
// TPLLZWEncoder.Compress, la coda dello stream
EmitCode(CurCode);      // data code finale, alla larghezza corrente
GrowCodeSize(True);     // può allargare usando la soglia decrementata
EmitCode(FEOICode);     // EOI alla larghezza che il decoder leggerà davvero
FlushBits;
FlushOutput;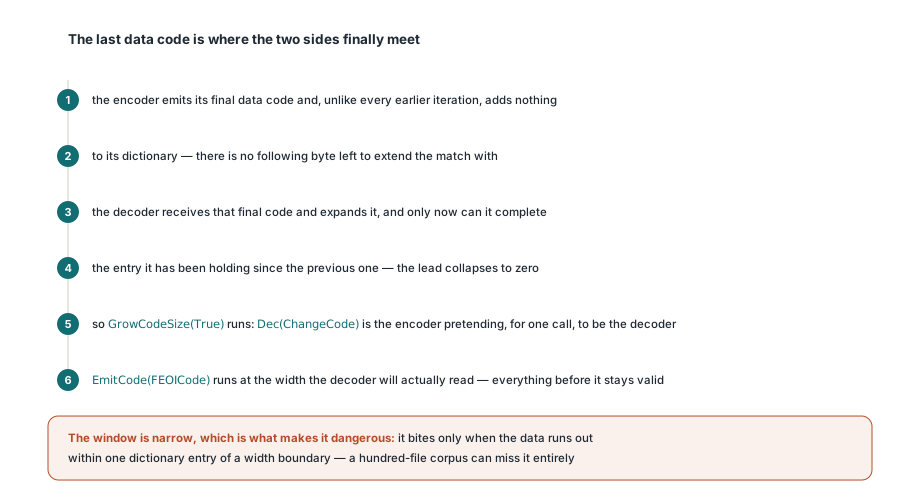
La finestra in cui questo conta è stretta, ed è ciò che la rende pericolosa. Morde solo quando i dati finiscono per caso a una voce di dizionario da un confine di larghezza, quindi un corpus di cento file di test può mancarla del tutto mentre un singolo file di un cliente la centra ogni volta. I casi limite in Compress vanno guidati di proposito: costruisci input il cui dizionario atterra a 510, 511 e 512 voci, poi leggi a mano la larghezza in bit dell'EOI emesso dallo stream invece di dedurla da una decodifica riuscita
Perché un test di round-trip che passa può comunque nascondere uno stream rotto?
Perché due implementazioni che commettono lo stesso errore vanno d'accordo tra loro. Se il tuo encoder e il tuo decoder allargano entrambi un codice troppo presto, o entrambi un codice troppo tardi, restano in sincrono, il round-trip riproduce l'input byte per byte e la suite è verde mentre lo stream che hai prodotto è illeggibile per chiunque altro. È la cosa più preziosa da portarsi via da tutto l'esercizio: per LZW, l'auto-coerenza non vale nulla come prova. Quindi l'auto round-trip non può essere il test primario, e PDFlibPas valida il percorso LZW in altri tre modi. Stream di codice costruiti a mano con il pattern di bit atteso scritto a mano, così l'asserzione riguarda i byte e non il risultato della loro decodifica. Interoperabilità bidirezionale contro implementazioni indipendenti, dove gli stream prodotti da questo encoder vengono decodificati altrove e gli stream prodotti altrove vengono decodificati da TPDFLZWDecompressor. E decodifica differenziale, leggendo gli stessi byte due volte con EarlyChange impostato in entrambi i modi, così uno stream che decodifica pulito con l'impostazione sbagliata ti dice che i confini di larghezza non sono mai stati esercitati:
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // deliberatamente la regola sbagliata per il PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A deve corrispondere alla sorgente; B NON deve corrispondere. Se anche B corrisponde,
// l'input era troppo corto per attraversare un confine di larghezza codice.
Sono gli input esterni a dare davvero questa copertura. Il materiale di test attuale attraversa larghezze di 9, 10, 11 e 12 bit e forza 34 reset del dizionario in un singolo stream, che è l'unico modo realistico di dimostrare che il percorso ClearCode al tetto di 4095 funziona. Se i tuoi fixture non superano mai qualche kilobyte, quel codice non è mai stato eseguito. E quando una correzione cambia ciò che produce il tuo encoder, tratta il vecchio output come rotto invece che come baseline di compatibilità da preservare: uno stream che mescola larghezze di codice in modo sbagliato non è un formato legacy, è un bug che è capitato di finire su disco
Il PDF dice 1, il TIFF dice dipende
PDFlibPas imposta EarlyChange di default a True sia su TPLLZWEncoder sia su TPDFLZWDecompressor perché la Tabella 10 di ISO 32000-1 definisce EarlyChange come parametro di decodifica LZWDecode con valore predefinito 1, cioè la lunghezza del codice aumenta di un codice in anticipo. È specificato nella sezione 7.4.4.2 di ISO 32000-1 insieme ai parametri del predictor, e un PDF che vuole l'altro comportamento deve dichiarare /EarlyChange 0 esplicitamente nel suo dizionario /DecodeParms. Il TIFF è il motivo per cui il flag è una proprietà e non una costante: la sezione 13 di TIFF 6.0 descrive la compressione LZW senza la stessa dichiarazione inequivocabile, e gli encoder in circolazione si sono storicamente divisi su questo, il che è molto probabilmente il motivo per cui la specifica PDF ha sentito il bisogno di dare un nome al parametro. In una pipeline da TIFF a PDF l'impostazione quindi non è qualcosa che puoi hardcodare a nessuno dei due estremi. Qualunque cosa il lato TIFF si sia rivelato avere bisogno va portata esplicitamente nel /DecodeParms del PDF, altrimenti converti un file che si apriva benissimo in uno che non si apre. La stessa cura vale per FillOrder, dove foTop e foBottom scelgono da quale estremità del byte il lettore di bit riempie, e per la differenziazione orizzontale del Predictor 2 TIFF, che TPDFLZWParms trasporta attraverso Predictor, Colors, BitsPerComponent e Columns. Le nostre note su irrobustire il decoder TIFF integrato per BigTIFF e layout tiled coprono il resto di quel percorso
Due trappole più piccole che vale la pena nominare
Entrambe sono facili da cablare male quando hai gli oggetti encoder e decoder aperti fianco a fianco e assumi che la simmetria valga anche lì:
InitialCodeSizenon significa la stessa cosa sulle due classi.TPLLZWEncoder.InitialCodeSizeè la larghezza dei simboli radice, validata da 2 a 8, conInitDictionaryche derivaFClearCodecome1 shl FInitialCodeSizee impostaFCodeSizeaFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeè la prima larghezza di codice, validata da 2 a 9, conResetDictionaryche derivaFClearCodecome1 shl (FCodeSize - 1). Per i normali dati PDF a 8 bit i default sono rispettivamente 8 e 9 e non te ne accorgi mai; impostali entrambi allo stesso numero a mano e ti sei costruito una coppia disallineata- Decodificare LZW non fidato è un problema di memory safety prima ancora che di correttezza, perché gli indici del dizionario arrivano dritti dal file.
TPDFLZWDecompressorrifiuta qualsiasi codice sopra 4095 o uguale o superiore aFNextCode, si rifiuta di aggiungere voci oltre 4095, controlla l'input rimanente in bit prima di ogniGetNextCodee esponeSawExplicitEOIcosì un chiamante può distinguere uno stream terminato correttamente da uno che semplicemente è finito senza byte. Uno stream troncato non è un successo parziale. L'indagine più ampia in irrobustire un parser PDF Pascal contro i file malevoli copre la classe di difetti che queste protezioni chiudono
Cosa ti resta alla fine
LZW sembra simmetrico e non lo è. Il dizionario dell'encoder è in vantaggio di una voce per tutto il corpo dello stream e il vantaggio svanisce sul codice finale, quindi un'implementazione corretta porta due soglie più un caso speciale, e il flag EarlyChange sposta entrambe le soglie insieme. Sbaglia anche una sola delle due di un codice e produci un output valido finché non lo è più, senza errori e senza eccezioni da nessuna parte, solo un viewer da qualche parte che renderizza rumore. Il confine onesto è che niente di tutto questo è testabile dall'interno: nulla nella tua suite può distinguere uno stream corretto da uno coerente ma sbagliato, quindi il controllo di interoperabilità non è un pass extra opzionale, è l'unica prova vera che avrai mai. Entrambe le classi fanno parte della PDF Library for Delphi, che gestisce anche il lavoro strutturale circostante descritto nelle nostre note su object stream e cross-reference stream, per Delphi e C++Builder su tutte le versioni di compilatore supportate dalla libreria