Prendi un file il cui dizionario information dice /Title (Annual Maintenance Report) mentre il suo pacchetto XMP non ha proprio nessun dc:title. I viewer mostrano il titolo senza lamentarsi, eppure un validatore PDF/A rifiuta il file perché le due copie dei metadati sono in disaccordo. Un secondo file sembra altrettanto sano ma non ha nessuna voce pdfaid:part nel suo XMP, e il validatore risponde con decine di errori: giudica il file come un PDF ordinario e riporta come fallita ogni regola della parte rivendicata, tutto da una riga mancante
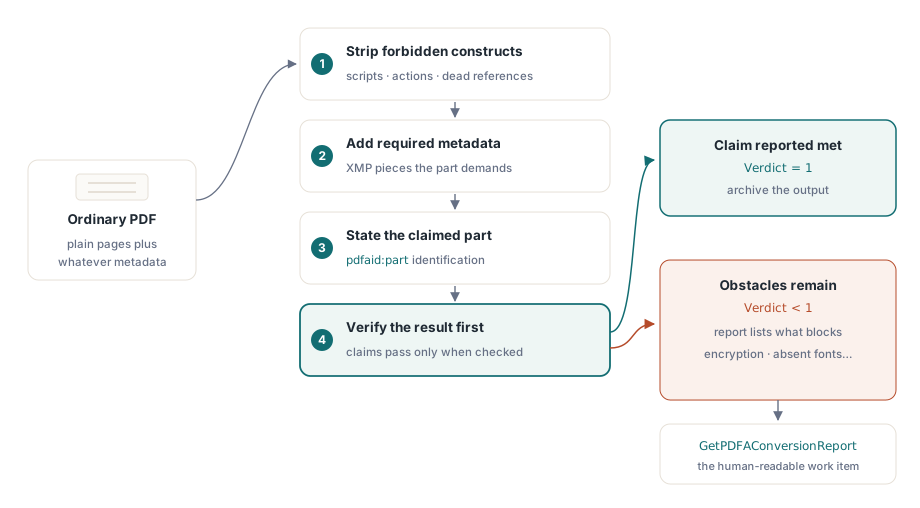
I due problemi chiedono quantità di lavoro molto diverse. Mettere d'accordo i metadati è una correzione stretta che puoi far girare su qualsiasi file. Trasformare un PDF qualunque in uno archivistico significa togliere ciò che la parte di destinazione vieta, aggiungere ciò che richiede, dichiarare la rivendicazione e poi validare i byte che effettivamente escono. Abbiamo costruito la conversione attorno a quell'ultimo passo di proposito. ConvertToPDFA, che viaggia con l'edizione Enterprise (TPDFlibEnterprise) insieme a GetPDFAConversionReport, salva il documento convertito in memoria, fa girare il controllo PDF/A su quei byte e restituisce 1 solo quando quel controllo passa
Perché un PDF che si apre bene fallisce un controllo PDF/A?
Entrambi i fallimenti vengono dalle regole dei metadati. Un PDF registra titolo, autore, producer e date nel dizionario information del documento, e PDF/A richiede anche gli stessi fatti in un pacchetto di metadati XMP; ISO 19005-1 §6.7.3 chiede che le due cose siano equivalenti, e PDF/A-2 e PDF/A-3 mantengono la regola. Tra i file che falliscono su questa regola, lo schema abituale è un producer che ha riempito il dizionario information e non ha mai scritto la metà XMP, così il validatore trova un titolo in un posto e niente nell'altro
L'identificazione mancante è più silenziosa. Le voci pdfaid:part e pdfaid:conformance sono ciò che marca un file come PDF/A, e un file può essere perfettamente ben formato senza di loro. Il caso che vediamo più spesso è un'applicazione che fornisce il proprio pacchetto XMP, sostituendo quello generato dallo scrittore PDF; il pacchetto custom porta i campi dell'applicazione e nessuna voce pdfaid, così la lista degli errori non punta nemmeno lontanamente alla causa vera
RepairDocumentMetadata gestisce entrambi i casi e restituisce il numero di voci che ha cambiato. È disponibile in ogni edizione, così come SetPDFAMode e SanitizeDocument. La riparazione percorre Title, Author, Subject, Keywords, Creator, Producer, CreationDate e ModDate. Dove solo l'XMP porta un valore, il dizionario information viene riempito da quello, così niente di già registrato viene buttato. Dove entrambi portano valori e differiscono, vince il dizionario information. Abbiamo preso questa decisione perché il dizionario information è la metà che i producer impostano più spesso, il che la rende la registrazione più probabile di ciò che l'autore intendeva
Se il tuo XMP è la copia autorevole (diciamo che è stato curato in un sistema di gestione documentale), spingi i valori che vuoi nel dizionario information con SetInformation e solo dopo fai girare la riparazione. Farla al contrario sovrascriverà il tuo titolo XMP curato con qualsiasi cosa il producer originale avesse scritto
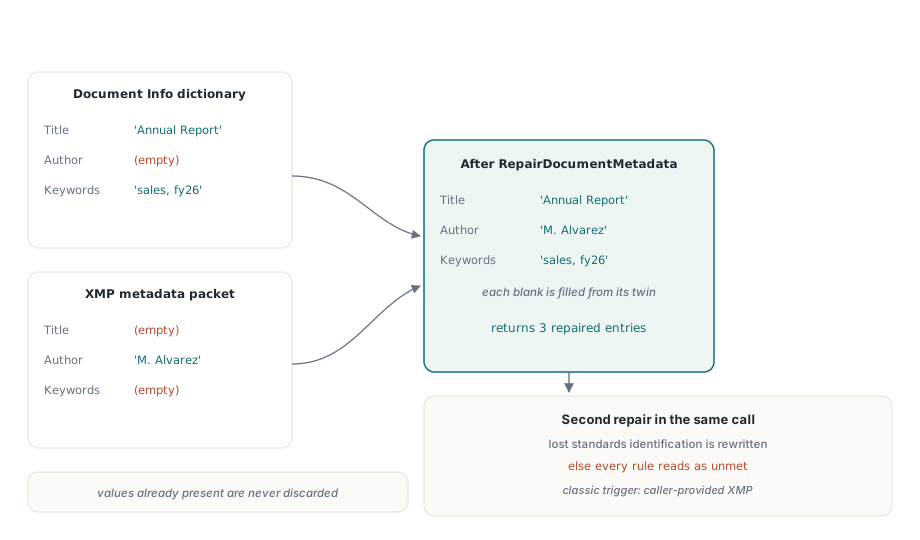
La riparazione dell'identificazione richiede una cosa da te: il documento deve sapere quale parte punta a raggiungere. Un file appena caricato non ha nessuna modalità PDF/A impostata, quindi chiama SetPDFAMode prima della riparazione. Con una modalità a posto, RepairDocumentMetadata scrive le voci pdfaid corrispondenti, aggiunge pdfaid:rev con l'anno 2020 per le modalità della parte 4, e imposta dc:format a application/pdf, che i validatori controllano anch'essa
uses
  SysUtils, PDFlibrary;

procedure RepairIncoming(const InName, OutName: string);
var
  Lib: TPDFlib;
  Fixed: Integer;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      raise Exception.CreateFmt('Cannot open %s', [InName]);

    // Il titolo curato va nel dizionario Info per primo,
    // perché quella copia vince quando le due metà sono in disaccordo
    Lib.SetInformation(2, 'Annual Maintenance Report 2025');

    Lib.SetPDFAMode(3);                  // 3 = PDF/A-2b, vedi la tabella qui sotto
    Fixed := Lib.RepairDocumentMetadata;
    Writeln(Format('%d metadata entries brought into agreement', [Fixed]));

    Lib.SaveToFile(OutName);
  finally
    Lib.Free;
  end;
end;
Scegliere la parte di destinazione e il suo numero di modalità
Scegli la parte in base a ciò che il documento deve portare, e solo dopo cerca il numero. SetPDFAMode e ConvertToPDFA condividono uno schema di numerazione, e non corre nell'ordine che i nomi delle parti suggeriscono
| Modalità | Parte e livello | Note |
|---|---|---|
| 1 | PDF/A-1a | PDF 1.4, con tag |
| 2 | PDF/A-1b | PDF 1.4 |
| 3 | PDF/A-2b | PDF 1.7 |
| 4 | PDF/A-2a | PDF 1.7, con tag |
| 5, 6, 7 | PDF/A-3b, 3a, 3u | File incorporati di qualsiasi tipo permessi |
| 8 | PDF/A-2u | PDF 1.7, testo Unicode richiesto |
| 9, 10, 11 | PDF/A-4, 4e, 4f | PDF 2.0; 4e aggiunge 3D e rich media, 4f permette file incorporati |
La modalità 3 è PDF/A-2b e la modalità 4 è PDF/A-2a. Quell'inversione becca chi conta partendo da 1a e dà per scontato che il livello a venga sempre prima. PDF/A-2u compare all'8, dopo le modalità della parte 3
La scelta con conseguenze vere riguarda gli allegati. Le parti 1 e 2 vietano i file incorporati, quindi ConvertToPDFA li rimuove per le modalità da 1 a 4 e per l'8. Converti una fattura Factur-X o ZUGFeRD alla modalità 3 e la fattura XML strutturata sparisce dall'output, insieme alla ragione per cui il file esisteva. Per qualsiasi cosa porti un allegato punta alla modalità 5 (PDF/A-3b), che è anche la parte su cui quei formati di fattura sono definiti, o all'11 se ti serve PDF 2.0. Ogni allegato in un file di parte 3 o parte 4 deve dichiarare come si relaziona al documento attraverso /AFRelationship, e PDF Library for Delphi scrive quella voce per ogni file incorporato che salva in quelle modalità
La parte 4 si identifica in modo diverso. Non ha lettera di conformità per il PDF/A-4 semplice, usa E o F per le due estensioni, e richiede pdfaid:rev con l'anno di pubblicazione della sua parte. ConvertToPDFA porta il file a PDF 2.0 per le modalità da 9 a 11, perché ISO 19005-4 §6.1.2 costruisce la parte su PDF 2.0, e il controllo giudica quei file contro PDF 2.0 invece che contro 1.7
Cosa cambia ConvertToPDFA nel file
ConvertToPDFA esegue una sequenza fissa di riparazioni, annota ognuna in un report in testo semplice, salva il risultato in memoria e valida quei byte. Un controllo fallito restituisce 0, e così una modalità fuori dall'intervallo 1-11, che restituisce prima che qualsiasi report venga scritto. La sequenza vale la pena conoscerla, perché ogni passo è qualcosa che l'output perderà o guadagnerà:
- Un documento cifrato la cui password è sconosciuta ferma la conversione all'istante con una riga
blocked:; dentro non si può leggere niente, figurarsi riparare - Il JavaScript a livello di documento e l'open action che lo esegue vengono rimossi, insieme a ogni voce di additional-actions e ai tipi di azione che nessuna parte permette, tra cui Launch, Sound, Movie, ResetForm, ImportData, Hide, SetOCGState, Rendition e Trans. I link GoTo e URI restano, quindi la navigazione continua a funzionare
- I file incorporati vengono rimossi per le parti che li vietano, come descritto sopra
- Le annotazioni nascoste o impostate per non essere mai mostrate vengono cancellate. PDF/A richiede che le annotazioni siano visibili e stampabili, e rivelarle cambierebbe l'aspetto della pagina, quindi abbiamo scelto la rimozione
- Gli aspetti dei campi form vengono rigenerati prima che il flag
/NeedAppearancesvenga ripulito, così i valori compilati restano visibili - I font usati ma non incorporati vengono incorporati dai font installati sulla macchina
- Gli oggetti a cui più niente si riferisce vengono buttati, e viene aggiunto un output intent sRGB se il file non ne ha uno
- Infine la parte e il livello vengono dichiarati nell'XMP, e i byte vengono controllati
Su un server, il passo dei font è quello più probabile per bloccare una conversione. Un documento che usa un font che non esiste da nessuna parte sull'host di conversione non può essere riparato dall'interno del file, e il report lo dirà. Installa sulla macchina di conversione i font che i tuoi documenti usano davvero; la guida su incorporare i font mancanti in un PDF esistente copre quel passo da solo
Come dovrebbe gestire un job batch una conversione che fallisce?
Tratta il valore di ritorno come un cancello e il report come il biglietto di lavoro. Archivia i file che restituiscono 1, e gira il resto a una persona con il report allegato. Non salvare l'output di una conversione fallita nell'archivio solo perché sembra più pulito dell'input. Quel file ora porta una rivendicazione PDF/A che il controllo ha rifiutato di confermare, che è esattamente la situazione che il passo di verifica esiste per prevenire
Il report di GetPDFAConversionReport è una riga per azione, ognuna che inizia con un verbo: removed:, regenerated:, repaired:, embedded:, added:, stated:, più blocked: se qualcosa ha fermato l'esecuzione, e una riga finale result:. Il controllo dietro il verdetto si ferma al primo fallimento, quindi quando un file fallisce, la conversione fa girare di nuovo il controllo per intero e il report mostra ogni problema in una volta sola. Instradare sui prefissi richiede poche righe
uses
  Classes, SysUtils, PDFlibrary, PDFlibEnterprise;

function ArchiveOne(const InName, ArchiveDir, ReviewDir: string): Boolean;
var
  Lib: TPDFlibEnterprise;
  Report: TStringList;
  I: Integer;
  Blocked: Boolean;
begin
  Result := False;
  Lib := TPDFlibEnterprise.Create;
  Report := TStringList.Create;
  try
    if Lib.LoadFromFile(InName, '') <> 1 then
      Exit;
    Result := Lib.ConvertToPDFA(5) = 1;      // 5 = PDF/A-3b, conserva gli allegati
    Report.Text := Lib.GetPDFAConversionReport;
    if Result then
      Lib.SaveToFile(IncludeTrailingPathDelimiter(ArchiveDir) + ExtractFileName(InName))
    else
    begin
      Blocked := False;
      for I := 0 to Report.Count - 1 do
        if Pos('blocked:', Report[I]) = 1 then
          Blocked := True;
      // Lascia l'originale intatto; con lui viaggia solo il report
      Report.SaveToFile(IncludeTrailingPathDelimiter(ReviewDir) +
        ChangeFileExt(ExtractFileName(InName), '.pdfa-report.txt'));
      if Blocked then
        Writeln(InName, ': needs a password or a rebuilt source file');
    end;
  finally
    Report.Free;
    Lib.Free;
  end;
end;
Una riga blocked: di solito significa che la correzione sta fuori dal PDF: una password, un file sorgente diverso, o una nuova esecuzione di ciò che ha prodotto il documento. I problemi di validazione semplici dopo una conversione completa sono più spesso contenuto che porta un significato e non si può semplicemente cancellare, e sono i casi in cui a decidere dev'essere una persona
Leggere il marchio PDF/A che un file porta già
Prima di convertire, controlla ciò che il documento già rivendica su se stesso. I file che arrivano da scanner, suite per ufficio e altri strumenti PDF spesso portano già un marchio PDF/A, e riconvertire un PDF/A-3 valido alla parte 2 costerebbe i suoi allegati per niente
La trappola è che XMP permette di scrivere la stessa proprietà in due modi. Alcuni producer scrivono la parte come elemento figlio, <pdfaid:part>2</pdfaid:part>; altri la scrivono come attributo su rdf:Description, pdfaid:part="2". Entrambi sono XMP ordinari e validi. Un rilevatore che cerca una sola forma decide che i file dell'altra famiglia di producer non portano nessun marchio, e un controllore costruito così finisce per giudicare un file PDF/A-2 valido contro la parte 1 riportandolo come senza marchio e con versione PDF troppo alta, l'esatto contrario della verità. Il validatore in PDF Library for Delphi legge entrambe le forme. Se annusi il marchio da te, fai lo stesso:
function DeclaredPDFAPart(Lib: TPDFlib): string;
const
  ElemTag = '<pdfaid:part>';
  AttrDQ  = 'pdfaid:part="';
  AttrSQ  = 'pdfaid:part=''';
var
  Packet: string;
  P: Integer;
begin
  Result := '';
  Packet := Lib.GetDocumentMetadata;
  P := Pos(ElemTag, Packet);                   // forma elemento
  if P > 0 then
    Exit(Copy(Packet, P + Length(ElemTag), 1));
  P := Pos(AttrDQ, Packet);                    // forma attributo, virgolette doppie
  if P = 0 then
    P := Pos(AttrSQ, Packet);                  // forma attributo, virgolette singole
  if P > 0 then
    Result := Copy(Packet, P + Length(AttrDQ), 1);
end;
Un risultato vuoto significa nessun marchio in nessuna delle due forme. Una cifra ti dice quale parte intendeva il producer, e quel numero è quello da confrontare con la tua destinazione prima di decidere se convertire del tutto
Pulire gli script prima che il file entri nell'archivio
La conversione archivistica e la pulizia per la sicurezza di solito girano insieme, dato che il contenuto che una policy di sicurezza vuole eliminato si sovrappone pesantemente a ciò che PDF/A vieta. SanitizeDocument prende una maschera di bit di flag SANITIZE_* e restituisce quante rimozioni ha applicato. ConvertToPDFA stessa la chiama con SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION come primo passo
Un dettaglio conta per i validatori. Gli script a livello di documento vivono in un albero di nomi /JavaScript sotto il dizionario /Names del catalog, e quando l'ultimo script viene rimosso l'albero ormai vuoto viene rimosso con lui. Un albero vuoto annuncia comunque che il documento ha script, e alcuni controllori reagiscono alla chiave stessa senza contare ciò che sta sotto
Qualunque strumento abbia fatto la pulizia, verifica il file salvato con un caricamento fresco invece di fidarti dello stato in memoria. Riaprirlo costa poco:
var
  Lib, Check: TPDFlib;
begin
  Lib := TPDFlib.Create;
  Check := TPDFlib.Create;
  try
    Lib.LoadFromFile('upload.pdf', '');
    Lib.SanitizeDocument(SANITIZE_JAVASCRIPT or SANITIZE_OPEN_ACTION);
    Lib.SaveToFile('upload-clean.pdf');

    Check.LoadFromFile('upload-clean.pdf', '');
    if Check.GlobalJavaScriptCount > 0 then
      raise Exception.Create('Document-level scripts survived the save');
  finally
    Check.Free;
    Lib.Free;
  end;
end;
Per i passi vicini in una pipeline archivistica, vedi le guide su preflight PDF/A e PDF/UA, redaction vera e rimozione di contenuto, e schemi di estensione XMP PDF/A-3 per Factur-X, che riprende il lato dei metadati una volta che un documento archiviato porta anche dati fattura strutturati
Tutta la conversione, la riparazione dei metadati e la validazione mostrate qui girano dentro il tuo processo Delphi, C++Builder o Lazarus, senza convertitori esterni o validatori da riga di comando nella catena. La pagina prodotto di PDF Library for Delphi elenca le parti PDF/A, le edizioni e le piattaforme di destinazione