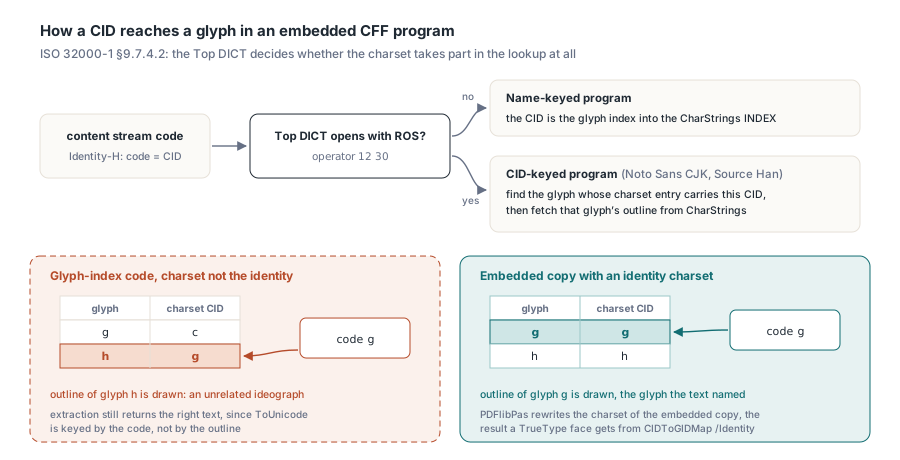
Una fattura cinese composta in Noto Sans SC dal suo file .otf può aprirsi in mutool con ideogrammi senza nessun rapporto al posto del nome del cliente, mentre una face TrueType rende correttamente la stessa pagina. La causa è il charset CFF del font: PDFlibPas lo riscrive in identity nella copia incorporata, così i codici glyph-index arrivano al glyph giusto
Se un font mostra il problema dipende da come è stato costruito. Un programma TrueType incorporato come font CIDFontType2 riceve una CIDToGIDMap di tipo Identity, e il codice nel content stream finisce sul glyph previsto. La maggior parte dei font OpenType latini con outline CFF è name-keyed, e un programma CFF name-keyed usa il CID in arrivo direttamente come indice di glyph. ISO 32000-1 lo nota esplicitamente, in §9.7.4.2: in molti font CID e GID coincidono. Ma non in tutti. Le grandi famiglie CJK costruite come font CID-keyed — Noto Sans CJK e i suoi fratelli Source Han in testa — portano una numerazione CID propria, e un writer che manda gli indici di glyph dritti in quella numerazione si prende qualunque glyph possieda il CID corrispondente
Cosa fa un programma CFF CID-keyed di un CID
ISO 32000-1 §9.7.4.2 divide i programmi CFF incorporati in due casi guardando il Top DICT. Se il Top DICT usa gli operatori CIDFont — in pratica, si apre con ROS (operatore 12 30: registry, ordering, supplement) — il reader prende il CID dal content stream, trova il glyph la cui voce di charset porta quel CID e solo allora recupera l'outline dal CharStrings INDEX. Senza operatori CIDFont, il CID è l'indice di glyph e il charset non c'entra nulla. Qualunque reader che segua §9.7.4.2 alla lettera disegnerà il glyph sbagliato per un codice glyph-index ogni volta che il charset non è identity, con qualunque viewer vi capiti di passare. Il charset in sé, definito in Adobe Technical Note #5176, arriva in tre layout con due casi speciali:
- Il formato 0 memorizza un SID o CID da 2 byte per glyph, in ordine di glyph
- Il formato 1 memorizza range: un primo CID seguito da un conteggio di 1 byte dei glyph che lo seguono con CID consecutivi
- Il formato 2 è lo stesso layout a range con un conteggio di 2 byte, adatto ai font con lunghe sequenze ininterrotte
- Il glyph 0 è
.notdefe non ha voce in nessun formato; un offset di charset di 0, 1 o 2 nomina uno dei charset predefiniti invece di puntare a dati
Iniziate col capire che tipo di font avete davanti. Identity-H lato PDF dice solo che un codice di 2 byte eguaglia il CID. Come quel CID arriva a un glyph vive interamente dentro il font program. La funzione qui sotto legge la tabella CFF da un .otf, percorre il Top DICT in cerca di ROS e controlla se il charset mappa ogni glyph verso un CID con lo stesso numero. Vi serve solo la RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // un file troncato solleva ERangeError invece di leggere male
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Restituisce la fine dell'INDEX alla posizione Pos e delimita il suo primo oggetto
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // gli offset da qui in poi partono da 1
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // Name INDEX
  SkipIndex(P, Dict, DictEnd);                           // Top DICT INDEX
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // numero reale
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // byte riservato
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef non ha voce
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Un report con CIDKeyed = True e IdentityCharset = False descrive esattamente il font di cui parla questo articolo: qualunque writer che metta indici di glyph nel content stream senza tener conto di quel charset disegnerà glyph sbagliati. Un risultato name-keyed, o un font CID-keyed il cui charset si rivela già identity, rende correttamente con lo stesso writer. Ecco perché una face CJK di un prodotto funziona e la successiva no. Il ciclo confronta solo il primo CID di ogni range, e basta: un range copre glyph consecutivi con CID consecutivi, quindi un range che parte sul proprio indice di glyph ci resta fino alla fine
Gli indici di glyph attraversano l'intero dizionario del font
Un writer PDF raramente ha dei CID in mano. Sia la tabella cmap che lo shaping engine restituiscono indici di glyph, quindi la scelta naturale è scrivere quegli indici come codici Identity-H da 2 byte e costruire tutto il resto su quelli: l'array di larghezze /W, la bitmap /CIDSet che il PDF/A richiede e la CMap ToUnicode che permette all'estrazione di recuperare il testo sorgente. Il TrueType ha una via di fuga: la Tabella 117 offre CIDToGIDMap, ma solo per i CIDFont di Tipo 2; un programma CFF vive in un font CIDFontType0, che non ha alcun modo di redirigere un CID dal lato PDF. Questo esclude anche un trucco che alcuni writer usano col TrueType — dare a un glyph riusato un secondo CID "alias" oltre la fine del font, così ToUnicode può attaccare testo diverso a ogni uso. In un font CFF quell'alias non seleziona alcun glyph, e mutool segnala che non riesce a renderizzarlo. Il caso tipico sono i font che mappano U+4E00 e U+2F00 (KANGXI RADICAL ONE) sullo stesso outline. Se il vostro documento ha bisogno che i due si estraggano diversamente, avvolgete l'occorrenza in uno span di marked-content con /ActualText (ISO 32000-1 §14.9.4), che il reader usa al posto della mappatura del font
Riscrivere il charset in place
Ci sono due strade per far convivere codici glyph-index e un programma CID-keyed. Una traduce ogni indice di glyph nel CID del font prima di scriverlo, il che tocca i codici del content stream, le chiavi di /W, le posizioni dei bit in /CIDSet, i codici sorgente in ToUnicode e ogni subset salvato. L'altra modifica l'unica struttura in disaccordo, il charset, così il font risponde agli indici di glyph come farebbe un programma name-keyed. La seconda strada è quella più sicura: lo shaper, la tabella delle larghezze, il subsetter e il costruttore del ToUnicode continuano a lavorare in glyph space, e l'unico codice che deve capire i CID è una breve routine che gira una volta sola sulla copia incorporata del font. PDFlibPas prende questa strada
La riscrittura conserva il formato del charset e la sua lunghezza in byte. Nel formato 0 ogni voce viene sovrascritta col proprio indice di glyph. Nei formati 1 e 2 cambia solo il primo CID di ogni range, e i conteggi restano com'erano. Nulla cresce né si restringe. Gli offset del Top DICT verso CharStrings, i Private DICT, FDArray e FDSelect restano validi senza ricodificare nulla, e FDSelect — che assegna i dizionari di hinting per indice di glyph — lascia ogni glyph nel suo FD originale. Programmi name-keyed, charset predefiniti, tabelle CFF2 (che non hanno charset) e programmi che non fanno il parse vengono lasciati in pace. Tre percorsi di codice eseguono la riscrittura:
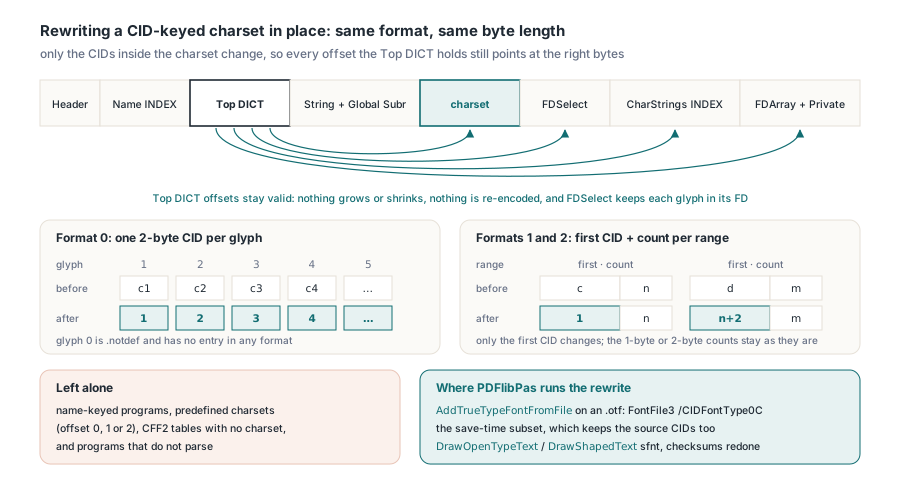
AddTrueTypeFontFromFilesu un.otfincorpora la tabellaCFFnuda comeFontFile3con subtypeCIDFontType0C, col charset già riscritto- Il subset salvato al momento del save conserva gli indici di glyph originali ma anche i CID sorgente, quindi il suo charset viene riscritto una seconda volta
- Il companion di shaping dietro
DrawOpenTypeTexteDrawShapedTextconserva l'intero sfnt; dopo la riscrittura il checksum della tabellaCFFviene ricalcolato, e ilcheckSumAdjustmentdella tabellaheaddiventa0xB1B0AFBAmeno la somma del file - Quell'aggiustamento è definito solo per un font singolo, quindi una face presa da una collection si prende solo il checksum di tabella
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Un .otf di stampo CFF viene incorporato come FontFile3 /CIDFontType0C;
    // la copia incorporata riceve un charset identity quando è CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Verificate l'output renderizzandolo: l'estrazione non mostrerà il problema. pdftotext e tutti gli altri estrattori leggono il ToUnicode, che è indicizzato dal codice nel content stream e non sa nulla di quale outline il font scelga per esso, quindi una pagina che mostra ideogrammi sbagliati estrae comunque la stringa giusta. mutool draw -r 150 -o page%d.png noto-sc.pdf mostra com'è fatta davvero la pagina, e per questo percorso DrawText il pdffonts noto-sc.pdf di poppler dovrebbe elencare il font come CID Type 0C. Risultato atteso: entrambe le righe rendono in Noto Sans SC con i glyph che il testo sorgente nomina, e lo stesso output compare in Ghostscript
Quale forma di embedding richiede il PDF 1.6?
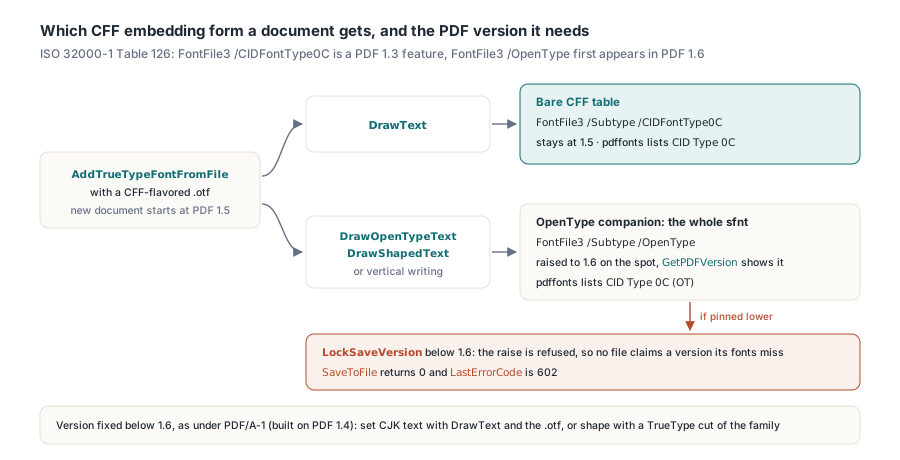
Quella OpenType. La Tabella 126 di ISO 32000-1 elenca uno stream FontFile3 di subtype CIDFontType0C come caratteristica del PDF 1.3, mentre il subtype OpenType — l'intero sfnt con la sua tabella CFF — compare per la prima volta nel PDF 1.6. I nuovi documenti PDFlibPas partono dalla versione 1.5, e lì ci sta il percorso DrawText a CFF nudo. La prima chiamata DrawOpenTypeText, DrawShapedText o di scrittura verticale con una face CFF crea un companion OpenType e alza il documento a 1.6 sul posto, cosa che GetPDFVersion riferisce subito. Un lock di versione cambia le carte in tavola: se LockSaveVersion ha fissato il documento a una versione più bassa, l'alzata viene rifiutata e SaveToFile restituisce 0 con LastErrorCode 602, così nessun file dichiara una versione che i suoi font non rispettano. Quando un profilo di consegna fissa la versione sotto 1.6 — il PDF/A-1 è il caso comune, visto che si basa sul PDF 1.4 — impostate il testo CJK tramite DrawText con il .otf, oppure usate un taglio TrueType della famiglia per tutto ciò che ha bisogno di shaping
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Atteso: 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Atteso: 1.6
    Lib.SaveToFile('shaped.pdf');  // Atteso in pdffonts: CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Atteso: 602
  finally
    Lib.Free;
  end;
end;
Larghezze e ToUnicode indicizzati dagli stessi numeri
Quando il charset è identity, CID, indice di glyph e codice nel content stream sono un numero solo, e le larghezze lo seguono. ISO 32000-1 §9.7.4.3 indicizza /W per CID, a gruppi di un CID iniziale seguito da un array di larghezze oppure di un primo CID, ultimo CID e una larghezza condivisa, senza l'offset /FirstChar tipico dei simple font. Qualunque CID l'array lasci fuori prende /DW, e la Tabella 117 fissa il default di /DW a 1000. Zero è sbagliato: un reader che ricade su 0 per i CID non elencati collassa una riga di ideogrammi su se stessa. Per un .otf caricato tramite AddTrueTypeFontFromFile, PDFlibPas scrive un array /W che parte dal CID 0 ed elenca l'advance di ogni glyph, accanto a un esplicito /DW 1000. Sul lato lettura, il testo CJK che si estrae come caratteri senza senso di solito sbaglia nella metà codespace della stessa pipeline, e un audit dei font PDF/UA su larghezze, CharSet e CIDSet mette questi array a confronto col programma incorporato
ToUnicode ha una regola di numerazione tutta sua. Una voce bfrange memorizza solo la prima stringa di destinazione, e il §9.10.3 richiede che l'ultimo byte non venga spinto oltre 255 dalla lunghezza del range, perché un reader genera le destinazioni successive incrementando solo quell'ultimo byte. Glyph consecutivi mappati su U+4EFE, U+4EFF, U+4F00 e U+4F01 sembrano un range unico, e non lo sono: un reader decodificherebbe il terzo come U+4E00. Il writer di PDFlibPas fonde coppie glyph-to-Unicode vicine in un solo bfrange solo quando sia i codici sorgente che le destinazioni restano dentro un blocco di 256, e spezza la sequenza altrimenti. La composizione CJK verticale passa dagli stessi companion font, quindi il testo giapponese e cinese verticale eredita il charset identity e questi range ToUnicode senza chiamate extra
Ogni face che InspectOtfCharset riferisce come CID-keyed con charset non identity è un caso in cui codici glyph-index e font sono in disaccordo. Incorporata tramite PDFlibPas per Delphi, una face così conserva i propri outline, offset e lunghezza del charset, e ciò che cambia sono i CID in quell'unica tabella, più i checksum quando l'intero sfnt viene conservato