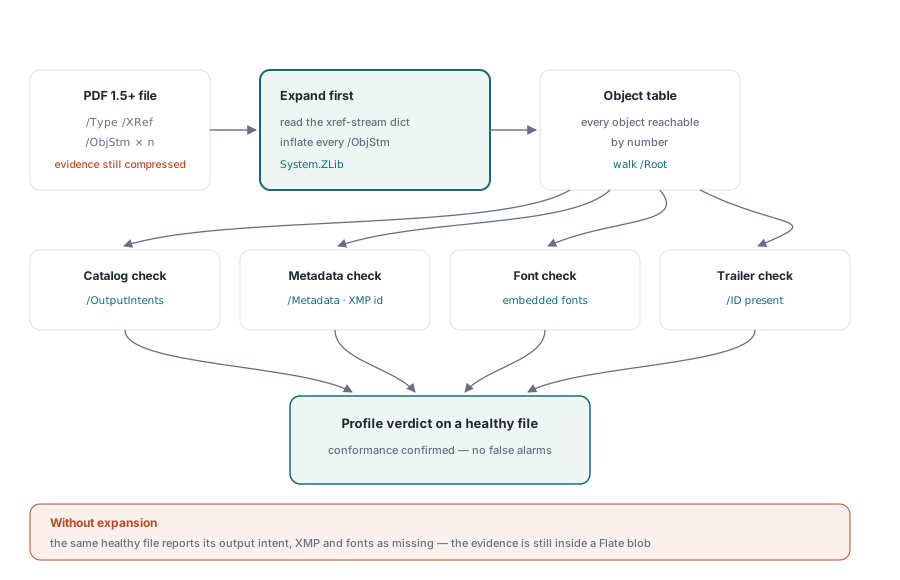
Anda menulis sebuah validator kecil. Ia membuka sebuah PDF, mencari ke bagian akhir, menemukan startxref, membaca offset-nya, dan mengharapkan untuk mendarat pada kata kunci xref dengan sebuah tabel referensi silang berlebar tetap di bawahnya. Dari tabel tersebut ia mengumpulkan offset objek, lalu memindai mundur mencari kata kunci trailer untuk mempelajari /Root dan /Size. Ini bekerja dengan sempurna pada setiap file yang Anda hasilkan untuk mengujinya. Kemudian sebuah file yang dihasilkan oleh versi terkini Word, atau oleh sebuah pustaka yang menargetkan PDF 1.5, tiba, dan validator tersebut menyatakannya rusak. Tidak ada kata kunci xref di tempat offset tersebut menunjuk, tidak ada dictionary trailer di mana pun, dan tabel objek yang dibangun validator tersebut hampir kosong. File tersebut valid. Validator tersebut membacanya melalui kacamata berumur lima belas tahun
Inilah alasan tunggal paling umum mengapa sebuah pemeriksaan PDF tingkat byte yang ditulis berdasarkan tata letak klasik gagal pada dokumen modern. Struktur yang menjadi sandarannya, tabel referensi silang plaintext dan kata kunci trailer, dijadikan opsional di PDF 1.5 dan sering kali tidak ada. Dua fitur menggantikannya: cross-reference stream dan compressed object stream. Keduanya dijelaskan dalam ISO 32000-1, dan sebuah validator yang tidak mengetahui keduanya melihat sebuah file yang sehat sebagai tumpukan objek yang hilang
Apa yang diubah PDF 1.5 pada bagian akhir file
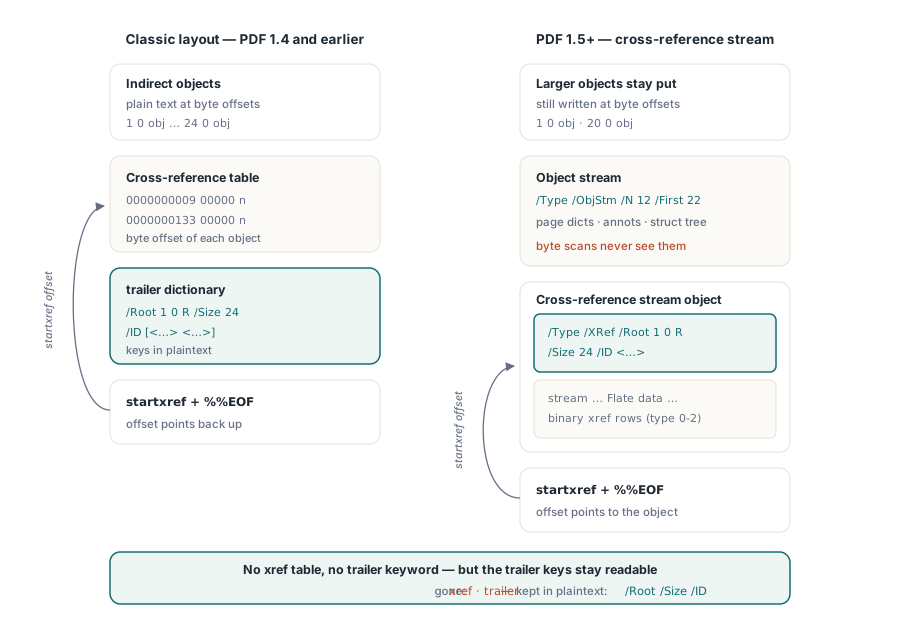
ISO 32000-1 §7.5.8 mendefinisikan cross-reference stream, dan §7.5.7 mendefinisikan object stream bertipe /ObjStm. Bersama-sama keduanya memungkinkan sebuah writer melepaskan dua struktur yang menjadi kunci bagi sebuah parser klasik. Sebuah file PDF 1.5 mungkin berakhir tanpa tabel xref sama sekali. Sebagai gantinya, objek yang ditunjuk oleh startxref adalah sebuah objek stream biasa yang dictionary-nya membawa /Type /XRef, dan stream tersebut menyimpan data referensi silang dalam bentuk biner yang kompak. Tidak ada kata kunci trailer juga, karena trailer tersebut sekarang adalah dictionary milik stream itu sendiri. Kunci-kunci yang diburu oleh parser klasik, /Root, /Size dan /ID, hidup di dalam dictionary tersebut
Perubahan kedua memindahkan objek-objek itu sendiri. Alih-alih menulis setiap objek tidak langsung pada offset byte-nya sendiri, sebuah writer dapat mengemas banyak objek kecil, dictionary halaman, dictionary anotasi, structure tree, ke dalam satu object stream tunggal dan mengompresi seluruh wadah tersebut dengan Flate. Objek-objek individual tersebut tidak lagi memiliki offset byte dalam file. Mereka memiliki sebuah posisi di dalam sebuah blob terkompresi. Sebuah validator yang memindai byte mentah mencari 1 0 obj tidak akan pernah menemukannya, karena teks tersebut hanya ada setelah inflasi (dekompresi). Bagi sebuah parser klasik, setengah dokumen tersebut begitu saja lenyap
Kunci trailer bersifat plaintext, bahkan dalam file terkompresi
Bagian yang melegakan adalah membaca trailer dari sebuah cross-reference stream tidak membutuhkan inflasi apa pun. Sebuah objek stream ditulis sebagai sebuah dictionary yang diikuti oleh kata kunci stream dan kemudian byte-byte terkompresi. Dictionary tersebut bersifat plaintext. Jadi ketika startxref menunjuk ke sebuah cross-reference stream, byte-byte tepat setelah nomor objek terlihat seperti sebuah dictionary biasa, dan /Root, /Size dan /ID duduk di sana dalam keadaan jelas, sebelum kata kunci stream dan data Flate dimulai
Itu berarti sebuah validator dapat mempelajari tiga fakta yang paling dibutuhkannya, di mana katalog tersebut berada, berapa banyak objek yang diklaim file tersebut, dan identifier file tersebut, hanya dengan mengurai dictionary stream tersebut. Ia tidak perlu mendekompresi data referensi silang tersebut, dan ia tidak perlu menafsirkan entri biner di dalamnya. Pekerjaan yang mengalahkan sebuah parser naif bukanlah membaca trailer; itu adalah menemukan objek-objek tersebut. Keduanya adalah dua masalah yang dapat dipisahkan, dan menyelesaikan yang pertama itu murah
Object stream: sebuah header, lalu sebuah blob Flate
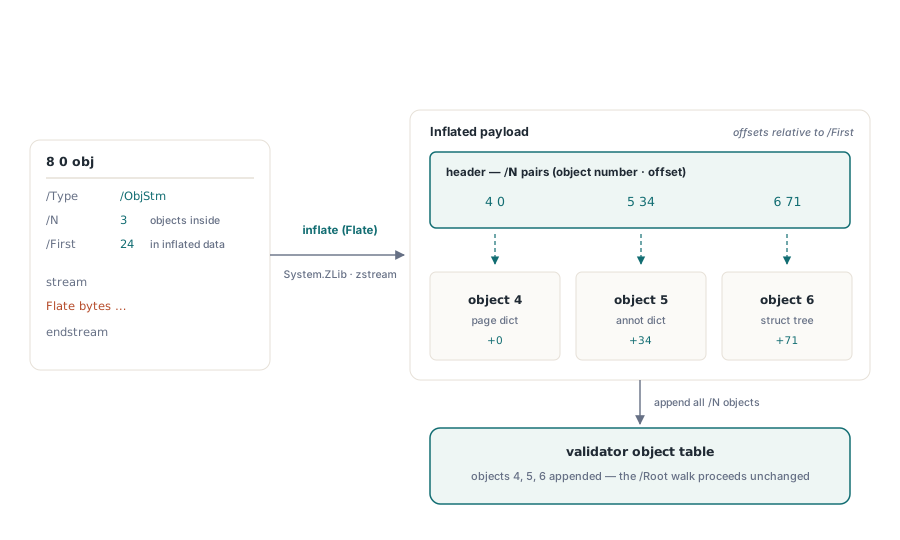
Sebuah object stream adalah sebuah wadah. Dictionary-nya membawa /Type /ObjStm, sebuah entri /N yang memberikan jumlah objek yang dikemas di dalamnya, dan sebuah entri /First yang memberikan offset byte, di dalam data yang telah diinflasi, tempat isi objek pertama dimulai. Payload terkompresi tersebut, begitu diinflasi, dimulai dengan sebuah header kecil berisi /N pasangan integer. Setiap pasangan adalah sebuah nomor objek dan offset isi objek tersebut relatif terhadap /First. Setelah header tersebut datang isi objek itu sendiri, digabungkan menjadi satu
Mengekspansi salah satunya bersifat mekanis begitu byte-byte tersebut diinflasi. Anda membaca dictionary tersebut untuk mendapatkan /N dan /First, menginflasi stream tersebut dengan sebuah decoder Flate, menyusuri pasangan /N di depan untuk mempelajari nomor objek mana yang berada pada offset mana, dan kemudian mengangkat setiap isi keluar seolah-olah itu adalah objek tidak langsung biasa. Satu-satunya dependensi sungguhan adalah decoder Flate tersebut, dan Anda sudah memilikinya: Delphi mengirimkan System.ZLib, dan Free Pascal mengirimkan unit zstream, keduanya membungkus zlib dan menginflasi sebuah raw Flate stream tanpa kode pihak ketiga apa pun. Sebuah rutin yang menambahkan setiap objek yang diekstraksi ke tabel objek validator tersebut membuat sisa validator itu, bagian yang menyusuri /Root dan memeriksa page tree, berperilaku persis seperti pada file klasik
Apa yang tidak perlu Anda implementasikan
Sangat mudah untuk melebih-lebihkan pekerjaan tersebut. Membaca kunci-kunci trailer dari sebuah file terkompresi tidak membutuhkan pendekodean entri biner cross-reference stream tersebut. Cross-reference stream §7.5.8 menggunakan tiga tipe entri, dan entri tipe 2, yaitu yang mengatakan objek ini hidup di dalam object stream N pada indeks i
, adalah yang akan Anda dekode untuk membangun sebuah peta offset lengkap. Anda membutuhkan peta tersebut untuk menyelesaikan objek sembarang berdasarkan nomornya. Anda tidak membutuhkannya untuk membaca /Root, /Size dan /ID, yang berada dalam dictionary plaintext, dan Anda tidak membutuhkannya untuk mengekspansi object stream, karena setiap /ObjStm mengumumkan isinya sendiri melalui /N dan /First
Anda juga tidak perlu menangani fungsi predictor PNG dan TIFF yang mungkin diterapkan sebuah cross-reference stream melalui /DecodeParms-nya hanya untuk mendapatkan kunci-kunci trailer. Predictor tersebut menyaring baris-baris referensi silang biner agar terkompresi lebih baik; mereka tidak ada hubungannya dengan dictionary yang mendahului stream tersebut. Peningkatan minimal yang membuat sebuah validator klasik menyadari PDF modern karena itu kecil: ketika startxref mendarat pada sebuah stream alih-alih kata kunci xref, urai dictionary stream tersebut untuk mencari kunci-kunci trailer, dan ekspansi setiap objek /ObjStm yang Anda temui sehingga isinya masuk ke tabel objek. Mendekode entri tipe 2 dan predictor adalah sebuah tugas terpisah yang lebih besar yang dapat Anda tunda sampai Anda benar-benar membutuhkan resolusi objek acak
Mengapa sebuah pemeriksaan kepatuhan harus mengekspansi stream terlebih dahulu
Ini berhenti menjadi hal akademis pada saat Anda menjalankan sebuah pemeriksaan profil. Sebuah validator PDF/A atau PDF/X memeriksa objek-objek tertentu: katalog dokumen untuk sebuah array /OutputIntents, stream /Metadata untuk sebuah paket XMP dengan identifier yang tepat, setiap font descriptor untuk sebuah file font yang tertanam, trailer untuk sebuah /ID. Dalam sebuah file terkompresi, sebagian besar objek-objek tersebut berada di dalam object stream. Sebuah validator yang belum mengekspansi object stream tersebut tidak dapat melihat kunci-kunci katalog tersebut, tidak dapat menemukan metadata, dan tidak dapat mendaftar font-font tersebut. Ia akan melaporkan sebuah dokumen yang sepenuhnya patuh sebagai kehilangan output intent-nya, kehilangan XMP-nya, dan kehilangan setengah strukturnya, karena bukti yang dibutuhkannya masih duduk di dalam sebuah blob Flate yang tidak pernah diinflasinya
Urutan itu penting. Ekspansi harus terjadi sebelum pemeriksaan berjalan, bukan bersamaan dengannya, karena setiap pemeriksaan mengasumsikan ia dapat mencapai sebuah objek berdasarkan nomornya. Jika Anda menghubungkan sebuah pemeriksaan profil langsung ke sebuah pemindaian byte mentah, ia mewarisi kebutaan parser klasik tersebut dan menghasilkan pelanggaran palsu tepat pada file-file modern yang paling mungkin terbentuk dengan baik, karena mereka berasal dari toolchain yang cukup baru untuk menulis cross-reference stream sejak awal
Membiarkan PDFium melakukan penguraian untuk Anda
PDFium Component mengurai cross-reference stream dan object stream sebagai bagian dari pemuatan sebuah dokumen, yang merupakan cara praktis untuk menghindari membuat sendiri langkah inflate-dan-ekspansi tersebut. Ketika Anda memuat sebuah file dengan komponen TPdf, objek-objek yang dikemas ke dalam wadah /ObjStm sudah diselesaikan, dan titik-titik masuk validasi melihat dokumen yang telah terekspansi sepenuhnya. ValidatePdfA mengembalikan sebuah record TPdfAValidationResult yang field Conformance-nya adalah sebuah nilai TPdfAConformance seperti pac1b atau pacNone, yang field Issues-nya adalah sebuah set masalah tertentu yang ditemukan, dan yang metode IsCompliant-nya benar hanya ketika sebuah tingkat kesesuaian terdeteksi dan set masalah tersebut kosong. Karena objek-objek tersebut telah diekspansi selama pemuatan, sebuah array /OutputIntents atau sebuah font tertanam yang berada di dalam sebuah object stream ditemukan, tidak dilaporkan hilang
uses
  PDFium, FPdfPdfa;

function CheckPdfA(const FileName: string): TPdfAValidationResult;
var
  Pdf: TPdf;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := FileName;
    Pdf.Active := True;            // mengurai xref/object stream saat pemuatan
    Result := Pdf.ValidatePdfA;    // melihat tabel objek yang telah terekspansi
  finally
    Pdf.Free;
  end;
end;
Hal yang sama berlaku untuk ValidatePdfX, yang mengembalikan sebuah TPdfXValidationResult dengan bentuk yang sama. Inti dari merutekan melalui PDFium adalah bahwa dekompresi struktural yang dijelaskan di atas terjadi satu kali, dengan benar, di dalam loader tersebut, sehingga kode validasi Anda tidak pernah melihat perbedaan antara sebuah file klasik dan sebuah file yang sepenuhnya terkompresi. Keduanya tiba di validator sebagai sebuah set objek yang telah diselesaikan
function PdfXConformanceName(C: TPdfXConformance): string;
begin
  case C of
    pxc1a: Result := 'PDF/X-1a';
    pxc3 : Result := 'PDF/X-3';
    pxc4 : Result := 'PDF/X-4';
  else
    Result := 'none';
  end;
end;

var
  Pdf: TPdf;
  R  : TPdfXValidationResult;
  Issue: TPdfXValidationIssue;
  IssueCount: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'Press_Ready.pdf';
    Pdf.Active := True;
    R := Pdf.ValidatePdfX;
    if R.IsCompliant then
      Writeln('PDF/X conformance: ', PdfXConformanceName(R.Conformance))
    else
    begin
      IssueCount := 0;
      for Issue in R.Issues do   // Issues adalah sebuah set: hitung anggotanya
        Inc(IssueCount);
      Writeln('Not conformant; issue count = ', IssueCount);
    end;
  finally
    Pdf.Free;
  end;
end;
Jika byte-byte tersebut sudah berada di memori alih-alih di disk, urutan muat-lalu-validasi yang sama bekerja melalui overload LoadDocument(const Data: TBytes), yang menerima konten file mentah dan mengurai cross-reference dan object stream-nya dengan cara yang sama seperti jalur file. Pelajaran yang dapat diambil untuk sebuah validator buatan tangan adalah aturan strukturalnya, bukan API-nya: baca kunci-kunci trailer dari dictionary stream tersebut dalam bentuk plaintext, ekspansi setiap /ObjStm dengan sebuah decoder Flate sebelum Anda menyusuri dokumen tersebut, dan perlakukan pendekodean entri biner cross-reference tersebut sebagai tugas opsional yang lebih besar sebagaimana adanya
Begitu struktur tersebut terekspansi, sebuah validator dapat menjalankan sisa sebuah alur kerja di atasnya. Untuk sebuah harness preflight command-line yang melaporkan kesesuaian di seluruh sebuah folder input, lihat panduan kami tentang membangun sebuah CLI laporan preflight batch. Ketika validasi adalah sebuah gerbang sebelum memecah sebuah dokumen besar, teknik-teknik dalam panduan kami untuk memecah dokumen PDF menjadi beberapa file berpasangan secara alami dengan pola muat-dan-periksa yang ditunjukkan di sini. Keduanya dibangun di atas permukaan pemuatan dan validasi PDFium Component untuk Delphi dan C++Builder