HotPDF Delphi Component dapat mencari dan mengganti teks di dalam PDF yang sudah ada dari Delphi dan C++Builder. SearchLoadedPageText dan SearchLoadedDocumentText menemukan setiap kemunculan sebuah string dengan presisi tingkat glyph, dan ReplaceLoadedPageText serta ReplaceLoadedDocumentText menulis ulang byte yang cocok di tempatnya — asalkan setiap karakter pengganti dapat di-encode ulang lewat font aslinya, sebuah kendala fisik yang artikel ini perlakukan dengan jujur alih-alih disembunyikan di catatan kaki
Permintaan di balik fitur ini selalu biasa saja. Sebuah perusahaan berganti nama dan tiga ribu faktur arsip masih membawa nama lamanya. Sebuah templat kontrak terkirim dengan tanggal kedaluwarsa tahun lalu. Sebuah kode produk dipensiunkan dan tiap lembar data yang menyebutnya perlu memakai kode penerusnya. Di pengolah kata, masing-masing pekerjaan ini selesai dalam tiga puluh detik. Di PDF, ini masalah yang sungguh-sungguh sulit, dan memahami sebabnya adalah pembeda antara memakai API-nya dengan baik dan mengajukan laporan bug yang sebenarnya adalah kutipan spesifikasi
Mengapa mengganti teks di dalam PDF begitu sulit?
Mengganti teks di dalam PDF itu sulit karena halaman PDF tidak memuat teks yang dapat disunting — ia memuat glyph yang sudah ditempatkan. Di bawah model penampilan teks pada ISO 32000-1 §9.4, sebuah content stream menjalankan operator seperti Tj dan TJ yang melukis rangkaian kode karakter pada koordinat yang ditetapkan oleh matriks teks. Kode-kode itu bukan Unicode; semuanya adalah indeks ke dalam encoding apa pun yang dideklarasikan font halaman itu, dan pemetaan baliknya menjadi karakter yang terbaca bisa berada di sebuah CMap /ToUnicode, sebuah array perbedaan encoding, atau sebuah rantai pemetaan CID. Tidak ada objek paragraf, tidak ada aliran teks, dan tidak ada jaminan bahwa satu kata yang terlihat utuh benar-benar tersimpan sebagai satu string
Penggantian menambahkan lapisan kesulitan kedua di atas pendekodean: Anda harus tahu persis byte mana dari stream aslinya yang menghasilkan tiap glyph, agar dapat menyisipkan byte baru tepat pada rentang itu dan tidak ke tempat lain. Sebuah pengekstrak teks boleh saja membuang posisi byte-nya begitu Unicode-nya keluar. Sebuah pengganti tidak boleh. Itulah sebabnya HotPDF membagi pekerjaannya ke dua rilis — v2.251.0 membangun lapisan pelacakan offset dan pencarian, dan v2.252.0 membangun lapisan penulisan ulang di atasnya
Menemukan teks: pencarian tingkat glyph dengan pelacakan offset byte
SearchLoadedDocumentText milik HotPDF menemukan setiap kemunculan sebuah kata kunci dengan mencocokkannya terhadap rangkaian glyph Unicode hasil dekode tiap halaman, bukan terhadap byte stream mentah, sehingga sebuah hit tetap hit terlepas dari cara font meng-encode-nya. Infrastruktur di bawahnya diperkenalkan di v2.251.0: tokenizer content stream mencatat rentang byte StartOfs/EndOfs untuk tiap operand string — termasuk pembatas ( ) atau < >-nya — dan tiap glyph hasil dekode membawa triplet TokenIndex/ItemIndex/ByteOffset yang menunjuk balik ke operand, item array TJ, dan unit kode yang persis menghasilkannya. Penafsir glyph yang sama menggerakkan API ekstraksi yang dijelaskan di mengekstrak teks dari PDF yang dimuat di Delphi; pencarian sekadar menyimpan provenance yang dibuang oleh ekstraksi
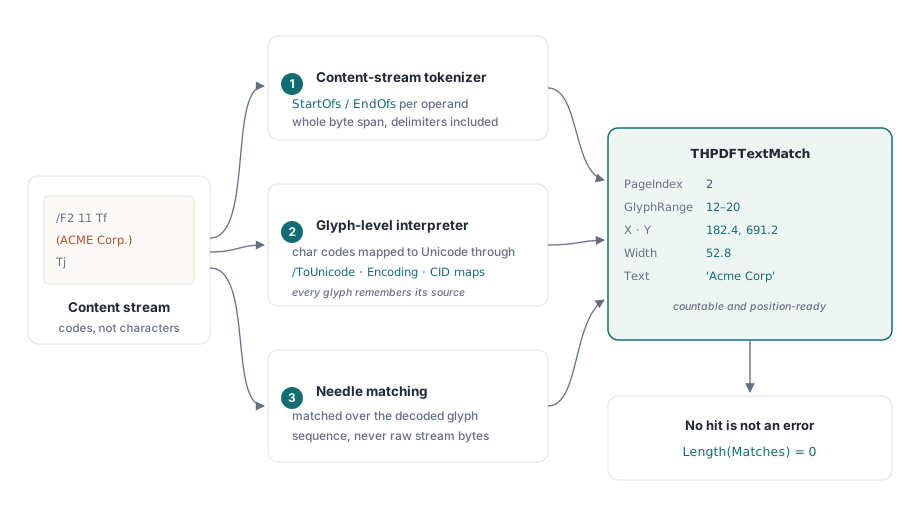
Tiap kecocokan kembali sebagai rekaman THPDFTextMatch yang membawa indeks halaman, rentang glyph inklusif, titik asal X/Y ruang pengguna beserta lebar hit-nya, indeks token dan item sumbernya, serta teks yang cocok itu sendiri. Itu sudah cukup untuk menggerakkan overlay penyorotan, UI peninjauan, atau langkah penggantian. Pencarian yang tidak menemukan apa pun mengembalikan array kosong alih-alih gagal, sehingga pola pemanggilannya tetap sederhana
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
Satu pilihan desain yang disengaja layak dicatat. Ketika CaseSensitive bernilai False, perbandingannya melipat huruf besar-kecil hanya untuk karakter ASCII, dan itu memang disengaja: pelipatan huruf Unicode penuh berperilaku berbeda-beda di antara toolchain Delphi 5 sampai XE yang didukung HotPDF, dan API pencarian yang menemukan kecocokan berlainan tergantung kompiler mana yang membangun aplikasi Anda lebih buruk daripada API dengan batas yang terdokumentasi dan dapat diperkirakan. Untuk teks bisnis beraksara Latin — nama, kode, tanggal — pelipatan ASCII sudah mencakup kasus praktisnya
Mengganti teks: encoding terbalik dan penyisipan yang presisi
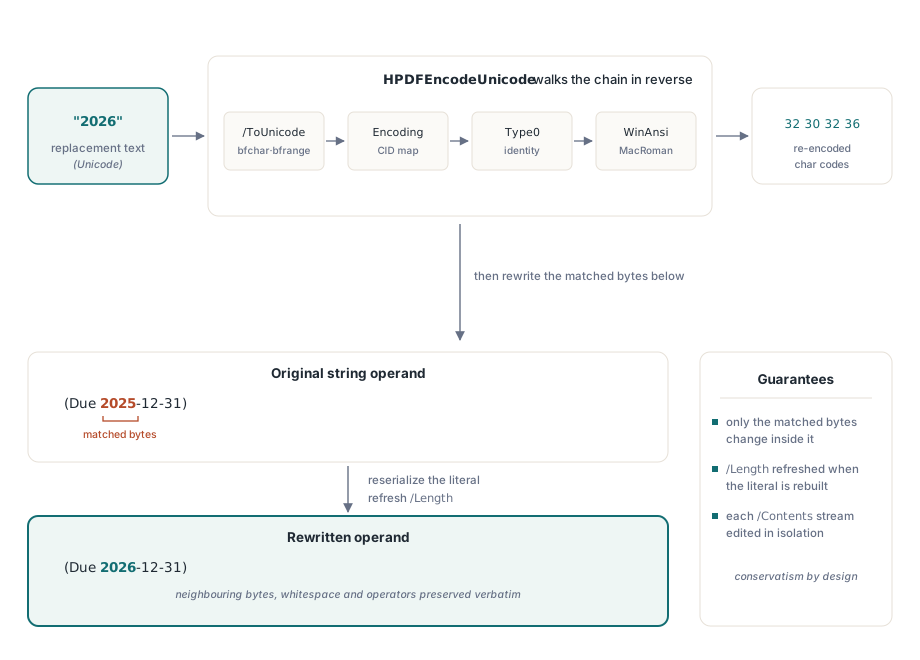
ReplaceLoadedDocumentText, yang ditambahkan di HotPDF v2.252.0, menulis ulang setiap kemunculan sebuah kata kunci dengan menjalankan mesin pendekodean itu secara terbalik. Fungsi HPDFEncodeUnicode adalah kebalikan dari pendekode kode karakter: ia menelusuri rantai strategi yang sama dalam arah sebaliknya — pencarian bfchar dan bfrange /ToUnicode, pemetaan CID stream encoding, pemetaan identitas Type0, serta tabel WinAnsi dan MacRoman yang telah ditetapkan — untuk mengubah tiap karakter pengganti kembali menjadi byte kode karakter yang diharapkan font aslinya. Byte hasil encode ulang itu lalu diserialisasi menjadi literal string atau string heksadesimal yang berbentuk baik, mencerminkan aturan escape milik tokenizer itu sendiri sehingga perjalanan bolak-balik parse → serialisasi ulang bersifat stabil
Penyisipannya sendiri bersifat bedah alih-alih borongan. Hanya rentang byte kode yang tercakup oleh kecocokan itu yang diganti di dalam operand string-nya; byte yang tidak cocok di operand yang sama, spasi di antara token, dan tiap operator di sekelilingnya dipertahankan apa adanya, byte demi byte. Mengganti bca di dalam abcabc menghasilkan a + pengganti + bc, bukan operand yang rusak. Pengganti boleh lebih pendek atau lebih panjang daripada kata kuncinya — literalnya diserialisasi ulang dan /Length stream-nya disegarkan — dan tiap stream /Contents pada halaman bermultistream diproses secara terpisah agar halamannya tetap berbentuk baik
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Perhatikan apa yang tidak dilakukan API-nya: ia tidak menata ulang halamannya. PDF tidak punya reflow, sehingga pengganti yang secara visual lebih lebar daripada aslinya akan menempati ruang horizontal lebih banyak dan bisa menyesaki apa pun yang dilukis di sebelah kanannya. Substitusi dengan panjang sama atau nyaris sama — tanggal, string versi, nomor komponen, koreksi nama — adalah titik manisnya. Penulisan ulang kalimat secara borongan adalah urusan dokumen sumbernya, bukan PDF-nya
Mengapa teks tidak bisa diganti dengan karakter yang tidak pernah disertakan subset font-nya?
Anda tidak bisa mengganti teks dengan karakter yang tidak pernah disertakan subset font tersematnya, karena rangkaian byte yang akan memilih karakter itu memang tidak ada di tabel pemetaan font-nya. Ketika sebuah produsen PDF menyematkan font subset, CMap /ToUnicode dan struktur encoding-nya hanya mencakup glyph yang benar-benar dipakai dokumen aslinya. HPDFEncodeUnicode hanya bisa membalik pemetaan yang hadir: jika dokumennya tidak pernah memuat huruf E pada font itu, tidak ada kode karakter untuk E yang dapat dibalik. Ini sifat fisik berkasnya, bukan keterbatasan pustaka tertentu — tidak ada perkakas yang bisa memunculkan pemetaan glyph yang tak pernah disematkan
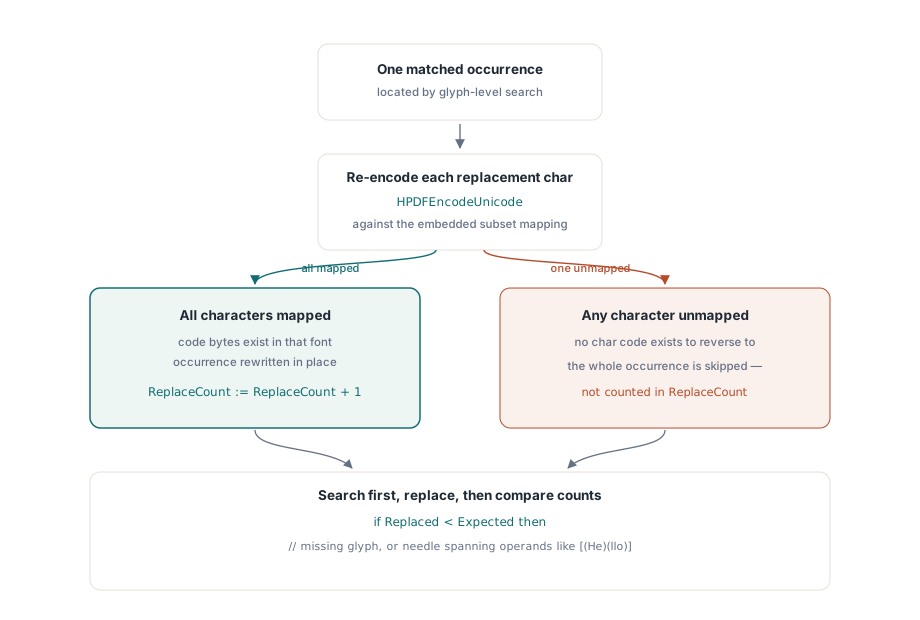
HotPDF menangani kegagalannya secara konservatif. Jika satu saja karakter dari penggantinya tidak dapat di-encode ulang, seluruh kemunculan kata kunci itu dilewati — tanpa exception, tanpa teks sampah separuh jadi, dan kemunculan itu sekadar tidak dihitung di ReplaceCount. Konsekuensi praktisnya: bandingkan ReplaceCount dengan jumlah kecocokan dari pencarian sebelumnya, dan perlakukan selisih kurangnya sebagai sinyal. Pada contoh tanggal di atas, angka 6 harus muncul di suatu tempat dalam teks dokumennya pada font yang sama agar penulisan ulangnya berhasil — mungkin saja ada di sebuah faktur, tak pernah terjamin secara umum. Ketika karakter yang Anda perlukan memang tidak tersedia dan tujuannya adalah menghapus teks sensitif alih-alih menulis ulangnya, penghapusan konten yang sesungguhnya toh merupakan perkakas yang lebih tepat; lihat meredaksi dan menyusun ulang PDF yang dimuat di Delphi untuk jalur itu
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
Kondisi pelewatan kedua pada pesan itu adalah batas terdokumentasi yang lain: kata kunci yang membentang melintasi beberapa operand string — Hello yang terbelah di antara item [(He)(llo)] TJ, misalnya — ditemukan oleh pencarian, karena pencarian mencocokkan rangkaian glyph hasil dekode, tetapi dilewati oleh penggantian, karena menulis ulang lintas batas operand akan menuntut penggabungan rentang byte yang bertetangga. Pola cari-lalu-verifikasi membuat kedua batas itu terlihat alih-alih senyap
Apa yang berubah di dalam berkasnya ketika Anda menyimpan?
Stream /Contents yang telah diganti disimpan tanpa kompresi. Stream terkompresi FlateDecode didekompresi untuk penyuntingan, dan ketika HotPDF menuliskan byte hasil bangunan ulangnya, ia membuang entri /Filter stream itu dan menyegarkan /Length alih-alih mengompresinya kembali. PDF yang dihasilkan sepenuhnya sah dan terrender normal di penampil arus utama; imbalannya adalah berkas yang lebih besar untuk tiap stream yang disunting. Untuk pipeline batch yang memproses ribuan dokumen, anggarkan pertumbuhan itu atau jalankan proses kompresi terpisah di hilir. Bagaimana objek yang ditulis ulang berinteraksi dengan struktur referensi silang dokumennya saat penyimpanan adalah topik tersendiri, dibahas di object stream dan pembaruan inkremental di HotPDF
Segala hal lain tentang berkasnya dibiarkan apa adanya. Stream yang tak tersentuh mempertahankan kompresinya, font dan gambar tidak ditulis ulang, dan penyisipan setingkat operand berarti bahkan stream yang disunting pun berbeda dari aslinya hanya di tempat kecocokannya mendarat. Konservatisme itu disengaja: makin banyak bagian dokumen termuat yang ditulis ulang sebuah pustaka, makin banyak pula peluangnya merusak keanehan produsen yang tidak diantisipasinya
Pencarian dan penggantian teks bergabung dengan ekstraksi, redaksi, dan perenderan halaman di dalam perangkat dokumen-termuat HotPDF, semuanya digerakkan oleh penafsir content stream yang sama dan tersedia dari Delphi 5 sampai rilis RAD Studio saat ini tanpa dependensi eksternal. Referensi API lengkap dan unduhan versi ujicoba ada di halaman produk HotPDF Delphi Component