Menggabungkan PDF terdengar seperti seharusnya murah. Konten halaman sudah tertata, font sudah tertanam, gambar sudah terkompresi. Pada prinsipnya sebuah merge hanyalah soal pembukuan: beri nomor ulang objek agar ruang penomoran dua file berhenti bertabrakan, sambungkan page tree, perbaiki tabel cross-reference, lalu tulis. Dalam praktiknya, sebagian besar kode merge membuang kemurahan itu begitu saja. Untuk setiap objek di setiap file input, kode itu menjalankan parse penuh menjadi object tree yang di-tokenisasi, mengubah beberapa referensi tak langsung, lalu menyerialisasikan tree itu kembali menjadi byte. Parse dan reserialize adalah dua bagian yang mahal, dan untuk sebagian besar objek, keduanya menghasilkan urutan byte yang hampir identik dengan yang masuk
PDF Library for Delphi adalah engine PDF Object Pascal native untuk Delphi dan C++Builder, dan jalur merge cepatnya ada untuk melewati round trip itu di mana pun terbukti aman. Idenya sempit tetapi terbayar di seluruh kumpulan dokumen: untuk objek non-stream yang tidak dimodifikasi, ambil byte sumber asli apa adanya dan lakukan satu kali penulisan ulang tingkat byte atas referensi tak langsung yang dikandungnya, mengubah setiap N G R menjadi (N+Offset) G R. Tanpa tokenizer, tanpa object tree, tanpa serializer. Artikel ini membahas di mana jalan pintas itu sah, state machine parser yang melakukan penulisan ulang byte tanpa merusak apa pun, mengapa penggabungan bookmark memerlukan mekanisme yang sama sekali berbeda, dan bagaimana jalur merge biasa dibangun ulang dari kuadratik menjadi linear pada saat yang sama
Mengapa penomoran ulang objek menjadi biaya sebenarnya dari penggabungan
Setiap PDF membawa ruang penomoran objeknya sendiri. File A punya objek 1, objek 2, dan seterusnya; file B punya objek 1, objek 2 miliknya sendiri, dan seterusnya. Anda tidak bisa memasukkan objek B ke dalam file A tanpa perubahan, karena nomornya akan bertabrakan dan setiap referensi tak langsung di dalam B akan mengarah ke objek yang salah. Perbaikannya adalah sebuah offset: jika A berakhir pada jumlah objek Offset, maka objek B ke-N menjadi objek N+Offset pada output, dan setiap referensi N G R yang muncul di mana pun di dalam objek-objek B harus digeser menjadi (N+Offset) G R agar sesuai
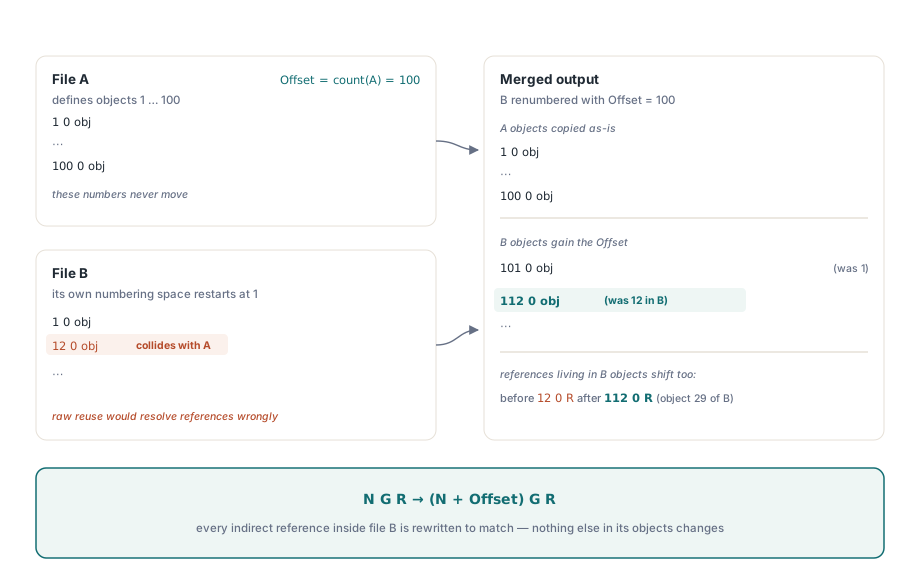
Pergeseran itu adalah seluruh pekerjaan semantik dari penggabungan bagian tubuh dokumen. Perbaikan page tree dan penggabungan AcroForm adalah edit kecil dan terbatas pada segelintir objek. Pekerjaan utamanya adalah menulis ulang referensi di ribuan objek, dan cara naif melakukannya adalah mem-parse setiap objek agar Anda bisa menemukan referensi secara struktural. MergeFileListFast milik PDF Library for Delphi mengambil pandangan sebaliknya: referensi itu juga bisa ditemukan di byte mentah, asalkan Anda berhati-hati terhadap konteks di mana urutan digit-spasi-digit-spasi-R bukan sebuah referensi. Lewati parse, geser di tempat, dan biaya per objek runtuh menjadi satu kali pemindaian linear atas byte yang toh sudah akan Anda salin
Kapan penggunaan ulang byte sumber terbukti aman
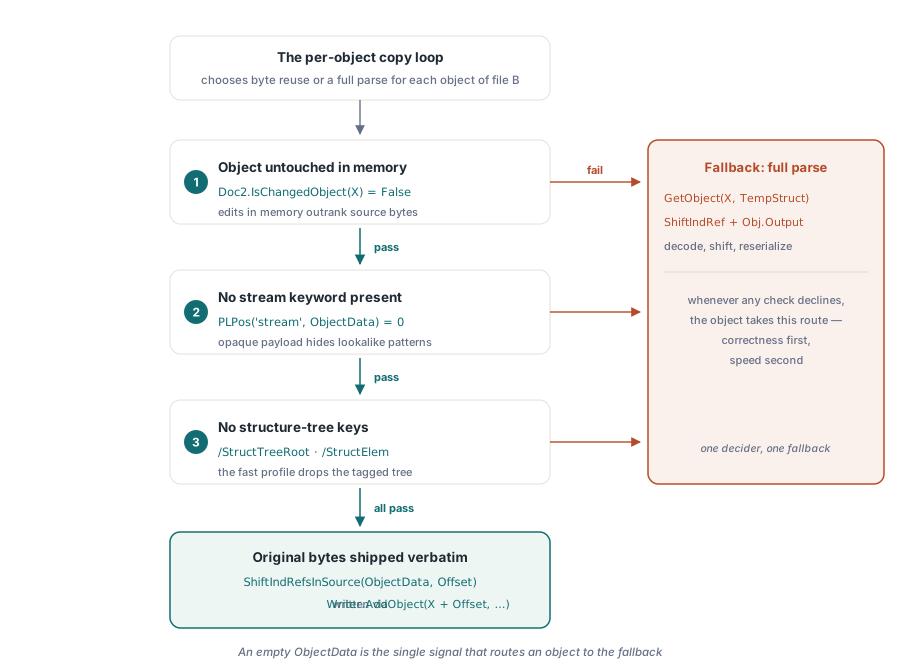
Jalur byte hanya diambil ketika tiga kondisi semuanya terpenuhi untuk objek yang sedang disalin dari dokumen berikutnya. Jika salah satu saja gagal, objek itu dikirim kembali melalui jalur decode-dan-reserialize penuh, sehingga kebenaran selalu menang atas kecepatan:
Doc2.IsChangedObject(X)bernilai False. Jika mesin merge sudah mengubah objek itu di memori (misalnya objek halaman yang/Parent-nya diarahkan ulang), tree di memori adalah sumber kebenaran dan byte asli sudah usang. Hanya objek yang belum tersentuh yang memenuhi syarat- Byte sumber tidak mengandung kata kunci
stream. Isi objek stream adalah biner opak yang dibingkai olehstream/endstream, dan pemindaian referensi naif atas data stream yang terkompresi atau terenkripsi bisa dengan mudah "menemukan" dan merusak pola byte yang terlihat seperti referensi. Objek stream tetap memakai jalur sadar-stream yang asli - Byte sumber tidak mengandung
/StructTreeRootmaupun/StructElem. Pada profil cepat, structure tree tagged-PDF dibuang, bukan digabungkan, sehingga objek-objek itu harus melalui jalur decode di mana engine bisa menghapusnya secara sengaja
Keputusan itu berada di loop penyalinan per objek. Ketika ketiga pemeriksaan lolos, byte objek langsung menuju ShiftIndRefsInSource lalu ke writer; jika tidak, byte itu dibuang dan objek dibangun ulang dengan GetObject, digeser dengan ShiftIndRef, lalu diserialisasikan. Struktur cabang itu layak dilihat, karena urutan pemeriksaan itulah yang membuatnya aman:
ObjectData := '';
if not Doc2.IsChangedObject(X) then
begin
  ObjectData := FastMergeObjectSource(Reader2, X);
  if (PLPos('stream', ObjectData) > 0) or
     ((not PreserveStructTree) and (PLPos('/StructTreeRoot', ObjectData) > 0)) or
     ((not PreserveStructTree) and (PLPos('/StructElem', ObjectData) > 0)) then
    ObjectData := ''                                  // kembali ke jalur decode
  else
    ObjectData := ShiftIndRefsInSource(ObjectData, Offset);
end;

if ObjectData <> '' then
  Writer.AddObject(X + Offset, Doc2.GetGenNum(X), ObjectData)
else
begin
  Obj := Doc2.GetObject(X, TempStruct);              // jalur parse penuh
  // ... hapus objek struct-tree, ShiftIndRef, Obj.Output ...
end;
ObjectData yang kosong adalah sinyal bahwa jalur byte menolak objek tersebut. Sentinel tunggal itu menjaga agar jalur cepat dan lambat tidak saling menjauh: hanya ada satu tempat yang memutuskan, dan satu fallback
State machine pergeseran referensi dan kasus pinggirannya
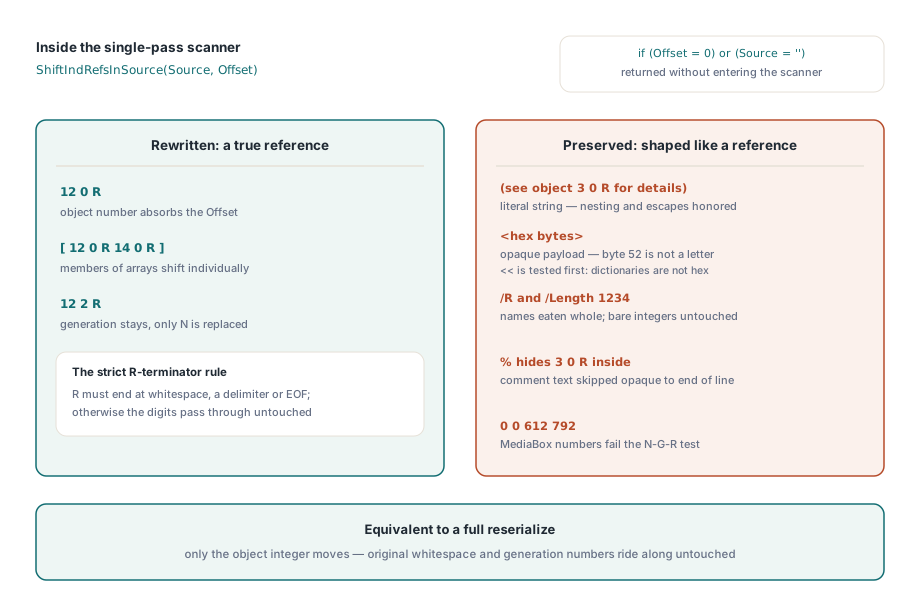
Penulisan ulang referensi tak langsung di level byte itu tampak mudah tetapi gampang salah, karena R dan rangkaian digit muncul di mana-mana di objek PDF dalam konteks yang bukan referensi. ShiftIndRefsInSource adalah scanner kecil buatan tangan yang menyapu byte satu kali dan hanya menulis ulang sebuah angka ketika angka itu diikuti, dengan whitespace PDF di antara token, oleh angka lain lalu delimiter R. Jalan keluar termurah didahulukan: jika offset nol atau sumber kosong, byte dikembalikan apa adanya tanpa masuk ke scanner sama sekali
Ketepatan scanner bergantung pada kemampuan mengenali konteks ketika urutan yang mirip referensi harus dibiarkan sendirian. Ini adalah batas yang paling mudah terlewat, dan masing-masing ditangani secara eksplisit:
- Literal string yang dibatasi oleh
(dan)disalin apa adanya, dengan melacak kedalaman nesting dan menghormati escape backslash supaya tanda kurung yang di-escape tidak mengacaukan hitungan kedalaman. String seperti(see object 3 0 R for details)berisi pola referensi textbook yang sebenarnya hanya prosa, dan harus lolos byte-for-byte - String heksadesimal yang dibatasi oleh
<dan>dilewatkan tanpa interpretasi. Byte52di dalam hex string adalah kode ASCII untukR, dan scanner yang memperlakukan payload hex sebagai teks bisa menciptakan referensi bayangan. Pembuka<<dari dictionary dideteksi lebih dulu supaya dictionary tidak disangka sebagai hex string - Objek name yang diawali
/dikonsumsi utuh, dari slash sampai whitespace atau delimiter berikutnya. Tanpa ini, name seperti/Ryang umum dipakai sebagai resource key bisa dibaca sebagaiRmilik sebuah referensi - Komentar yang diawali
%berjalan sampai akhir baris dan dilewati sebagai teks opak - Tes angka-lalu-R sangat ketat. Sebuah referensi hanya dikenali sebagai
NwhitespaceGwhitespaceRdenganRyang diakhiri whitespace, delimiter, atau akhir input. Jika nomor generasi hilang, atauRdiikuti huruf, digit ditulis keluar tanpa perubahan. Inilah yang melindungi integer di/Length 1234dan empat angka dalamMediaBoxagar tidak naik tanpa sengaja
Inti dari tes ketat itu hampir persis seperti kalimat spesifikasinya menjelaskannya:
if (P <= N) and (Source[P] = 'R') and
   ((P = N) or PLIsPdfWhite(Source[P + 1]) or PLIsPdfDelimiter(Source[P + 1])) then
  Obj1 := PLStrToIntDef(PLCopy(Source, I, E1 - I), -1);

if Obj1 >= 0 then
begin
  AppendStr(PLIntToStr(Obj1 + Offset));   // nomor objek yang telah digeser
  AppendBytes(E1, P - E1);                 // whitespace asli + nomor generasi
  AppendBytes(P, 1);                       // karakter 'R'
end;
Hanya nomor objek yang ditulis ulang; nomor generasi dan whitespace asli yang tepat di antara token disalin lewat apa adanya, jadi output byte-identical terhadap input kecuali satu integer yang memang harus berubah. Ketelitian itu adalah inti segalanya, karena itulah yang membuat pemakaian ulang byte sumber setara dengan full reserialize, bukan sekadar mendekatinya. Perilakunya ditutup oleh seperangkat unit test yang terfokus, mencakup referensi polos, referensi di dalam array, angka yang bukan referensi, literal string, hex string, dan nomor generasi non-nol dengan offset yang diterapkan
Mengapa bookmark tidak bisa memakai ulang AppendOutline
Menggabungkan bookmark dari beberapa dokumen ke dalam satu outline tree tampak seperti pekerjaan untuk helper AppendOutline yang sudah ada, karena helper itu memang sudah tahu cara menyambungkan bookmark level atas satu dokumen ke dokumen lain. Tetapi di sini itu alat yang salah, dan alasannya adalah ketidakcocokan lapisan yang halus. AppendOutline mencari bookmark level atas terakhir yang aktif dengan menelusuri reader atas byte file asli. Namun jalur merge cepat men-stage editnya di buffer objek baru lewat ChangeObject; reader tidak pernah melihat edit tersebut. Jika Anda merantai tiga dokumen atau lebih, setiap append akan mengarahkan ulang bookmark terakhir asli milik dokumen pertama ke dokumen terbaru, sehingga semua bookmark dokumen perantara terlepas dari rantai, hanya /Count kumulatif yang tetap benar, dan bug ini mudah terlewat sampai seseorang membuka panel bookmark
Jalur cepat menyelesaikannya dengan injeksi dua fase berbasis metadata yang tidak pernah menelusuri reader ulang. Pass pertama atas semua input mengumpulkan, per dokumen, objek root outline dan nomor generasi, nomor bookmark level atas pertama dan terakhir, serta /Count root. Dari ringkasan itu, kode menghitung nomor objek global dari setiap sambungan yang perlu dipalsukan, yaitu /Parent level atas tiap dokumen ke root bersama, /Prev bookmark pertama ke bookmark terakhir dokumen sebelumnya, dan /Next bookmark terakhir ke bookmark pertama dokumen berikutnya, semuanya menggunakan aritmetika nomor objek murni. Ada batasan urutan tulis di balik ini: objek dokumen pertama ditulis lebih dulu sebelum dokumen berikutnya bahkan dibuka, jadi semua edit outline dokumen pertama, yakni root /Count dan /Last, plus /Next bookmark terakhir lama, harus bisa diekspresikan sebagai aritmetika yang tidak membutuhkan dokumen berikutnya di tangan. Edit untuk tiap dokumen berikutnya diterapkan langsung setelah dibuka tetapi sebelum ditulis, sehingga semuanya lewat jalur change-object yang sama
Invarian penyelarasan offset yang menyatukannya
Baik pergeseran referensi maupun injeksi bookmark bergantung pada satu invarian aritmetika, dan inilah asumsi yang paling rapuh dalam seluruh desain. Referensi yang disuntikkan ke dokumen berikutnya ditulis sebagai nomor objek global target dikurangi Offset dokumen itu, sehingga ketika objek tersebut nanti digeser oleh ShiftIndRef(Offset), nilainya jatuh ke nomor global yang dituju. Dokumen pertama mendapat Offset = 0 dan memakai nomor global secara langsung. Agar pengurangan itu benar, urutan offset yang dipakai saat injeksi harus cocok dengan urutan offset yang dipakai saat objek akhirnya ditulis keluar
Itu memang cocok, karena sifat cara merge page dan form bekerja: AddPages, AddFields, dan AddFieldFonts hanya mengubah objek yang sudah ada milik dokumen pertama, mereka tidak pernah menambahkan objek baru. Jadi jumlah objek dokumen pertama tetap sama selama tahap page-merge, dan offset tiap dokumen berikutnya, yaitu jumlah dari semua objek dokumen sebelumnya, tetap stabil dari injeksi sampai write-out. Jika itu dipecah, misalnya ada tahap yang membuat objek baru di tengah merge, setiap referensi page dan bookmark di hilir akan meleset sebesar jumlah objek yang Anda tambahkan. Invarian ini tidak terlihat, tetapi ia menanggung beban utama
Tiga entry point di atas satu engine
Jalur cepat bukan cabang lain dari kode merge. Dalam pekerjaan yang sama, engine level byte difaktorkan menjadi satu routine internal, MergeFileListInternal(ListName, OutputFileName, PreserveStructTree, StrictMode), dan API publik menjadi pembungkus tipis yang memilih dua flag:
MergeFileListFastmemanggil engine dengan preservation structure-tree dimatikan, jalur paling ramping, yang membuang tagged-PDF tree supaya jalur byte berlaku pada sebanyak mungkin objekMergeFileListmemanggilnya dengan preservation diaktifkan, sehingga structure tree tetap hidup dan hasilnya tetap menjadi tagged PDF yang masih bisa dipakai. Jalur biasa ini juga mewarisi penggabungan bookmark dan form untuk banyak dokumenMergeFileListStrictmenyalakan strict mode: pass metadata pertama berhenti pada input pertama yang tidak melaporkan merge bersih, jadi hanya dokumen yang sudah terkumpul sebelum file bermasalah yang ikut, bukannya melewati file buruk itu lalu lanjut
Menyatukan jalur-jalur itu juga memungkinkan merge biasa dibangun ulang dari loop berpasangan O(N²), merge file satu dan dua, merge hasilnya dengan tiga, dan seterusnya sambil memparse ulang akumulator yang terus membesar pada setiap langkah, menjadi satu pass linear yang membuka tiap input sekali saja. Dua entry point lama untuk dua file dan dua stream, MergeFiles dan MergeStreams, tidak tersentuh dan tetap tersedia untuk caller yang memang benar-benar menginginkan merge berpasangan
Satu catatan jujur tentang perilaku structure-tree, karena ini sempat menjatuhkan test suite. "Penghapusan" di jalur cepat tidak total: jalur itu menghapus referensi katalog dokumen pertama ke /StructTreeRoot, tetapi objek structure-tree itu sendiri masih tetap ditulis keluar sebagai orphan. Jadi byte output cepat masih mengandung string /StructTreeRoot, dan Anda tidak bisa membedakan output cepat dari output biasa hanya dengan mencari string itu. Perbedaan yang sebenarnya adalah apakah katalog masih mencapai structure tree, karena itulah yang menentukan apakah file tersebut masih merupakan tagged PDF yang dapat dinavigasi
Kapan memakai jalur yang mana
Jalur byte adalah optimisasi throughput untuk menyusun banyak dokumen ketika Anda tidak perlu structure tree tagged-PDF dipertahankan, misalnya bundling report, run statement, atau concatenation batch. Saat diukur pada merge berulang atas set input menengah hingga besar, pemakaian ulang byte memangkas kira-kira empat sampai tiga belas persen dari waktu wall-clock tergantung campuran objek, tanpa kegagalan baru pada input kecil atau cacat, karena objek apa pun yang tidak bisa dibuktikan aman oleh scanner akan jatuh kembali ke parse penuh. Jika Anda memang membutuhkan structure tree utuh untuk aksesibilitas, pakailah jalur merge tagged-PDF biasa yang mempertahankannya; dan jika Anda bekerja dengan satu file yang sangat besar, bukan banyak input, teknik salin-byte yang dijelaskan di artikel pendamping tentang penggabungan dan pemisahan PDF besar dengan akses file langsung menerapkan filosofi yang sama, yakni "salin byte, hindari pohon objek penuh", pada skala file
Rutin merge dan varian cepat serta strict-nya merupakan bagian dari PDF Library for Delphi Delphi PDF Library, yang dokumentasinya memuat referensi lengkap untuk API file-list dan opsi merge yang dibahas di sini