Egy vak felhasználó megnyit egy negyedéves jelentést a vadonatúj Delphi-nézegetődben, bekapcsolja az NVDA-t, és hallja a lábjegyzetet, majd egy oszlopnyi számot, majd a címet, amit bármelyik látó olvasó elsőként olvasott volna. Vagy egyáltalán semmit sem hall. Az oldal tökéletesnek tűnik a képernyőn, és pontosan ez a csapda: a renderelés és az olvasás két különböző probléma, amelyeket különböző kód old meg. Annak a sorrendje, ahogyan egy PDF kirajzolja a glyphjait, semmilyen kötelezettséggel nem tartozik afelé a sorrend felé, ahogyan egy embernek hallania kellene őket, így egy kizárólag renderelési hívásokra épített nézegető hibátlan képet és használhatatlan felolvasást állít elő. A PDFium Component, a PDFium motor VCL/LCL wrapperje Delphihez, C++Builderhez és Lazarushoz, éppen ezért egy külön olvasási API-készletet is hordoz. A rajzoló API-k nem tudnak visszaszerezni egy olyan olvasási sorrendet, amelyet soha nem kaptak meg
Egy akadálymentes felolvasó három dolgon áll vagy bukik. Ki kell nyernie egy olyan sorrendet, amelyet egy képernyőolvasó fel tud olvasni, egy látható szókurzort kell tartania a hangosan felolvasott szóhoz rögzítve, és be kell vallania, ha egy dokumentum sosem lett megcímkézve, ahelyett hogy találgatna és úgy tenne, mintha nem így lenne. Mindegyikhez van egy egyértelmű API, amelyhez nyúlni lehet, és egy hiba, amely megharap, ha kihagyod a részletet
Az olvasási sorrend a struktúrafában él, nem a rajzolási sorrendben
Az ISO 32000-1 §14.8 a logikai struktúrát az oldal tartalma fölé rétegzett elemek fájaként határozza meg. A PDF/UA (ISO 14289-1) továbbmegy, és kötelezővé teszi ezt a fát: minden valódi tartalomelemnek elérhetőnek kell lennie rajta keresztül olvasási sorrendben, az oldalartefaktumokat pedig ilyenként megjelölve ki kell hagyni. Egy helyesen megcímkézett jelentés tudja, hogy a „Negyedéves eredmények" egy másodszintű címsor, és hogy az összesítő rács egy fejléccellákkal rendelkező táblázat. Egy megcímkézetlen jelentés csak egy rakás pozicionált glyph-futam, amely véletlenül dokumentumnak néz ki
A ReadablePageContent bejárja ezt a struktúrát, ha jelen van, és szemantikus Kind-dal megcímkézett töredékeket ad vissza, olyan értékekkel, mint a cfHeading és a cfParagraph, így a felhasználói felület a szavak előtt mondhatja, hogy „címsor", ahelyett hogy egy félkövér sort hétköznapi törzsszövegként olvasna fel. Használható fa hiányában ugyanez a hívás heurisztikus elrendezés-elemzésre esik vissza: oszlopokat érzékel, alapvonalakat csoportosít, balról jobbra és fentről lefelé rendez. Ez a visszaesési út egyoszlopos feljegyzésnél rendben van, és bizonytalan egy hírlevélnél, egy többoszlopos űrlapnál, bármi olyannál, amiben oldalsáv vagy kiemelt idézet van. Az számít, hogy tudd, melyik eredményt kaptad, és az API ezt egyértelműen elmondja. A TPdfReadableContent rekord egy Source mezőt hordoz, amely rosStructure-re áll, amikor a sorrend a megcímkézett fából származott, vagy rosHeuristic-ra, amikor geometriából következtették ki. Ha egy találgatott sorrendet úgy mutatsz be, mintha ellenőrzött lenne, azzal az akadálymentesítés megfelelőjét szállítottad le annak, amikor egy soha le nem futtatott buildre sikeres jelvényt biggyesztenek
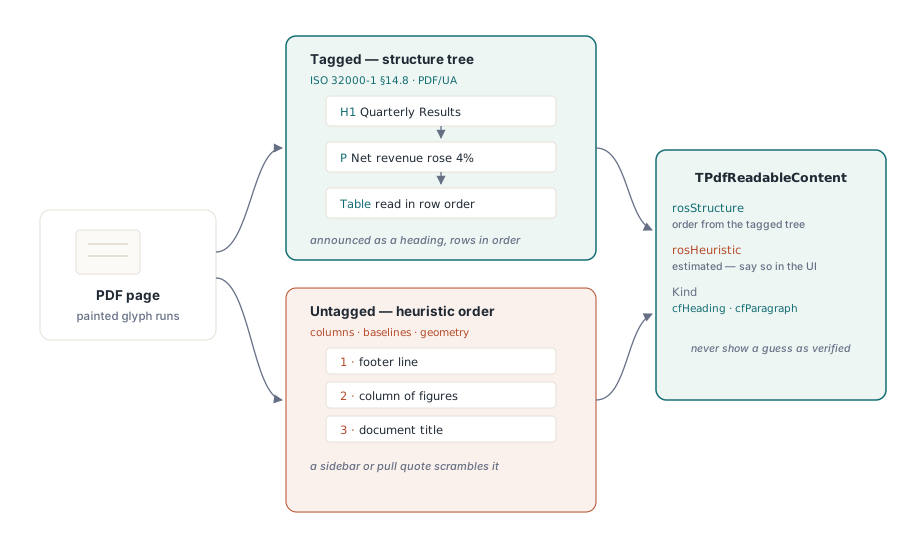
Az olcsó lépés megnyitáskor az, hogy kiolvasod az IsTagged-et, egyszer meghívod a ValidatePdfUa-t, majd gyorsítótárazod a választ. Egy sikertelen PDF/UA-ellenőrzés nem indok a fájl elutasítására. Indok arra, hogy a „becsült olvasási sorrend" szöveget tedd ki az állapotsorba, így amikor egy ügyfél panaszt küld egy összekavart felolvasásról, a support már tudja, hogy egy címkézési problémát lát-e a fájlban, vagy egy hibát a te kódodban
Az oldaltól a beszédsorig a ReadingUnits-szal
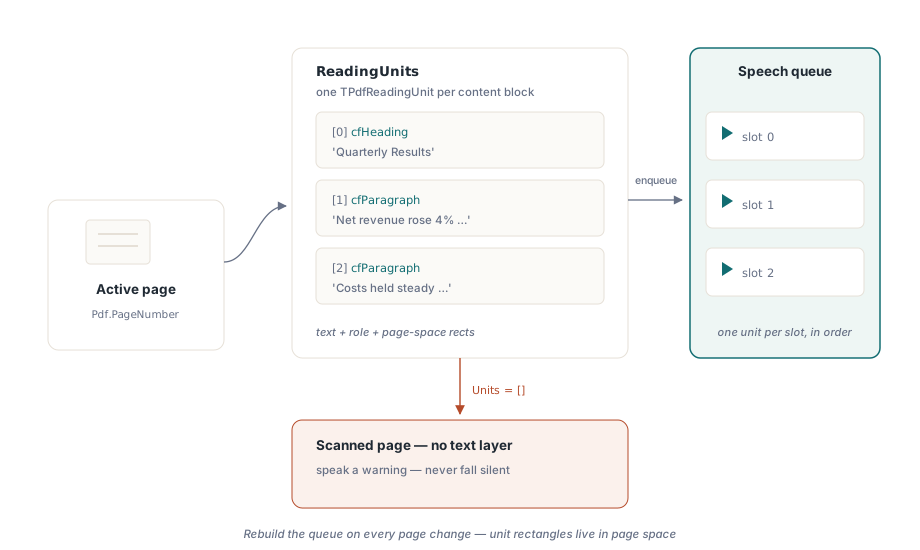
A szövegfelolvasáshoz a ReadingUnits végzi a nehéz munkát. Egy TPdfReadingUnit rekordokból álló tömböt ad vissza az aktív oldalhoz, mindegyikben a felolvasandó szöveggel, a szemantikai szerepével és az azt az oldalon elhelyező téglalapokkal. Van egy dokumentum-szintű társa, a DocumentReadingUnits, amikor oldalakon átívelő folyamatos felolvasást szeretnél. Egy egység közvetlenül egy beszédsor egy résébe kerül:
procedure TReaderForm.QueuePageSpeech(PageNumber: Integer);
var
  Units: TPdfReadingUnits;
  i: Integer;
begin
  Pdf.PageNumber := PageNumber;   // a ReadingUnits az aktív oldalon dolgozik
  Units := Pdf.ReadingUnits;
  FSpeechQueue.Clear;
  for i := Low(Units) to High(Units) do
    FSpeechQueue.Add(Units[i]);  // szöveg + szemantika + kiemelő téglalapok
  FCurrentPage := PageNumber;
  SpeakNextUnit;
end;
Ebben a ciklusban két dolgot könnyű elrontani. Tartsd oldalanként a sort, és építsd újra, amikor a felhasználó navigál, mert az olvasási egységek oldaltéri téglalapokat hordoznak; egy harmadik oldalról megmaradt sor a negyedik oldalra fogja festeni a kiemeléseit. Egy olyan oldalon, amelynek egyértelműen van tartalma, egy üres Units tömböt kezelj a csak-kép-detektorodként. Egy beszkennelt oldal pixelek, alattuk szövegréteg nélkül, és a helyes válasz az, hogy elmondasz egy figyelmeztetést („ezen az oldalon nincs kinyerhető szöveg"), ahelyett hogy elnémulnál olyan módon, amit a hallgató nem tud megkülönböztetni egy lefagyástól
Egy szókurzor, amely követi a hangot
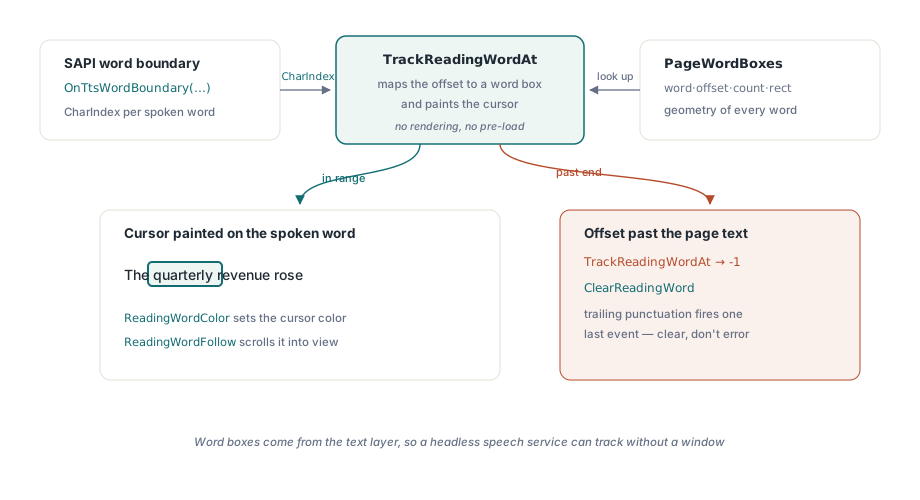
Ha egyszerre egy egész bekezdést emelsz ki, az lomhának hat egy gyengénlátó felhasználó számára, aki szemmel követi a szavakat, miközben azokat felolvassák. A szószintű kiemelésnek, a karaoke-effektusnak, két darabra van szüksége: minden szó geometriájára, és egy módra, amellyel a TTS-motor előrehaladási jelentéseit erre a geometriára lehet leképezni. A PageWordBoxes TPdfWordBox rekordokként adja meg a geometriát, mindegyikben a szó szövegével, karakter-eltolásával, karakterszámával és egy oldaltéri téglalappal. A TrackReadingWordAt adja meg a leképezést. Add meg neki azt a karakterpozíciót, amelyet a SAPI szóhatár-eseménye már jelent, és az feloldja azt az eltolást a szódoboz-tömb egy indexére, és egyetlen hívással kifesti a kurzort az egyező szóra
procedure TReaderForm.PrepareKaraoke(PageNumber: Integer);
begin
  // A nézet szódobozai a nézet által megjelenített oldalról származnak.
  // Ha csak a Pdf.PageNumber-t állítanád be, az nem mozgatná a nézetet
  PdfView.PageNumber := PageNumber;
  FWordBoxes := PdfView.PageWordBoxes;
end;

procedure TReaderForm.OnTtsWordBoundary(Sender: TObject; CharIndex: Integer);
var
  WordIdx: Integer;
begin
  // a TrackReadingWordAt leképezi az eltolást ÉS kifesti a szókurzort
  WordIdx := PdfView.TrackReadingWordAt(FCurrentPage, CharIndex);
  if WordIdx < 0 then
    PdfView.ClearReadingWord;  // a határ túlfutott az oldal szövegén
end;
A szerződés az egyik ponton nagyvonalú, a másikon könyörtelen. A nagyvonalú rész: a TrackReadingWordAt saját szódoboz-gyorsítótárat tart fenn ahhoz az oldalhoz, amelyet követ, így nincs mit előre betölteni, és egyáltalán nem történik renderelés, mert a szódobozok a szövegrétegből származnak. Egy fejnélküli, látható ablak nélküli beszédszolgáltatás is tudja követni a pozíciókat. A könyörtelen rész: a karakterindexnek abba a szövegbe kell mutatnia, amelyet a komponens kinyert, nem valamilyen általad saját kezűleg megtisztított karakterláncba. Amikor a CharIndex túlfut az oldal szövegének végén, a függvény -1-et ad vissza ahelyett, hogy kivételt dobna, ami folyamatosan megtörténik, amikor egy TTS-motor egy utolsó határeseményt tüzel el egy záró írásjelre. Az -1-et úgy olvasd, hogy „töröld a kurzort", soha ne hibaként
A megjelenítés oldalán a ReadingWordColor állítja be a kurzor színét. Az alapértelmezett borostyánszín a legtöbb oldalháttéren megállja a helyét, de teszteld le minden megjelenítési szűrő alatt, amit a nézegetőd kínál. Egy borostyánszínű kurzor teljesen eltűnhet színinvertálás alatt, és az invertálás beszéddel párhuzamosan futtatva pontosan az, ahogyan egy gyengénlátó felhasználó dolgozik, így az a kombináció, amelyet a leginkább el kell találnod, az, amelyet egy gyors demó soha nem gyakorol ki. Állítsd a ReadingWordFollow-t True-ra, és a nézet magától görgeti láthatóvá a kimondott szót, amit nem tudsz megoldani egy olyan nagyított oldalon, amely szét van csúszva a képernyőkön. Ügyelj egy hatókör-szabályra: a SetReadingWord csak az aktív TPdfView-oldalon fest. Előre döntsd el, hogy a kézi görgetés szünetelteti-e a beszédet, vagy a követési viselkedés felülírja azt, mert ha egyiket sem választod, a hang tovább olvas, miközben a kurzor valahol a képernyőn kívül ül
A dokumentumok, amelyek elrontják a felolvasódat
Néhány bemeneti forma elég megbízhatóan legyőzi a naiv implementációt ahhoz, hogy állandó mintaként kerüljenek a regressziós tesztkészletbe, ne pedig egyszeri hibaként, amit kijavítasz és elfelejtesz
- Megcímkézetlen, de szövegben gazdag fájlok. A heurisztikus sorrend általában helyes egy lineáris jelentésnél, és rossz lesz abban a pillanatban, amint egy oldalsáv vagy kiemelt idézet belép. Jelöld meg a sorrendet becsültként, mind a felhasználói felületen, mind a diagnosztikai naplóban, hogy a hiba később olvasható legyen
- Csak képet tartalmazó szkennelt oldalak. Egyáltalán nincs szövegréteg. Fogd el ezeket üres olvasási egységeken keresztül, és irányítsd a felhasználót egy előzetes OCR-lépéshez, ahelyett hogy hagynád, hogy a felolvasó egy üres oldalt narráljon
- Kombináló karakterek és kevert írásrendszerek. A Unicode kombináló jelek nem mindig omlanak össze egy az egyben látható szavakká, így a szódoboz-szám elsodródhat attól, amit a saját tokenizálód vár. Ne indexeld a szódoboz-tömböt olyan eltolásokkal, amelyeket saját magad számoltál ki a szöveg felosztásával; csak azokat az indexeket használd, amelyeket a
TrackReadingWordAtad vissza
Teszteld úgy, mint egy auditor, ne úgy, mint egy demó
„Felolvasta a mintámat" semmit sem bizonyít. Egy megvédhető siker három fájlt futtat át a kész buildön NVDA-val csatlakoztatva: egy ismerten megcímkézett fájlt, ahol a címsorokat címsorként jelentik be, és egy táblázatot sor-sorrendben olvasnak fel; egy ismerten megcímkézetlen fájlt, ahol a becsült-sorrend jelző látható; és egy szkennelt oldalt, ahol a nincs-szöveg figyelmeztetést ténylegesen elmondják. Mindegyik olyan útvonalat gyakoroltat be, amelyet a szerencsés eset kihagy
Innen ellenőrizd, hogy a szókurzor duplán és feleannyi beszédsebességnél is rögzítve marad, és hogy a ReadingWordFollow görgetése nem küzd meg a felhasználó saját görgetésével. Ezután futtasd a beszédet, miközben végigmész minden színszűrőn, és figyeld, hogy a kurzor sosem tűnik el. A gyengénlátóknak szóló színszűrő-cikk részletesen tárgyalja ezt a renderelési útvonalat, a szó szintű beszédkurzor mélyelemzés pedig szétszedi a TTS időzítését
A fent használt olvasásiegység- és szódoboz-API-k a Delphihez és C++Builderhez (VCL), valamint Lazarus/FPC-hez (LCL) készült PDFium Component részeként érkeznek. A termékoldal a teljes API-referenciára mutat, beleértve az ezen példák mögötti olvasási egységek és szódobozok rekord-elrendezéseit is