A HotXLS, a natív Delphi és C++Builder Excel könyvtár, több szálon elemzi az XLSX munkalapokat egy háromfázisú betöltésen át: a lap XML-je sorosan tömörödik ki, párhuzamosan elemződik, a kis részek pedig utána sorosan olvasódnak be. A képesség első kiadása mindössze 12–25%-ot nyert, mert a Delphi alapértelmezett memóriakezelőjének zárja sorba állította a munkaszálakat. A cellánkénti kupacfoglalások nagyjából 20-ról 9,1-re csökkentése ×1,90 értékre emelte a párhuzamos gyorsulást nyolc szálon. Ez a cikk végigveszi a méréseket, a rossz kanyarokat és azt a két javítást, amely ténylegesen működött
Hogyan elemzi a HotXLS párhuzamosan az XLSX munkalapokat?
A HotXLS három fázisra osztja az Open hívást, és csak a középső fut munkaszálakon. Az ok a zip tároló: egy zip archívum egyetlen közös bemeneti adatfolyam egyetlen kitömörítő állapotgéppel, és azt az állapotgépet nem olvashatja két szál egyszerre. Zárba csomagolni értelmetlen volna, mert a kitömörítés bejegyzésenként eleve soros, így a zár csak extra terheléssel reprodukálná a soros végrehajtást. Az A fázis ezért még egy szálon tömöríti ki minden munkalap XML-jét a saját TMemoryStream pufferébe; a mérőfájlunkban ez nyolc lapszeletre nagyjából 4 ms volt, vagyis meg sem közelíti a szűk keresztmetszetet. A B fázis minden lapra lefuttatja a ParseWorksheetXml hívást egy munkakészleten, és itt lakik a betöltési idő szinte teljes egésze. A C fázis sorosan tér vissza a ziphez a kis részekért: megjegyzésekért, rajzokért, diagramokért és táblázatokért
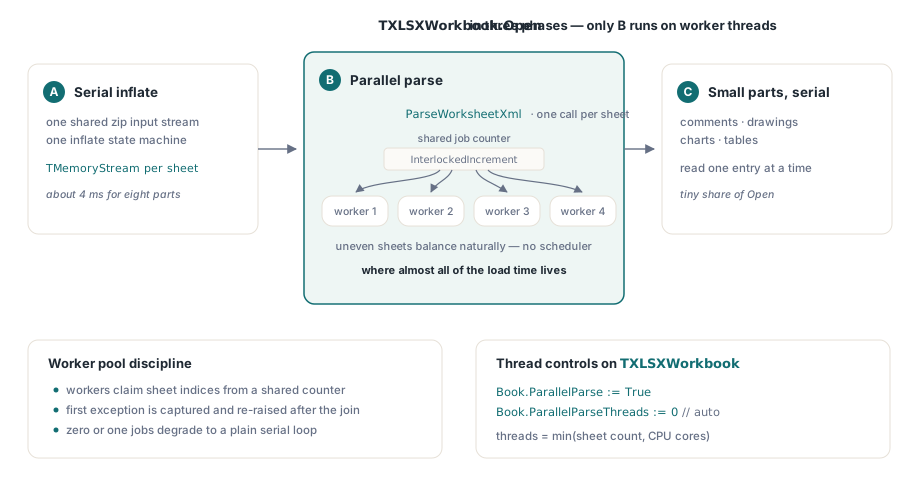
Maga a munkakészlet szándékosan egyszerű. A munkaszálak InterlockedIncrement hívással húznak feladatindexeket egy közös számlálóból, így az egyenetlen méretű lapok minden ütemező nélkül, természetesen egyensúlyozódnak ki. A szálszám min(lapszám, CPU magok), az első munkaszálas kivétel AcquireExceptionObject hívással kerül elkapásra, és az egyesítés után a főszálon váltódik ki újra, az elosztó pedig sima soros ciklusra esik vissza, ha nulla vagy egy feladat van. A TXLSXWorkbook két tulajdonsága vezérli a képességet: a ParallelParse kapuzza a készletet, a ParallelParseThreads pedig felső korlátot ad a szálszámnak, ahol a 0 automatikust jelent. A többlapos munkafüzetek azok az alakzatok, amelyek nyernek vele, beleértve azokat is, amelyeket egy sablonmunkalap sokszorozásával állít elő tucatszor
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    Book.ParallelParse := True;      // a párhuzamos munkakészlet engedélyezése
    Book.ParallelParseThreads := 0;  // 0 = auto: min(lapszám, CPU magok)
    if Book.Open('quarterly-ledger.xlsx') <= 0 then
      raise Exception.Create('open failed');
    // ... cellák olvasása a szokott módon; a munkafüzet teljesen felépült ...
  finally
    Book.Free;
  end;
end;
Miért lassítja a szálak hozzáadása az XLSX elemzést Delphiben?
Mert a Delphi alapértelmezett memóriakezelője globális zárral védi a kupacát, a munkalap elemzése pedig foglalássűrű: cellák, Variant és WideString értékek milliószám. Minden munkaszál, amely a kupachoz nyúl, sorba áll azon a záron, így azok a szálak, amelyek a forráskódban függetlennek látszanak, a gyakorlatban közel egyesével futnak. Az első mérésünk ezt fájdalmasan kézzelfoghatóvá tette. Egy 8 lapos, laponként 5000 sor és 4 oszlop méretű munkafüzeten, i5-11600K processzoron (6 mag, 12 szál) Win64 alatt mérve a párhuzamos Open mindössze 12–25%-ot javult a terv szerinti legalább 40% helyett. A 2, 3, 4, 6 és 8 szálon átfutó szálszámseprés lapos görbét adott, a későbbi műszerezett futásokban pedig a 2 szálas beállítás valójában 26%-kal lassabb volt a sorosnál, ami két, egy vitatott záron ide-oda pattogó szál klasszikus kézjegye
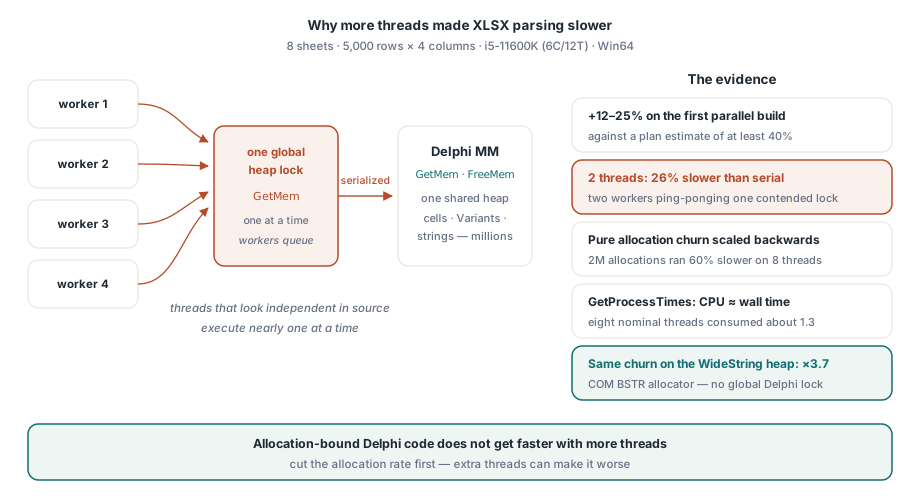
Három mérés szegezte le a diagnózist, és mindegyik felborította az előző megérzést. Először, egy apró fájl (8 lap, egy-egy sorral) 1,2 ms alatt nyílt meg, ami bizonyította, hogy az elemzés lényegében az Open 100%-a, és nem volt rejtett fix költség, amelyet hibáztatni lehetett volna. Másodszor, a tiszta foglalási forgalom mikromérése azt mutatta, hogy a Delphi memóriakezelő visszafelé skálázódik: ugyanaz a 2 millió objektum- és AnsiString foglalásnyi összmennyiség 8 szálon 60%-kal lassabban futott, mint egyen, miközben ugyanez a forgalom a WideString kupacon, amely a COM BSTR foglaló, nem a Delphi MM, ×3,7 értékig skálázódott. Az, hogy a HotXLS végig WideString típust használ, a történelem olyan véletlenének bizonyult, amely a javunkra vált. Harmadszor, a GetProcessTimes azt mutatta, hogy egy párhuzamos Open alatt a CPU idő nagyjából megegyezett a falióraidővel: nyolc névleges szál körülbelül 1,3 szálnyi CPU időt fogyasztott. A munkaszálak nem pörögtek; a memóriakezelő versengési útvonalán aludtak, blokkolva, nem elfoglalva
A gyakorlati tanulság a táblázatokon túl is általánosítható. Ha egy Delphi terhelés sokat foglal, a szálszám emelése semmit nem tesz addig, amíg a foglalási arány nem csökken, és könnyen ronthat is a helyzeten. E javítás előtt őszintén elmondtuk a ParallelParseThreads beállítást hangoló felhasználóknak az igazat: foglaláskorlátos fájlokon a több szál szinte semmit nem vett
Honnan jön cellánként 20 kupacfoglalás?
Egy SetMemoryManager hívással telepített számláló burkoló pontosan megválaszolta ezt a kérdést: cellánként körülbelül 20 Delphi MM foglalás, közülük 2,87 millió 32 bájt vagy annál kisebb. A bűnös egyáltalán nem a cellaobjektumok voltak. A TXMLScaner.GetTokenValue minden híváskor friss AnsiString értéket hozott létre, és cellánként nagyjából 15–20 alkalommal hívódik meg: egyszer-egyszer az elemnevekre, attribútumnevekre, attribútumértékekre és a szöveges tartalomra. Ráadásul az RTL UTF8ToWideString útvonala minden átalakításhoz ideiglenes UnicodeString köztes értéket gyártott. A cellaobjektumok mindössze 160 ezer foglalást tettek ki, az összes körülbelül 8%-át, ami helyben megölte az eredeti tervünket: cellaobjektum-készletet akartunk építeni, a számok pedig azt mondták, hogy sosem térülne meg
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);   // a kisobjektum-forgalom, amely érdekel minket
  Result := OldMM.GetMem(Size);
end;

// telepítés az Open előtt, visszaállítás utána
GetMemoryManager(OldMM);
NewMM := OldMM;
NewMM.GetMem := CountingGetMem;
SetMemoryManager(NewMM);
Ez a tízperces diagnosztika bármely Delphi teljesítményvizsgálathoz megéri az ellopást. A foglalások méretkategóriánkénti számlálása szinte semmibe nem kerül megépíteni, és megmondja, honnan ered valójában a memóriakezelőre nehezedő nyomás, ami a mi esetünkben két RTL szintű szokás volt az XML olvasón belül, nem pedig bármi az objektummodellben. A profilozók folyton az elemzőre mutattak mint egészre; a burkoló két konkrét sorra mutatott
A javítás: tokenkészletezés és köztes érték nélküli UTF-8 dekódoló
Két célzott változtatás az XML olvasóban a cellánkénti foglalások több mint felét megszüntette az elemző szerkezetének érintése nélkül. Az első az elemnevek készletezése. A munkalap XML-je végtelenül ismétel egy parányi szókincset: row, c, v, r, t, s és néhány attribútumnév. Az InternTokenName 64 rekeszes gyorsítótárat tart a korábban látott nevekről, és a TokenEqualsAnsi hívással veti össze a beolvasó építőpufferét egy gyorsítótárazott bejegyzéssel, ami közvetlen bájtösszehasonlítás, és semmit nem foglal. Találat esetén a gyorsítótárazott AnsiString értéket adja vissza, és itt számít a típusválasztás: az AnsiString hivatkozásszámlált, így egy gyorsítótárazott példány visszaadása egyetlen hivatkozásszámláló-növelésbe és nulla kupacforgalomba kerül. A WideString típusnak nincs hivatkozásszámlálója, és minden értékadás SysAllocString hívásán megy át, így a WideString értékek készletezése semmit nem takarítana meg. A készletezés csak a hivatkozásszámlált karakterlánctípuson éri meg
function TXMLScaner.InternTokenName: AnsiString;
var
  Slot: Integer;
begin
  Slot := TokenHash mod 64;
  if TokenEqualsAnsi(FInternNames[Slot]) then
    Result := FInternNames[Slot]    // csak hivatkozásszámláló++, nincs foglalás
  else
  begin
    Result := GetTokenValue;        // egyszeri létrehozás, majd gyorsítótárazás
    FInternNames[Slot] := Result;
  end;
end;
A második változtatás a cellaszöveget támadja. A régi útvonal AnsiString tokent épített, átadta az UTF8ToWideString hívásnak, amely UnicodeString köztes értéket épített, amely végül a cella által tárolt WideString értékké alakult: szövegtokenenként két Delphi MM foglalás a valódi előtt. A helyettesítője, az XmlUtf8ToWide(TokenPtr, TokenLen), kétmenetes, tiszta Pascal UTF-8 dekódoló, amely egyenesen a beolvasópufferből olvas: az első menet megméri az UTF-16 hosszt, a második egy egyszer lefoglalt WideString értékbe dekódol. Nettó költség szövegtokenenként: egy COM foglalás, nulla Delphi MM foglalás. Egy szemantikai megjegyzés az óvatosaknak: hibás UTF-8 sorozatokon az új dekódoló átengedi a bájtokat ahelyett, hogy helyettesítő karaktereket tenne be az RTL módján, ami csak azt érinti, hogyan romlanak le a sérült fájlok; érvényes bemeneten a kimenet bájtazonos. Az XML karakterentitások sosem jutnak el a dekódolóig, mert a beolvasó már feloldotta őket UTF-8 alakra a tokenpufferben
Mit hozott, és hol nem segít továbbra sem a párhuzamos elemzés
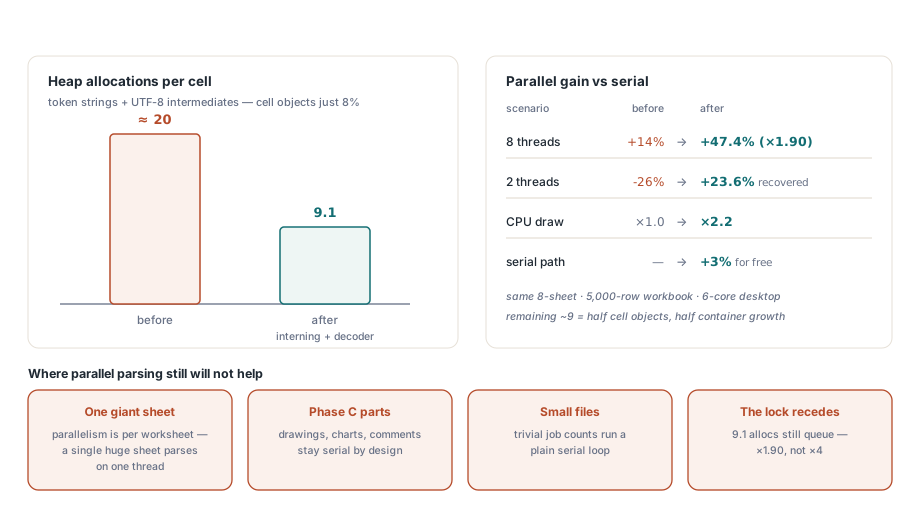
A két javítás körülbelül 20-ról 9,1-re vágta a cellánkénti foglalásokat, a párhuzamos számok pedig úgy mozdultak, ahogy az elmélet szerint kellett. Ugyanazon a 8 lapos, 5000 soros mérésen és ugyanazon a 6C12T gépen a 8 szálas javulás 14%-ról 47,4%-ra nőtt, ami ×1,90 gyorsulás a sorosnál. A 2 szálas eset 26%-kal lassabbról 23,6%-kal gyorsabbra fordult, a mért CPU kihasználtság pedig ×1,0 értékről ×2,2 értékre emelkedett. A soros útvonal ráadásként körülbelül 3%-kal gyorsult, mivel a kevesebb foglalás egyetlen szálnak is jót tesz. A maradék nagyjából 9 cellánkénti foglalás nagyjából fele cellaobjektum, fele amortizált tárolónövekedés; megmértük, csökkenőnek ítéltük a hozamot, és megálltunk, az MM burkoló pedig készen áll a hívási helyenkénti újramintavételre, ha egy jövőbeli terhelés újabb kört indokol
A határokat érdemes olyan kereken kimondani, mint a nyereségeket. A HotXLS munkalap-szemcsézettségen párhuzamosít, így az a munkafüzet, amely egyetlen óriási lap, egy szálon elemződik függetlenül attól, mit mond a ParallelParseThreads; arra az alakzatra a folyamatos közvetlen olvasó a jobb eszköz, mivel egyáltalán nem építi fel a munkafüzetet. Azok a fájlok, amelyek ideje a C fázis részeire, a rajzokra, diagramokra és megjegyzésekre megy el, kevesebbet nyernek, mert az a fázis tervezés szerint soros marad. A kis fájlokat egyáltalán nem éri meg szálasítani, ezért is fut az elosztó csendben sorosan jelentéktelen feladatszámoknál. A memóriakezelő plafonja pedig nem tűnt el, csak hátrébb húzódott: cellánként 9,1 foglalásnál a globális zár még mindig adóztatja a munkaszálakat, ezért ad nyolc szál ×1,90 értéket ×4 helyett. A betöltési és mentési idők csökkentésének szélesebb eszköztárához, benne a stílusokkal, készletekkel és tömeges sorvisszahívásokkal, lásd a nagy munkafüzetek teljesítményéről szóló útmutatónkat
A párhuzamos XLSX elemzés, a ParallelParse és ParallelParseThreads tulajdonságok, valamint az itt leírt, foglalástakarékos XML olvasó a HotXLS Delphi Excel Component szabványos részeként érkezik, amely XLS, XLSX és ODS fájlokat olvas és ír natívan Delphiből és C++Builderből, mindenféle Excel automatizálás nélkül