Küldje el a يوضح ملف PDF هذا arab mondatot az egyszerű TextOut hívásnak, és a visszakapott oldal egyszerre két módon is hibás lesz. A szavak balról jobbra futnak jobbról balra helyett, a betűk pedig egymástól elkülönülve, izolált alakjukban állnak ahelyett, hogy összefüggő szavakká kapcsolódnának. Semmi nem jelez hibát. A Delphi lefordítja, a fájl megnyílik, és egy arabul olvasó lektor közli Önnel, hogy a kimenet használhatatlan. A javítás egyetlen hívás, nem könyvtárcsere: a HotPDF a jobbról balra író szöveget külön metóduson, az RtLTextOut hívásán vezeti át, amely elvégzi azt az átrendezést, amelyet az egyszerű TextOut nem. Ez az oldal ennek a metódusnak a használható referenciája: a szignatúra és paraméterei, az írásrendszert kiválasztó charset argumentum, a dokumentumszintű mellékhatás, az előre elvégzendő betűtípus-beállítás, valamint azok a hibák, amelyek ténylegesen eljutnak a támogatásig, mindegyik a maga javításával
Szignatúra és paraméterek
procedure RtLTextOut(X, Y: Single; angle: Extended;
  Text: WideString); overload;
procedure RtLTextOut(X, Y: Single; angle: Extended;
  Text: PWORD; TextLength: Integer); overload;
Az X és az Y az oldal saját koordináta-rendszerében rögzíti a szövegfutamot, a bal alsó saroktól mérve, felfelé növekvő Y értékkel — ugyanaz az origó, amelyet minden TextOut hívás használ; az RtLTextOut a glifák sorrendjét változtatja meg, nem azt, honnan mér az oldal. Az angle pontosan úgy forgatja el az alapvonalat, mint a TextOut esetében, tehát a 0 vízszintes sort rajzol. A Text a karakterlánc logikai sorrendben, abban a sorrendben, ahogyan begépelné, a második túlterhelt változat pedig ugyanazokat az UTF-16 adatokat nyers PWORD pufferként veszi át, kifejezett kódegység-számmal; ezt az alakot használja, amikor a szöveg egy API-tól érkezik, nem Delphi karakterláncként. Azokon a régebbi Delphi-verziókon, amelyek még nem ismerik az ilyen típusú túlterhelés-feloldást, a karakterláncos alak RtLTextOutStr néven érhető el azonos paraméterlistával
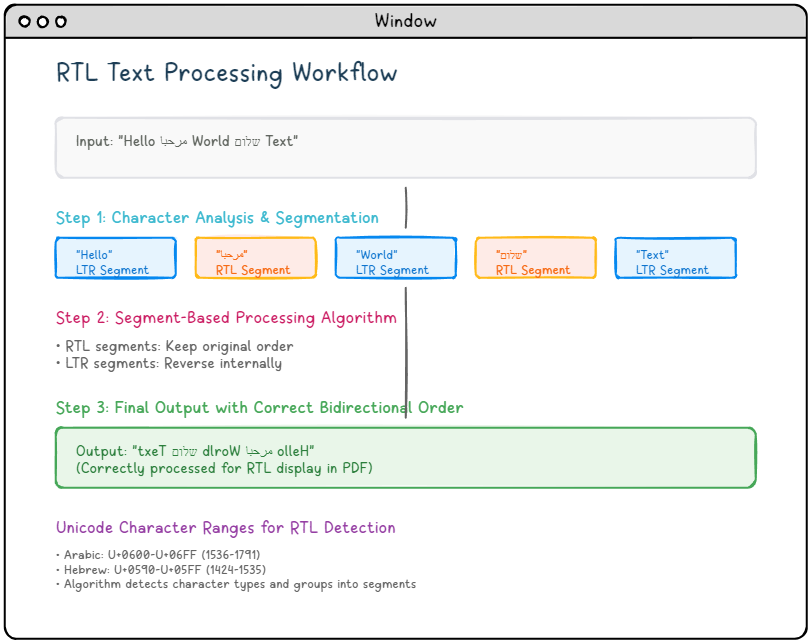
A két kimeneti hívás közötti munkamegosztás szigorú. A TextOut abban a sorrendben rajzolja ki a kódpontokat, ahogy átadja őket, ami helyes latin, cirill és CJK szövegnél, és helytelen arab és héber esetén. Az RtLTextOut minden sort először vizuális, jobbról balra haladó sorrendbe rendez, majd rajzol, miközben a beágyazott latin szavakat és számjegyeket a soron belül balról jobbra olvashatóan tartja. A HotPDF szándékosan tartja külön a két metódust ahelyett, hogy a karakterekből találgatná az irányt, tehát az, hogy melyiket hívja meg, egyben annak a megválasztása, milyen írásrendszeri viselkedést kap; használja az RtLTextOut hívást a jobbról balra futó szövegekhez, a TextOut hívást minden máshoz, és soha ne vezesse át egyiket a másikon. Hogy az átrendezés miért létezik egyáltalán, mit tesz valójában a Unicode kétirányú algoritmusa és az arab kontextusfüggő összekapcsolás, és hol ér véget a HotPDF alakítása, arról a arab és RTL szövegalakításról HotPDF-fel szóló testvércikk szól; minden alábbi a gyakorlati beállítás
A charset argumentum dönti el az írásrendszert
Nem a metódus mondja meg az RtLTextOut hívásnak, hogy arab vagy héber szöveget tördel, hanem a betűtípus. A SetFont negyedik argumentumként egy Windows charset értéket vár, és ez az érték viszi be az írásrendszer szabályait a jobbról balra író hívásba: a 178 az arabot választja, a 177 a hébert. Állítsa be a charset értéket, majd rajzoljon, és az alábbi két sor minden további beállítás nélkül helyes olvasási sorrendben jön ki
// Arab: a 178-as charset mondja meg az RtLTextOut hívásnak, hogy arab szabályokat alkalmazzon
Pdf.CurrentPage.SetFont('Arial Unicode MS', [], 12, 178);
Pdf.CurrentPage.RtLTextOut(400, 700, 0, 'يوضح ملف PDF هذا');

// Héber: a 177-es charset héberre váltja a szabályokat
Pdf.CurrentPage.SetFont('Arial Unicode MS', [], 12, 177);
Pdf.CurrentPage.RtLTextOut(400, 660, 0, 'קובץ PDF זה');
Egy sorrendi részletet könnyű elnézni: a SetFont hívásnak elöl kell állnia, és minden AddPage után meg kell ismételni, mert az aktuális betűtípus, a charset értékkel együtt, nem éli túl az oldaltörést. Felejtse el az ismétlést, és a második oldal arra a betűtípusra esik vissza, amely éppen aktív volt, ami arab szövegnél többnyire üres dobozokat jelent
Nem fordítja meg azt a szöveget, amelyet Ön már megfordított
Az az egyetlen hiba, amely itt a legtöbb hibakeresési időt nyeli el, az, hogy olyan karakterláncot ad át az RtLTextOut hívásnak, amelyet kézzel már megfordított. A fejlesztők azután jutnak el ehhez a metódushoz, hogy az egyszerű TextOut hívással tett első próbálkozás fordítva jött ki, és a gyakori tűzoltás az, hogy rajzolás előtt kódból megfordítják a karaktereket. Az RtLTextOut belül maga is megfordítja a szöveget, így az előre megfordított karakterlánc másodszor is megfordul, és pontosan oda kerül vissza, ahonnan indult. Adja át a szöveget logikai sorrendben — abban, ahogyan begépelné és felolvasná —, és bízza az átrendezést a hívásra
A csapda csúnyább egy egyszerű tükrözésnél, mert a kétszeresen megfordított karakterlánc helyesnek látszhat egyetlen, csupa arab tesztmondaton, majd abban a pillanatban eltörik, amikor egy sor latin szót vagy számot hordoz. Egy jobbról balra futó soron belül ezeknek a beágyazott részeknek balról jobbra kell olvashatónak lenniük, és a kézi megfordítás tönkreteszi ezt az egymásba ágyazást, miközben a tisztán arab eset történetesen túléli. Így a hiba átcsúszik az első füstteszten, és később bukkan fel egy valódi számlán, amelyen szerepel egy számlaszám. Szedjen ki minden kézi megfordítást abban a pillanatban, amikor átáll az RtLTextOut hívásra
Az ismerni érdemes Direction mellékhatás
Az RtLTextOut hívása többet változtat meg annál a sornál, amelyet éppen rajzol. A dokumentum olvasásirány-beállítását is jobbról balra állítja át — ugyanazt, amelyet különben Ön állítana be a Direction tulajdonságon keresztül. Ez a beállító a vpDirection értéket adja a dokumentum ViewerPreferences gyűjteményéhez, ami megmondja a megjelenítőnek, hogyan rendezze a kétoldalas nézeteket, és melyik oldalról induljon a szemközti oldalpáros elrendezés. Amikor a teljes dokumentum arab vagy héber, éppen ez a kívánt viselkedés, és ingyen megkapja
Pontosan azért érdemes tudni róla, mert egyetlen oldalon láthatatlan. Ha a dokumentum túlnyomórészt balról jobbra halad, és csak egyetlen jobbról balra futó blokkot tartalmaz, az első RtLTextOut hívás akkor is átbillenti az egész fájl beállítását, és az egyoldalas próbanyomatán ebből semmi nem látszik. A tünet hetekkel később jelenik meg, amikor valaki kétoldalas füzetet nyomtat, és az oldalpárok tükrözve jönnek ki. Ha nem ezt szeretné, a jobbról balra futó rész után állítsa vissza kifejezetten a Direction értéket:
// Az RtLTextOut már RightToLeft értékre állította a dokumentum irányát;
// állítsa vissza balról jobbra, ha a dokumentum túlnyomórészt LTR
Pdf.Direction := LeftToRight;
Olyan dokumentumnál, amely valóban jobbról balra olvasandó, hagyja békén. A lényeg az, hogy tudjon a hívás dokumentumszintű hatásáról, így a füzetes meglepetés soha nem következik be
Azt a betűtípust regisztrálja, amelyet szállít, ne azt, amelyről reméli, hogy telepítve van
Az egész átrendezés semmit nem ér, ha a betűtípusnak nincsenek kirajzolható glifái. A klasszikus kudarc az a jelentés, amely hibátlanul renderelődik a fejlesztő gépén, ahol az Arial Unicode MS történetesen jelen van, és üres dobozok soraiként jön ki az ügyfél kiszolgálóján, ahol a Windows csendben olyan betűtípust helyettesített be, amelynek egyáltalán nincs arab lefedettsége. A gyógymód az, hogy ne bízzon többé a telepített rendszerbetűtípusokban, hanem regisztráljon egy olyat, amelyet az alkalmazással együtt szállít
// Szállítson egy ismert arab betűtípust, és regisztrálja rajzolás előtt
Pdf.RegisterUnicodeTTF('C:\Fonts\NotoSansArabic.ttf');
Pdf.CurrentPage.SetFont('NotoSansArabic', [], 12, 178);
Pdf.CurrentPage.RtLTextOut(400, 700, 0, 'يوضح ملف PDF هذا');
A regisztrációval két határ is együtt jár. A RegisterUnicodeTTF hívással behozott betűtípus beágyazódik, és a HotPDF beágyazott Unicode-kezeléséhez a dokumentumnak PDF 1.5-ösnek vagy újabbnak kell lennie; ez csak akkor harap, ha valami a lánc végén PDF 1.4-hez ragaszkodik, de amikor igen, a hiba csendes. A másik határ inkább jogi, mint technikai: a TrueType fájlok beágyazási engedélybiteket hordoznak, és az a betűkép, amely a képernyőn rendben van, olyan licenc alatt állhat, amely tiltja az ügyféldokumentumokba való beágyazását. A licencet a beágyazás előtt erősítse meg, ne egy panasz után
Teljes konzolos példa
Összerakva a darabokat, itt egy önmagában megálló program, amely egy oldalra kiír egy arab sort, egy héber sort és egy vegyes sort, amely latin terméknevet hordoz. Minden blokk beállítja a maga charset értékét, majd logikai sorrendben rajzol
program RtLTextOutDemo;

{$APPTYPE CONSOLE}

uses
  HPDFDoc;   // a HotPDF fő unitja

var
  Pdf: THotPDF;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.FileName := 'RtLTextOut.pdf';
    Pdf.BeginDoc;

    // A latin címsor a szokásos TextOut útvonalon megy át
    Pdf.CurrentPage.SetFont('Arial', [fsBold], 16);
    Pdf.CurrentPage.TextOut(40, 780, 0, 'Right-to-left text with HotPDF');

    // Arab: 178-as charset, logikai sorrend, az átrendezést az RtLTextOut végzi
    Pdf.CurrentPage.SetFont('Arial Unicode MS', [], 12, 178);
    Pdf.CurrentPage.RtLTextOut(400, 720, 0,
      'يوضح ملف PDF هذا كيفية التعامل مع النص العربي.');

    // Héber: 177-es charset
    Pdf.CurrentPage.SetFont('Arial Unicode MS', [], 12, 177);
    Pdf.CurrentPage.RtLTextOut(400, 680, 0,
      'קובץ PDF זה מדגים טקסט עברי הזורם מימין לשמאל.');

    // Vegyes sor: a beágyazott latin szó továbbra is balról jobbra olvasható
    Pdf.CurrentPage.SetFont('Arial Unicode MS', [], 12, 178);
    Pdf.CurrentPage.RtLTextOut(400, 640, 0,
      'مرحبا بالعالم! تم إنشاؤه بواسطة HotPDF');

    Pdf.EndDoc;
    Writeln('Wrote RtLTextOut.pdf');
  finally
    Pdf.Free;
  end;
end.
Futtassa le, és nyissa meg az eredményt. Az arab és a héber sor jobbról balra olvasható, a betűk ott kapcsolódnak, ahol az írásrendszer összekapcsolja őket, az utolsó sorban pedig a HotPDF token balról jobbra ül az arab szövegfutamon belül. Ez az egymásba ágyazás a helyes kétirányú eredmény, nem hiba, még ha az első alkalommal lektorálók rendszeresen hibaként is jelentik; a fent hivatkozott alakítási cikk elmagyarázza, miért követelik meg ezt a Unicode-szabályok, és hogyan fogalmazza meg az átvételi feltételeit, hogy a hibajelentés soha ne szülessen meg
Gyakori hibák és javításuk
Az alábbi kudarcok mindegyike felbukkant már valódi támogatási szálban, és mindegyik a fenti szakaszok valamelyikére vezethető vissza
- A kimenet visszafelé olvasható, vagy összekeveredik a vegyes sorokon — a karakterláncot a hívás előtt kézzel megfordították, rendszerint egy
TextOutpróbálkozásból ottfelejtett kerülőmegoldásként. Törölje az összes kézi megfordítást, és adja át logikai sorrendben; azRtLTextOutbelül fordít - A betűk összekapcsolás nélkül, izolált alakban nyomtatódnak — a szöveg az egyszerű
TextOuthívásán ment át, vagy aSetFonthívás jobbról balra írt charset nélkül futott le. Rajzoljon azRtLTextOuthívással, és adja át a 178-as értéket arabhoz vagy a 177-est héberhez aSetFontnegyedik argumentumaként - Üres dobozok az ügyfél gépén — a Windows olyan betűtípust helyettesített be, amelynek nincs arab vagy héber lefedettsége. Ne telepített betűtípusokat nevezzen meg; regisztráljon egy általa szállított betűképet a
RegisterUnicodeTTFhívással, és azon a néven adja meg aSetFonthívásban - A második oldal rossz betűtípussal renderelődik — az aktuális betűtípus nem éli túl az
AddPagehívást. Ismételje meg aSetFonthívást, a charset értékkel együtt, minden oldaltörés után - A kétoldalas oldalpárok tükrözve nyomtatódnak egy túlnyomórészt LTR dokumentumnál — az első
RtLTextOuthívás mellékhatásként átbillentette a dokumentumDirectionértékét. A jobbról balra futó rész után állítsa be aPdf.Direction := LeftToRightértéket - A beágyazott Unicode szöveg csendben leromlik a lánc végén — valami a folyamatban PDF 1.4 verziót kényszerít ki, a HotPDF beágyazott Unicode-kezeléséhez viszont 1.5-ös vagy újabb kell. Emelje meg a dokumentum verzióját, vagy szüntesse meg a lánc végi megkötést
Mielőtt a formátum kikerülne, a szemrevételezésen túl is ellenőrizzen: másolja ki a szöveget a megjelenítőből, futtassa le a dokumentumon belüli keresést, nyissa meg a fájlt olyan gépen, amelyen nincsenek meg a fejlesztői betűtípusai, és tegyen egy valódi dokumentumot egy anyanyelvi olvasó elé. A teljes ellenőrzőlista, az írásrendszerenkénti lefedettségi térkép és az érdemben felépítendő teszt-karakterlánc korpusz mind az arab és RTL szövegalakításról HotPDF-fel szóló testvércikkben található
Az itt bemutatott RtLTextOut, SetFont és RegisterUnicodeTTF hívások a Delphihez és C++Builderhez készült HotPDF Delphi Component részei