A HotPDF Delphi Component Delphiből és C++Builderből is képes szöveget keresni és cserélni egy meglévő PDF-en belül. A SearchLoadedPageText és a SearchLoadedDocumentText glifaszintű pontossággal találja meg egy karakterlánc minden előfordulását, a ReplaceLoadedPageText és a ReplaceLoadedDocumentText pedig helyben írja át az illeszkedő bájtokat — feltéve, hogy minden csere-karakter újrakódolható az eredeti betűtípuson keresztül; ezt a fizikai korlátot ez a cikk őszintén tárgyalja, nem pedig lábjegyzetbe rejti
A funkció mögötti kérés mindig hétköznapi. Egy cég nevet vált, és háromezer archivált számla még mindig a régi nevet viseli. Egy szerződéssablon a tavalyi lejárati dátummal került ki. Egy termékkódot kivontak a forgalomból, és minden adatlapon, amely említi, az utódkódnak kell szerepelnie. Egy szövegszerkesztőben mindegyik harminc másodperces munka. Egy PDF-ben viszont valóban nehéz feladat, és annak megértése, hogy miért, az a különbség, ami az API jó használata és egy olyan hibajelentés beküldése között van, amely valójában szabványhivatkozás
Miért ilyen nehéz szöveget cserélni egy PDF-ben?
A szövegcsere azért nehéz egy PDF-ben, mert a PDF-oldal nem szerkeszthető szöveget tartalmaz, hanem pozicionált glifákat. Az ISO 32000-1 §9.4 szövegmegjelenítési modellje szerint a tartalomfolyam olyan operátorokat vezérel, mint a Tj és a TJ, amelyek karakterkód-sorozatokat festenek ki a szövegmátrix által meghatározott koordinátákon. Ezek a kódok nem Unicode-értékek; indexek abba a kódolásba, amelyet az oldal betűtípusa deklarál, és az olvasható karakterekre visszavezető leképezés élhet egy /ToUnicode CMap-ben, egy kódolási különbségtömbben vagy egy CID-leképezési láncban. Nincs bekezdésobjektum, nincs szövegfolyam, és semmi nem garantálja, hogy egy vizuálisan összetartozó szó egyetlen karakterláncként van tárolva
A csere a dekódolás fölé egy második nehézségi réteget húz: pontosan tudnia kell, hogy az eredeti adatfolyam mely bájtjai állították elő az egyes glifákat, hogy az új bájtokat pontosan abba a tartományba és sehová máshová illeszthesse be. Egy szövegkinyerő megengedheti magának, hogy eldobja a bájtpozíciókat, amint megvan a Unicode. Egy cserélő nem. Ezért osztotta szét a HotPDF a munkát két kiadásra — a v2.251.0 építette fel az eltoláskövető és kereső réteget, a v2.252.0 pedig az erre épülő átíró réteget
Szöveg megtalálása: glifaszintű keresés bájteltolás-követéssel
A HotPDF SearchLoadedDocumentText metódusa úgy találja meg a keresett minta minden előfordulását, hogy az egyes oldalak dekódolt Unicode glifasorozatához illeszt, nem a nyers adatfolyam-bájtokhoz, így a találat találat marad függetlenül attól, hogyan kódolta a betűtípus. Az alatta lévő infrastruktúra a v2.251.0 verzióban jelent meg: a tartalomfolyam tokenizálója minden karakterlánc-operandushoz feljegyez egy StartOfs/EndOfs bájttartományt — a ( ) vagy < > határolóival együtt —, és minden dekódolt glifa hordoz egy TokenIndex/ItemIndex/ByteOffset hármast, amely pontosan arra az operandusra, TJ-tömbelemre és kódegységre mutat vissza, amely előállította. Ugyanez a glifaértelmező hajtja meg a betöltött PDF-ből történő szövegkinyerést Delphiben ismertető cikkben leírt kinyerési API-t is; a keresés egyszerűen megőrzi azt a származási információt, amelyet a kinyerés eldob
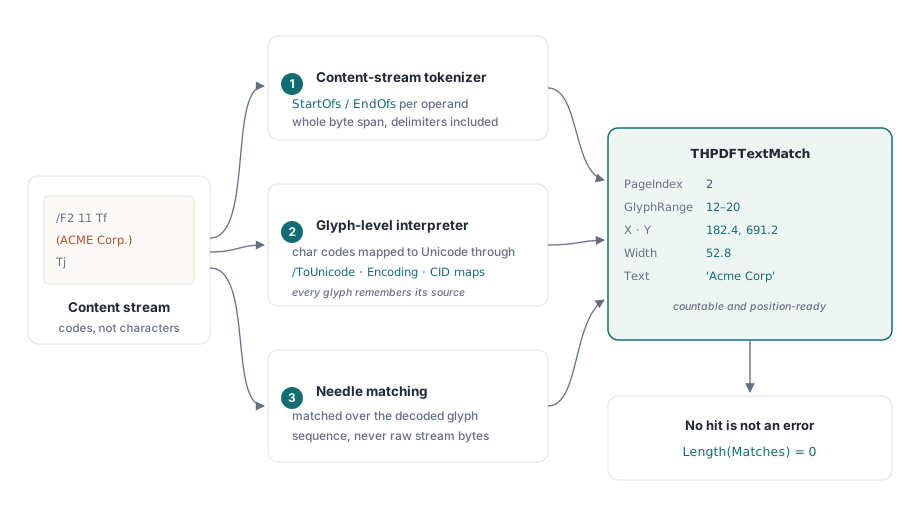
Minden találat egy THPDFTextMatch rekordként érkezik vissza, amely hordozza az oldalindexet, a zárt glifatartományt, a találat felhasználói tér szerinti X/Y kezdőpontját és szélességét, a forrástoken és -elem indexét, valamint magát az illeszkedő szöveget. Ez elég ahhoz, hogy kiemelőréteget, ellenőrző felületet vagy a cserelépést hajtsa meg. Az a keresés, amely semmit nem talál, üres tömböt ad vissza hibajelzés helyett, így a hívási minta egyszerű marad
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
Egy szándékos tervezési döntés külön megjegyzést érdemel. Amikor a CaseSensitive értéke False, az összehasonlítás szándékosan csak az ASCII karakterek kis- és nagybetűit vonja össze: a teljes Unicode kis-nagybetű-összevonás eltérően viselkedik a HotPDF által támogatott Delphi 5 – XE eszközláncokon, és az a kereső API, amely attól függően talál más-más egyezéseket, hogy melyik fordító készítette az alkalmazását, rosszabb annál, amelynek dokumentált, kiszámítható korlátja van. A latin betűs üzleti szövegeknél — nevek, kódok, dátumok — az ASCII-összevonás lefedi a gyakorlati eseteket
Szöveg cseréje: fordított kódolás és sebészi beillesztés
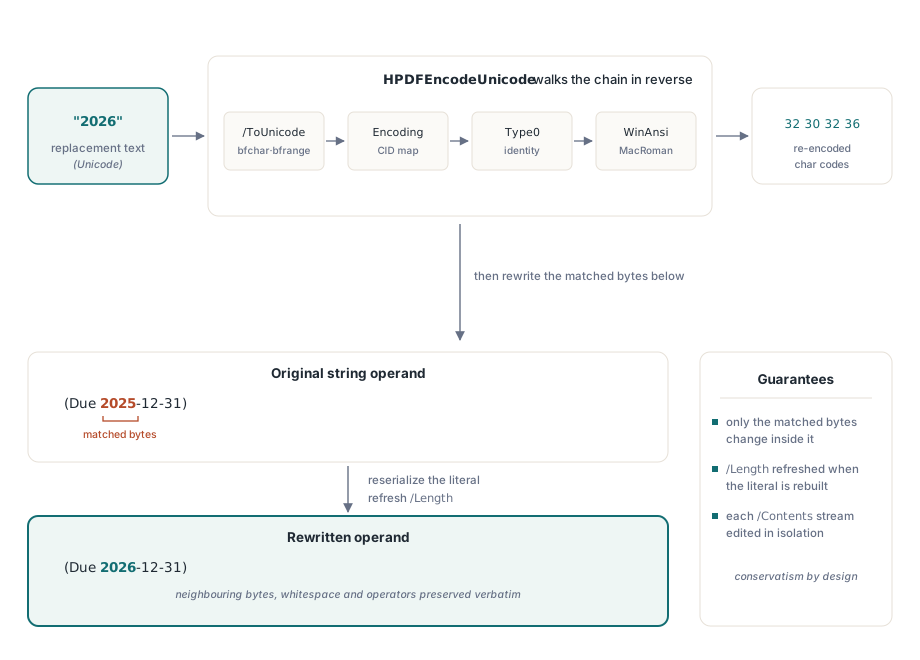
A HotPDF v2.252.0 verziójában megjelent ReplaceLoadedDocumentText úgy írja át a keresett minta minden előfordulását, hogy visszafelé futtatja a dekódoló gépezetet. A HPDFEncodeUnicode függvény a karakterkód-dekódoló inverze: ugyanazt a stratégialáncot járja be fordított irányban — /ToUnicode bfchar és bfrange keresés, kódolási adatfolyam CID-leképezése, Type0 identitásleképezések, valamint az előre definiált WinAnsi és MacRoman táblák —, hogy minden csere-karaktert visszaalakítson azokká a karakterkód-bájtokká, amelyeket az eredeti betűtípus vár. Az újrakódolt bájtok ezután jól formált karakterlánc-literállá vagy hexadecimális karakterlánccá sorosodnak, tükrözve magának a tokenizálónak az escape-szabályait, hogy az elemzés → újrasorosítás körút stabil legyen
Maga a beillesztés sebészi, nem pedig nagybani. A karakterlánc-operanduson belül csak a találat által lefedett kódbájt-tartomány cserélődik; az ugyanabban az operandusban lévő nem illeszkedő bájtok, a tokenek közötti szóközök és minden környező operátor bájtról bájtra változatlan marad. A bca cseréje az abcabc szövegben a + csere + bc eredményt ad, nem szétvert operandust. A csere lehet rövidebb vagy hosszabb is a keresett mintánál — a literál újrasorosodik, és az adatfolyam /Length értéke frissül —, és egy többfolyamos oldal minden /Contents adatfolyama elkülönítve dolgozódik fel, hogy az oldal jól formált maradjon
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Vegye észre, mit nem tesz meg az API: nem szedi újra az oldalt. A PDF-ben nincs újratördelés, így az a csere, amely vizuálisan szélesebb az eredetinél, egyszerűen több vízszintes helyet foglal el, és összezsúfolhatja azt, amit tőle jobbra festettek ki. Az azonos vagy közel azonos hosszúságú helyettesítések — dátumok, verziószámok, cikkszámok, névjavítások — jelentik az édes pontot. A nagybani újrafogalmazás a forrásdokumentumba való, nem a PDF-be
Miért nem cserélhető a szöveg olyan karakterekre, amelyeket a betűtípus-részhalmaz sosem tartalmazott?
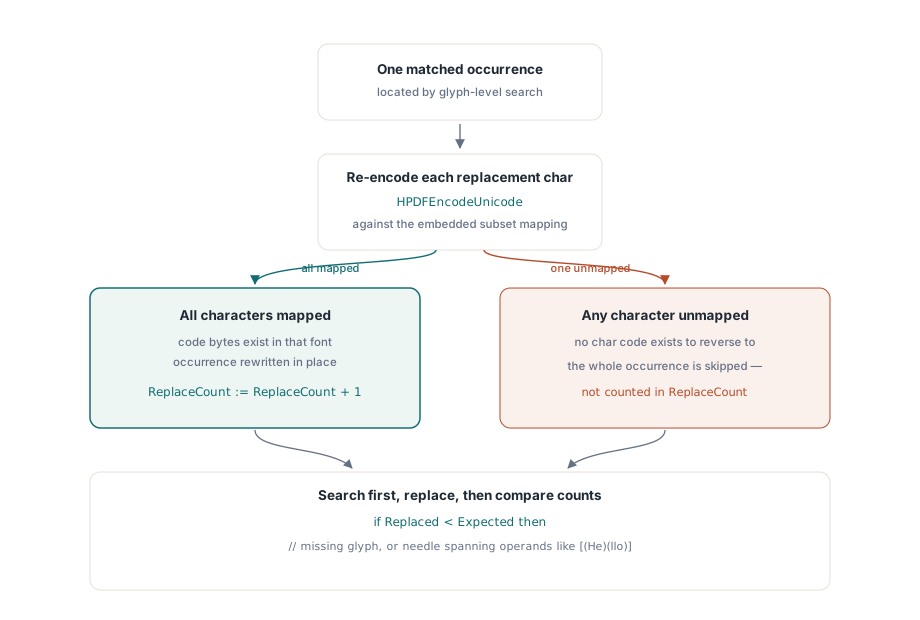
Azért nem cserélheti le a szöveget olyan karakterre, amelyet a beágyazott betűtípus-részhalmaz sosem tartalmazott, mert az a bájtsorozat, amely azt a karaktert kiválasztaná, egyszerűen nem létezik a betűtípus leképezési tábláiban. Amikor egy PDF-előállító részhalmaz-betűtípust ágyaz be, annak /ToUnicode CMap-je és kódolási szerkezetei csak azokat a glifákat fedik le, amelyeket az eredeti dokumentum ténylegesen használt. A HPDFEncodeUnicode csak olyan leképezést tud megfordítani, amely jelen van: ha a dokumentumban abban a betűtípusban soha nem szerepelt az E betű, akkor nincs karakterkód, amelyre az E visszavezethető lenne. Ez a fájl fizikai tulajdonsága, nem egy adott könyvtár korlátja — egyetlen eszköz sem tud olyan glifaleképezést előhúzni, amelyet soha nem ágyaztak be
A HotPDF óvatosan kezeli a sikertelenséget. Ha a csere akár egyetlen karaktere sem kódolható újra, a keresett minta teljes előfordulása kimarad — nincs kivétel, nincs részleges zagyvaság, és az előfordulás egyszerűen nem számít bele a ReplaceCount értékébe. A gyakorlati következmény: vesse össze a ReplaceCount értéket egy megelőző keresés találatszámával, és tekintse a hiányt jelzésnek. A fenti dátumpéldában a 6 számjegynek szerepelnie kell valahol a dokumentum szövegében ugyanazzal a betűtípussal, hogy az átírás sikerüljön — egy számlán ez valószínű, általánosságban soha nem garantált. Amikor a szükséges karakterek egyszerűen nem állnak rendelkezésre, és a cél inkább érzékeny szöveg eltávolítása, mint átfogalmazása, a valódi tartalomeltávolítás amúgy is jobb eszköz; ehhez az útvonalhoz lásd a betöltött PDF-ek kitakarásáról és átszerkesztéséről Delphiben szóló cikket
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
Az üzenetben szereplő második kihagyási feltétel a másik dokumentált határ: az a keresett minta, amely több karakterlánc-operanduson ível át — például a [(He)(llo)] TJ elemek között szétvágott Hello —, a keresés számára megtalálható, mert a keresés a dekódolt glifasorozathoz illeszt, a csere viszont kihagyja, mert az operandushatárokon átnyúló átírás szomszédos bájttartományok összevonását igényelné. A keresés–majd–ellenőrzés menete mindkét korlátot láthatóvá teszi ahelyett, hogy csendben maradnának
Mi változik a fájlban mentéskor?
A lecserélt /Contents adatfolyam tömörítetlenül mentődik. A FlateDecode-dal tömörített adatfolyamok a szerkesztéshez kicsomagolódnak, és amikor a HotPDF kiírja az újraépített bájtokat, elhagyja az adatfolyam /Filter bejegyzését, és frissíti a /Length értéket ahelyett, hogy újratömörítene. Az így kapott PDF teljesen érvényes, és a mainstream megjelenítőkben normálisan renderelődik; a kompromisszum minden szerkesztett adatfolyamnál nagyobb fájlméret. Egy több ezer dokumentumot feldolgozó kötegelt folyamatnál tervezzen ezzel a növekedéssel, vagy futtasson külön tömörítési menetet a lánc végén. Hogy az átírt objektumok mentéskor hogyan hatnak a dokumentum kereszthivatkozási szerkezetére, az önálló téma, amelyet az objektumfolyamokról és inkrementális frissítésekről a HotPDF-ben szóló cikk tárgyal
A fájl minden más része érintetlen marad. Az érintetlen adatfolyamok megtartják a tömörítésüket, a betűtípusok és a képek nem íródnak újra, az operandusszintű beillesztés pedig azt jelenti, hogy még a szerkesztett adatfolyamok is csak ott térnek el az eredetitől, ahol találat volt. Ez az óvatosság szándékos: minél többet ír át egy könyvtár egy betöltött dokumentumból, annál több alkalma van elrontani egy olyan előállítói furcsaságot, amelyre nem számított
A szövegkeresés és -csere a kinyeréshez, a kitakaráshoz és az oldalrendereléshez csatlakozik a HotPDF betöltött dokumentumokra szánt eszközkészletében; mindegyiket ugyanaz a tartalomfolyam-értelmező hajtja, és Delphi 5-től a jelenlegi RAD Studio kiadásokig külső függőségek nélkül elérhető. A teljes API-referencia és a próbaverzió letöltése a HotPDF Delphi Component termékoldalán található