Amikor egy PDF nem ágyaz be fontot, a HotPDF komponens azt a szöveget egy telepített Windows fonttal rendereli, amit az HPDFMapBaseFontToSystem választ ki: dekódolja a /BaseFont nevet, leveszi a stílus részt, több helyesírást kipróbál, amíg a GDI meg nem erősíti, hogy a család telepítve van, a hiányzó standard 14 szélességeket metrikailag kompatibilis fontokból méri, és az egybájtos kódokat Unicode-ra alakítja rajzolás előtt. Ezek a lépések mindegyike azért létezik, mert a naiv verzió valódi fájlokon bukott el. A RenderLoadedPageToBitmap oldalrenderelő a beágyazott programokkal jól boldogul; ez itt azoknak a fontoknak a története, amik a fájlban egyáltalán nincsenek benne
Miért rajzol a GDI csendben rossz betűtípust nem beágyazott fontnál?
A GDI sosem jelenti a hiányzó fontot: adj át a CreateFontIndirect-nek egy ismeretlen betűtípusnevet, és csendben helyettesítőt választ, gyakran egy másik szerifet, vastag változat nélkül. A korai renderelő a PDF nevet majdnem szó szerint adta tovább, így a TimesNewRoman,Bold, a TimesNewRomanPS-BoldMT és a SegoeUI-Semibold semmihez sem illeszkedett, és abban jelent meg, amit a GDI választott. A nevek lehetnek rosszabbak is ennél. Az ISO 32000-1 §7.3.5-e megengedi, hogy egy név bármilyen bájtot #xx alakban írjon, és a CJK producerek rutinszerűen escape-elt UTF-8-ként vagy legacy kódlap bájtokként írják a fontneveket; a v2.766.69 előtt maguk az escape-ek lettek a betűtípusnév. Az HPDFMapBaseFontToSystem mostantól előbb dekódolja az escape-eket, érvényes UTF-8 bájtsort ad vissza karaktereinek, és a többi magas bájtot a rendszer kódlapján olvassa
A stílus levágása az a hely, ahol a heurisztikák beleharapnak. Egy vessző mindig lezárja a családot (a Arial,Bold Arial-t ad), a kötőjel viszont csak akkor, ha az utána álló szó stílus: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra vagy Condensed. Ez a szabály a MS-Mincho-t egészben hagyja, miközben a Calibri-Light-ból Calibri lesz. A HotPDF ezután a család helyesírásait próbálja, majd a PSMT, MT vagy PS utótag levételével kapott helyesírásokat. A v2.768.18 óta ezek a helyesírások lefedik a szóköz minden választását azokon a helyeken, ahol szó kezdődhet: kisbetűt követő nagybetű előtt (a MyriadPro Myriad Pro lesz), kisbetűt követő futam utolsó nagybetűjénél (UIGothic), valamint vezető MS után (MSPGothic), a teljesen szóközöstől a leírt alakig; négy ilyen hely felett csak a teljesen szóközös és az összefűzött nevet próbálja. A szóközöket nem lehet vakon betenni, mert a Windows néhány szót összefűve tart: a SimSun pontosan ebben a helyesírásban van telepítve, a MicrosoftYaHei, a MicrosoftJhengHei és a MSPGothic viszont a Microsoft YaHei, Microsoft JhengHei és MS PGothic nevekhez tartozik. A v2.768.18 előtt a mapper minden belső nagybetű elé tett szóközt, így a MicrosoftYaHei Microsoft Ya Hei-ként keresődött, és sosem találták meg. Egy jelölt akkor számít telepítettnek, ha a CreateFontIndirect utáni GetTextFace a kért nevet adja vissza, vagy, a v2.768.18 óta, ha a kiválasztott font name táblája családként, teljes vagy tipográfiai családnévként bármilyen nyelven felsorolja; a válasz névenként kerül cache-elve, így a sok nem telepített fontot használó dokumentumok már nem kérdezik le a Windowst minden névre minden oldalon
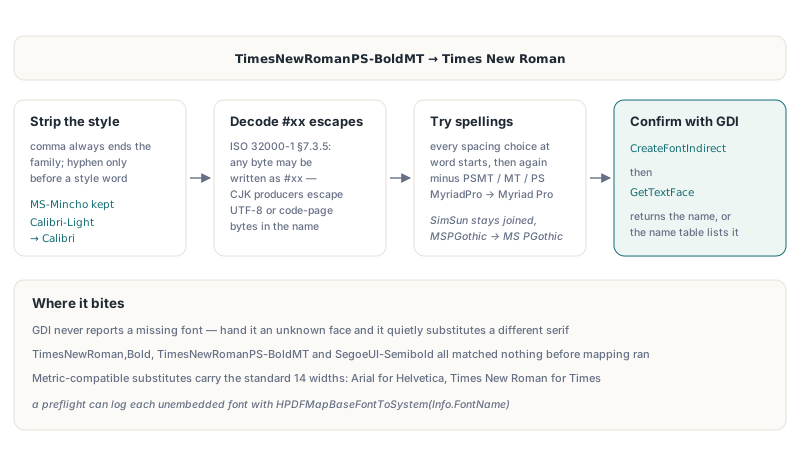
Mivel a leképező függvény nyilvános a HPDFRenderFontMetrics unitban, egy preflight riport megmutathatja, melyik telepített családdal fog renderelődni minden nem beágyazott font, a font felsorolással, amit a THotPDF már kínál betöltött dokumentumokhoz:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
Hogyan méri a HotPDF a /Widths nélküli standard 14 fontokat?
A HotPDF a hiányzó advance-eket a telepített, azonos metrikájú fonton méri, mert az ISO 32000-1 §9.6.2.2-e megengedi a standard 14 fontoknak a /Widths elhagyását, és a library nem szállít AFM táblákat. Az Arial Helvetica metrikákat hordoz, a Times New Roman a Times-t, a Courier New a Courier-t, így az HPDFMeasureBaseFontWidths a megfelelő betűtípust lfHeight = -1000 mellett hozza létre, és a GetCharWidth32W-t hívja; ezen a magasságon az eredmény már a PDF szélességek 1/1000 em egységeiben áll. A renderelő előbb minden kódot Unicode-ra fordít a /Encoding, a /BaseEncoding és a /Differences mentén, StandardEncoding alapbeállítással. Az SVG export és a szövegkinyerés egy további csapdába botlott: egy teljesen /Encoding nélküli standard Type 1 font olyan dekódert gyártott, aminek nem volt kódolási információja, az SVG export nem regisztrálta, és minden mért szélesség felhasználatlan maradt. A becsült StandardEncoding megadása megjavította, feltéve, hogy előre definiált kódolásként van megjelölve; a CMap-név útvonalra terelve minden kód 0-ként dekódolódik, és minden szélesség utána megy
Bold, italic és egy off-by-one a font descriptor flagekben
A font descriptor /Flags bejegyzése a biteket 1-től számozza, nem 0-tól, így a ForceBold a 19. bit ($40000), az Italic a 7. bit ($40), az ISO 32000-1 123. táblázata szerint. A régi kód a $20000-t tesztelte, ami a 18. bit, a SmallCap. A hiba a v2.345.0-tól a v2.766.53-ig túlélte magát, mert a /FontDescriptor szinte mindig indirekt hivatkozás, és a font építő csak direkt objektumokat olvasott, így maga a flags ág sosem futott le, és ugyanez a vakság figyelmen kívül hagyta a /Widths 12 0 R-t is, és 500 egységes tartalék advance-szel szedte a szöveget. Amint a v2.766.53 elkezdte az indirekt hivatkozásokat feloldani a renderelőn át, a bitet ugyanabban a változtatásban kellett korrigálni, különben minden kis kapitális betűtípus hirtelen vastagon renderelődött volna:
const
  // Az ISO 32000-1 123. táblázata 1-től számolja a bitpozíciókat
  FD_ITALIC     = $00040;  // 7. bit
  FD_SMALLCAP   = $20000;  // 18. bit, nem súly
  FD_FORCEBOLD  = $40000;  // 19. bit

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;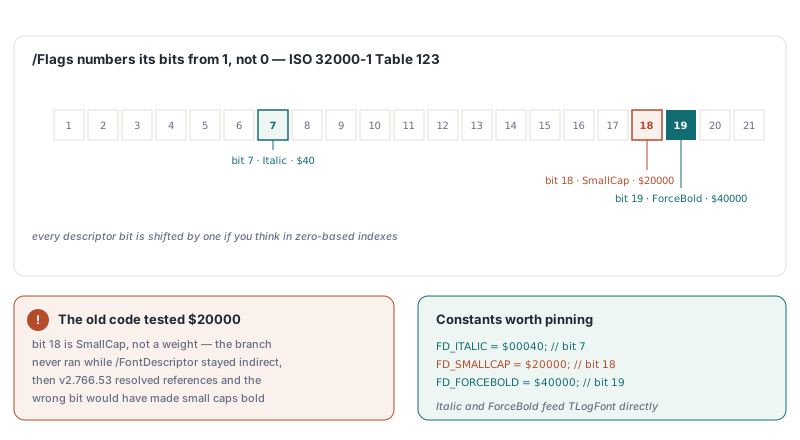
Miért kapnak rossz szélességeket a UCS2 CMapos CJK fontok?
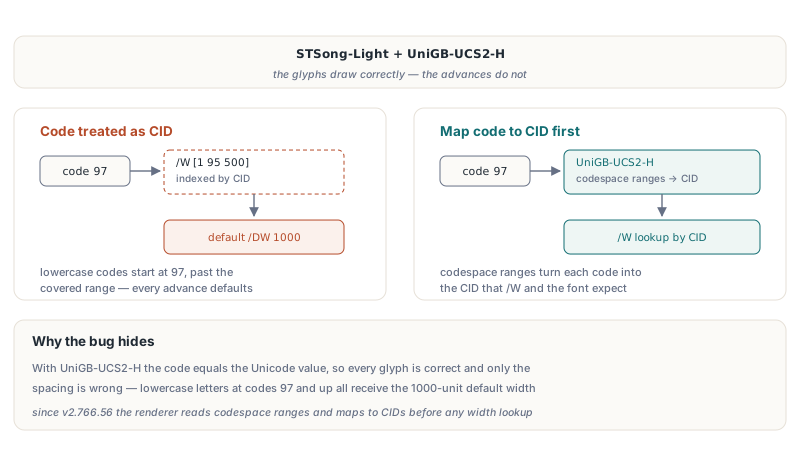
Az előre definiált UCS2 CMapos CJK szöveg a jó glyphokat rajzolja rossz távolságokkal, amikor egy renderer a kódot CID-ként kezeli, mert a /W CID szerint indexel, nem karakterkód szerint. STSong-Light és UniGB-UCS2-H mellett a kód véletlenül egyenlő a Unicode értékkel, így a GDI a helyes karaktereket rajzolja, és a hiba az advance-ekben rejtőzik: a kisbetűk 97 és afölötti kódokként érkeznek, kiesnek egy [1 95 500] alakú /W bejegyzésből, és mind megkapja az 1000-es alapértelmezett /DW szélességet. A v2.766.56 óta a HotPDF renderelő a kódokat a CMap codespace tartományain át olvassa (ISO 32000-1 §9.7.6.2), és CID-ekre képezi őket, mielőtt szélességeket keresne. Csak a beépített UCS2 és UTF16 táblákat és a beágyazott CMap streameket használja; egy GBK-EUC-H jellegű dolog identity közelítése csak annyit tenne, hogy támogatottnak látszik rossz kimenet mellett, ezért a renderelő nem színlel
Miért válnak kérdőjelekké az ékezetes karakterek kínai Windowson?
Az egybájtos kódok sosem érhetik el az ANSI („A") GDI függvényeket, mert a GetGlyphOutlineA és a GetGlyphIndicesA a bájtokat a rendszer kódlapján értelmezi, miközben a TextOutA a kijelölt font karakterkészletét használja. Kínai rendszeren az Arial $A9 bájtja (a szerzői jog jel a Windows-1252-ben) GBK vezérbájttá vált, és „?"-ként renderelődött, egy csapda, amibe a v2.766.83-ban hozzáadott, nem hintelt körvonalas útvonal egyenesen belesétált. A v2.767.3 a GetTextCharset-tel kérdezi le a megvalósult font karakterkészletét, TranslateCharsetInfo-val alakítja kódlappá, a bájtot MultiByteToWideChar-en viszi át, és a W függvényeket hívja; a szimbólum fontok helyette U+F000-et használnak plusz a kódot. A Windows-1252-vel ellentmondó kódolások — /Differences, StandardEncoding, MacRomanEncoding — bármilyen rendszerfont előtt Unicode-ra képeződnek
Mik a rendszerfonttal rajzolás határai?
A rendszerfontos renderelés közelítés, és a HotPDF komponens őszintén kezeli, hol áll meg. A v2.768.18 előtt a telepítettség-ellenőrzés csak azt a nevet hasonlította, amit a GetTextFace visszaad, és lokalizált Windowson ez a függvény a családnevet a rendszer nyelvén jelenti, így a Microsoft YaHei kínai Windowson vagy a Yu Mincho japán Windowson hiányzóként ítéltetett meg, és GDI helyettesítővel rajzolódott; a v2.768.18 óta egy másik néven visszatérő betűtípust is megkeresnek a font name táblájában, és az ilyen fontok megtalálódnak. A metrikai kompatibilitás csak a Helvetica, Times és Courier családokra garantált; a Symbol a Symbolra, a ZapfDingbats a Wingdingsre képeződik, ami megoldás helyett tűzoltás. A fenti preflight is csak az oldalankénti /Resources szótárak fontjait látja, nem a form XObjectekből hivatkozottakat. Ha egy kód továbbra sem rajzolható, azt a rajzoláskori feloldatlan glyph követés jelenti, ami jobb jel, mint a bélyegkévek megpillantása
A tartós javítás a szerzői oldalon ül. A HotPDF maga FontEmbedding True alapértelmezéssel ír, beágyazott Arialt helyettesít be akkor is, ha a kód SetFont-tal Helvetica-t kér, és a beágyazott szöveg a fenti találgatások helyett a beágyazott font glyph renderelőn megy át. Egy olcsó őrző a bejövő fájlokhoz: figyelmeztetés renderelés előtt, ha egy leképzett család nincs a képernyő font listájában:
// VCL: a Screen.Fonts felsorolja a telepített családneveket (Forms unit)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
A teljes komponensért, az oldalrendereléssel, szövegkinyeréssel és az író oldali font szubsettinggel együtt, lásd a HotPDF Delphi PDF component termékoldalát