Amikor a HotPDF Delphi Component betölt egy PDF 1.5 fájlt a LoadFromFile-fal, nem parse-olja az /Type /ObjStm konténerekbe csomagolt objektumokat. Feljegyzi, hol lakik minden tömörített tag, és csak akkor parse-olja, amikor valami kéri. Ez a lusta invariáns tartja a betöltési időt azzal arányosnak, amihez tényleg hozzányúlsz, és ez az oka annak is, hogy egy teljes újraírásnak van egy plusz feladata, mielőtt bármilyen bájt kimegy: ki kell csomagolnia minden még nem parse-olt tagot, mert az újraírás épp eldobni készül azokat a konténereket, amikben azok a tagok élnek
A tünet, ami ezt a jegyzetet kiváltotta, könnyen leírható és kellemetlen debuggolni. Tölts be egy fájlt, aminek a betűkészletei, színterei és struktúrafája objektumstreamekben ülnek, futtasd át a BeginDoc és EndDoc generálási páron, és a kimenet panasz nélkül megnyílik. Az oldalszám helyes, a szöveg látható azokon az oldalakon, amiket szemrevételezel. Aztán egy kolléga megnyitja a 40. oldalt, és a törzsszöveg egy helyettesített betűkészlettel renderelődik, vagy az Extract Text parancs szemétnyi eredményt ad ott, ahol korábban egy ActualText helyettesítés volt. Semmi nem crashelt. Az író egyszerűen sorosított egy objektumot, amit soha nem töltött be, egy betöltetlen objektum pedig semmiként sorosul
Mit tart meg valójában a LoadFromFile egy tömörített objektumhoz?
Minden 2-es típusú cross-reference bejegyzéshez a LoadFromFile egy kis rekordot tart az FCompactObjects-ban: az objektumszámot, a tartalmazó stream indexét a konténertáblában, a tag pozícióját azon a streamen belül, és egy ParsedObject pointert, ami nil-ként indul. Maga a konténer lokalizálódik, titkosított dokumentum esetén visszafejtődik és kifújódik, a tagok törzsei viszont bájtokként maradnak. Az ISO 32000-1 §7.5.7 definiálja azt a konténerelrendezést, ami ezt lehetővé teszi: egy fejlécet objektumszám- és eltoláspárokból, majd a /First után összefűzött tagtörzseket, így bármely tag kivágható anélkül, hogy a szomszédjaihoz hozzányúlnánk
Az EnsureCompressedObjectLoaded az egyetlen útvonal, ami egy rekordot objektummá alakít. Megkeresi a rekordot objektumszám szerint, és ha a ParsedObject már be van állítva, visszaadja azt a cache-elt objektumot, és számol egy cache-találatot. Máskülönben újratölti a konténert, ha az kiesett, kiszámolja a tag bájttartományát az eltolástáblából, egy nulla másolású nézetet ad a parsernek arról a szeletről, és az eredményt visszateszi a rekordba. Onnantól az objektum indirekt, hordozza a valódi objektumszámát, és regisztrálódik a dokumentum objektumindexében, mint bármely objektum, amit a fájltörzsből parse-oltak. A katalógus, az info dictionary, az oldalfa gyökere és az oldalobjektumok betöltéskor mennek át ezen az útvonalon, mert a navigációnak szüksége van rájuk. A betűkészletek, a színterek, az ExtGState szótárak és a struktúraelemek nem, és rekordként maradnak, amíg egy oldalrenderelés vagy egy újraírás hozzájuk nem nyúl
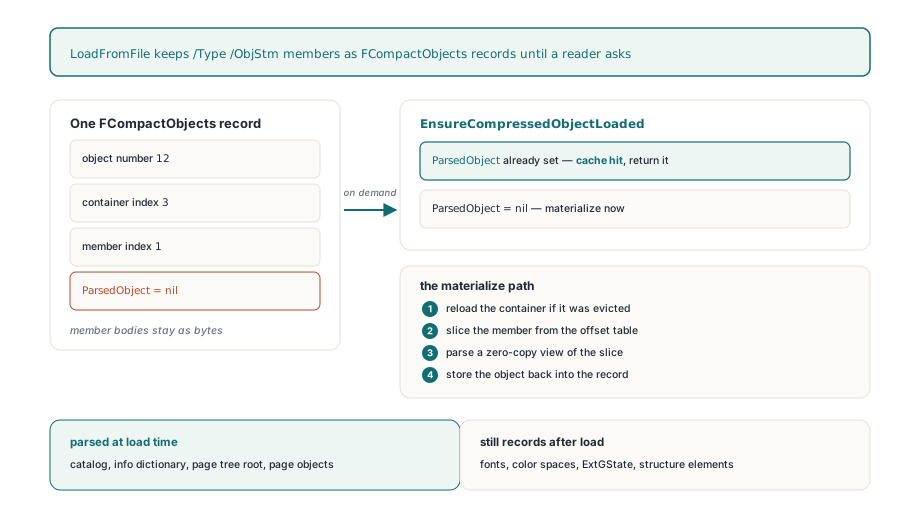
Ezt kívülről is megfigyelheted. A GetLoadedObjectStreamCacheInfo megmondja, hány konténer létezik, hány tag indexelődött, és ezek közül hány parse-olódott eddig:
var
  Pdf: THotPDF;
  Info: THPDFObjectStreamCacheInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    Pdf.LoadFromFile('tagged-report.pdf');
    if Pdf.GetLoadedObjectStreamCacheInfo(Info) then
      Writeln(Format('%d containers, %d members indexed, %d parsed so far',
        [Info.ContainerCount, Info.IndexedObjectCount,
         Info.MaterializedObjectCount]));
  finally
    Pdf.Free;
  end;
end;
Egy struktúranehéz fájlon a harmadik szám közvetlenül betöltés után a másodiknak egy kis töredéke. Ez a rés a lusta betöltés egész lényege, és egyben pontosan az az objektumhalmaz, amiért egy teljes újraírásnak vissza kell mennie
Miért dob el egy teljes újraírás olyan betűkészleteket, amiket egy inkrementális mentés megtart?
Egy teljes újraírás eldobja a forrásfájl /ObjStm és /XRef konténereit, és a nulláról sorosítja újra az objektumgráfot, így minden olyan tagnak, aminek a ParsedObject mezője még nil, nem marad reprezentációja a kimenetben. Egy inkrementális frissítésnek soha nincs ilyen problémája, mert az új objektumokat az eredeti bájtok után fűzi hozzá, a régi konténereket pedig a helyükön hagyja, hogy az előző cross-reference szakasz címezhesse őket. A különbség nem abban van, hogyan kezeli a két mód a betűkészleteket. Hanem abban, hogy az eredeti konténerek túlélik-e, hogy a következő megjelenítő elolvashassa őket
A javítás a SaveToStream-ben él, abban a szerializálóban, amit az EndDoc meghajt, akár a FileName-t, akár az OutputStream-et állítod be. Mielőtt bármelyik íróágra szétágazna, bejárja az FCompactObjects-ot, és minden bejegyzésen meghívja az EnsureCompressedObjectLoaded-et. Ha egy tagot nem lehet betölteni, a mentés kivételt dob a folytatás helyett, mert egy újraírás, ami csendben eldob egy font dictionaryt, rosszabb, mint egy, ami megáll. A kicsomagolásnak azon a szinten kell ülnie, a classic, a packed és a linearized ágak felett, valamint a linearized útvonal újratöltött strukturális streamjeinek kimetélése felett is. Egy korábbi verzió csak a SaveLoadedDocument-en belül csomagolta ki a tagokat, ami lefedte a betöltött dokumentum szókincsét, de a generálási szókincset teljesen kihagyta. A LoadFromFile, majd BeginDoc, oldalszerkesztések és EndDoc egyenesen az íróhoz ment úgy, hogy minden érintetlen tag parse-olatlan maradt
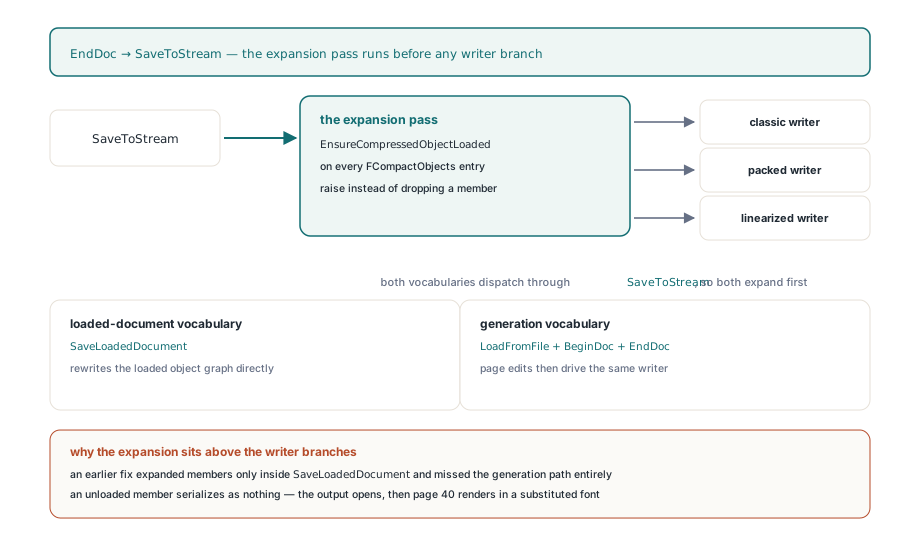
// Mindkét újraírási szókincs kicsomagolja a kompakt tagokat, mielőtt bármelyik író fut.
// Betöltött dokumentum útvonala:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.SaveLoadedDocument('quarterly-rewritten.pdf');

// Generálási útvonal egy betöltött fájl fölött:
Pdf.LoadFromFile('quarterly.pdf');
Pdf.FileName := 'quarterly-stamped.pdf';
Pdf.BeginDoc;
Pdf.CurrentPage.SetFont('Arial', [], 9);
Pdf.CurrentPage.TextOut(40, 20, 0, 'Reviewed 2026-09-11');
Pdf.EndDoc;   // a SaveToStream előbb materializál minden FCompactObjects bejegyzést
A cache-elt tagok megtartják mindazt, amit tettél velük. Egy objektum, amit a mentés előtt parse-oltak, szerkesztettek és piszkosnak jelöltek, a szerkesztéseivel együtt jön vissza a cache-ből, egy törölt tag pedig megőrzi a törlési állapotát az ismételt mentések során. A kicsomagolási menet konstrukció szerint idempotens: soha nem tesz mást, mint nil helyeket tölt fel
Miért hagyják ki a háromoldalas pixel-ellenőrzések az ActualText esetet
A struktúraelemek azok, ahol ez a hiba a legtovább rejtőzik. Egy megjelölt-tartalom sorozaton lévő ActualText bejegyzés, amit az ISO 32000-1 §14.9.4 definiál, kicseréli a glifákat a kinyeréshez és az akadálymentesítéshez, de nem érinti a renderelést. Ha a struktúraelem objektumstreamben él, és az újraírás elveszíti, az oldal továbbra is helyesen rajzolódik, az első, a középső és az utolsó oldal pixelre pontosan megegyezik a forrással, a regresszió pedig csak akkor jelenik meg, amikor valaki szövegkinyerést vagy felolvasót futtat. Egy újraírásteszt, ami csak oldalakat renderel, nem újraírásteszt taggelt PDF-hez. Diffeld a kinyert szöveget és a struktúrafát is
Hogyan változtatja meg egy üres felhasználói jelszó a betöltést?
Egy üres felhasználói jelszó is azt jelenti, hogy a fájl titkosított, és egy ilyen fájlban az objektumstreamek rejtjelezett szövegek mindaddig, amíg a fájlkulcs helyre nem áll. Az ISO 32000-1 §7.6.3.4 2. algoritmusa a jelszóból, az /O bejegyzésből, a /P-ből és az első dokumentumazonosítóból vezeti le azt a kulcsot, és a HotPDF-nek le kell futtatnia az üres stringre, mielőtt a 2-es típusú menet egyetlen konténert is kifújhatna. Ezért hívja a BeginDoc egy betöltött titkosított dokumentumon a DecryptLoadedDocument-et üres jelszóval mindenek előtt: az objektumgráfnak hitelesítettnek és visszafejtettnek kell lennie, mielőtt egy újraírás elkezdődhet, függetlenül attól, hogy a hívó szándékozik-e védeni a kimenetet. A kimenet titkosítása külön döntés, amit a hívó védelmi beállításai vezérelnek, és a BeginDoc a visszafejtési menet után visszaállítja azokat a beállításokat, hogy egy titkosított bemenet ne váljon csendben titkosított kimenetté
A konténerpolitika az /Encrypt szótárból olvasódik, mielőtt bármilyen jelszót megpróbálnánk. /V 1 és 2 esetén minden stream a fájlkulccsal titkosított. Crypt filtereknél a HotPDF a /StmF-et a /CF-en keresztül oldja fel: egy Identity filter vagy egy None /CFM nyílt szövegű konténereket jelent, a V2 és az AESV2 pedig titkosítottakat. A válasz az FReloadObjectStreamsEncrypted-be kerül, és egy konkrét esetben számít. Amikor a konténerek nyílt szövegűek, a stringek viszont nem, a tagok titkosított stringeket hordoznak, amiket egyenként kell visszafejteni, ezért a MaterializeMembersOfPlaintextObjectStreams minden kompakt tagot kicsomagol az objektumonkénti visszafejtési menet előtt. Semmit nem tesz, amikor a politika még nem ismert, és semmit, amikor maguk a konténerek voltak titkosítottak, mert egy titkosított konténer tagjai már vele együtt visszafejtődtek, és soha nem szabad kétszer visszafejteni őket
Mi történik, amikor egy konténer nem fejthető vissza?
Egy konténer, aminek a visszafejtése elbukik, karanténba kerül, nem végzetes. A 2-es típusú menet egy THPDFObjStmQuarantineInfo bejegyzést rögzít az FObjStmQuarantine-ban a konténer objektumszámával, egy THPDFObjStmQuarantineReason értékkel, egy diagnosztikai stringgel, és azon tag-objektumszámok listájával, amiket a cross-reference oda irányított. Az osqrDecryptFailed négy különböző helyzetben keletkezik: nem oldható fel crypt filter, az AES-256 vagy AES-GCM visszafejtés dobott, a régi RC4 vagy AES-128 visszafejtés dobott, vagy egyáltalán nincs használható fájlkulcs. A független konténerek tovább töltődnek, így egy dokumentum egy sérült konténerrel is megnyílik, és minden oldalt renderel, ami nem tőle függ
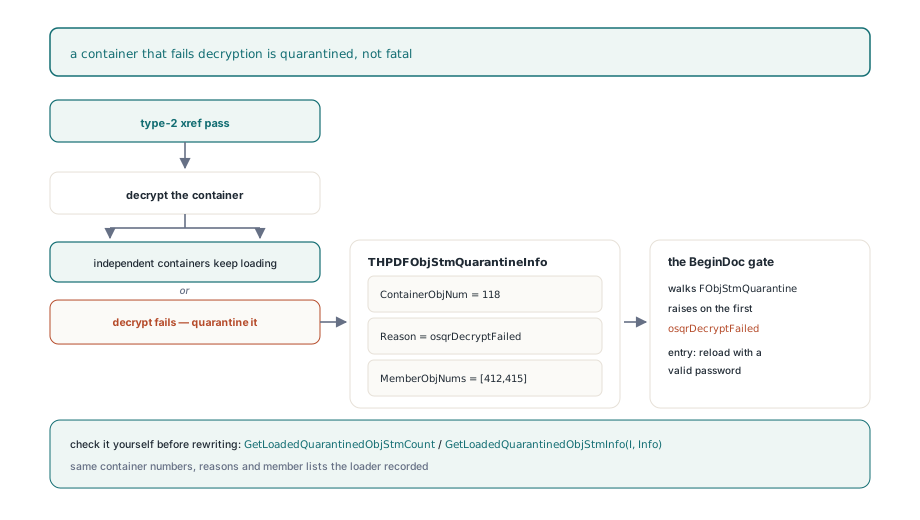
A karanténlista túléli a parser-visszaesést. Ha az elsődleges cross-reference betöltés elbukik, és a HotPDF a fájl pásztázásával rekonstruálja az objektumtáblát, előfordulhat, hogy a titkosított flag nem éli túl azt a rekonstrukciót, a karanténrekordok viszont igen. Ezért ellenőrzi a BeginDoc a karanténlistát a titkosított flag helyett: egy betöltött dokumentumon bejárja az FObjStmQuarantine-t, és az első osqrDecryptFailed bejegyzésen kivételt dob, megnevezve a konténert és érvényes jelszóval való újratöltést kérve. Egy újraírás, ami túlhaladna azon a ponton, azokat a tagokat, amiket a konténernek kellett volna tartania, üres objektumokként írná ki, és sikert jelentene. Ugyanezt az ellenőrzést magad is lefuttathatod, korábban és a saját politikáddal, a nyilvános accessorokon keresztül:
var
  Info: THPDFObjStmQuarantineInfo;
  I: Integer;
begin
  Pdf.LoadFromFile('vendor-form.pdf');   // üres felhasználói jelszó
  for I := 0 to Pdf.GetLoadedQuarantinedObjStmCount - 1 do
    if Pdf.GetLoadedQuarantinedObjStmInfo(I, Info) and
       (Info.Reason = osqrDecryptFailed) then
      raise Exception.CreateFmt(
        'Object stream %d is unreadable (%s); %d members unresolved',
        [Info.ContainerObjNum, String(Info.Diagnostic),
         Length(Info.MemberObjNums)]);
  // innentől biztonságos az újraírás
end;
A fennmaradó karanténok a nem kriptográfiai hibákat fedik: egy konténer, ami nem stream, egy hiányzó szótár, egy érvénytelen /N vagy /First, az elfogadott tartományon kívüli streamméret, egy kitömörítési hiba, egy az adaton túlra mutató /First, vagy egy tagtörzs, ami dekódolódott, de nem parse-olódott. Ezeket érdemes naplózni a betöltéskor, mivel mindegyik megnevezi, pontosan mely tagok fognak hiányozni később
Miért van szüksége egy újraírásnak az eredeti numerikus tokenre?
A HotPDF minden numerikus objektumot Single-ként tárol, és egy Single nem tudja reprodukálni egy valós szám forrásszövegét. Az ISO 32000-1 §7.3.3 megengedi, hogy egy író 0.750000-et, .75-öt vagy 0.75-öt írjon ugyanarra az értékre, és egyik sem éli túl változatlanul a 24 bites binárison és egy általános formázón át vezető oda-vissza utat. Ráadásul egy olyan érték, mint a 0.7, egyáltalán nem ábrázolható Single-ben; a legközelebbi float-ra parse-olódik, és annak a float-nak az újraformázása 0.69999999-et vagy egy kerekített szomszédot adhat a számjegyciklustól függően. Egy kitöltési színnél vagy egy /CA átlátszósági konstansnál ez egy egységnyi eltérés egy 8 bites csatornában, ami elég ahhoz, hogy elbukjon egy pixel-összehasonlítás a forrással szemben, és gradienshatárokon elég ahhoz, hogy látszódjon
A THPDFNumericObject.RememberSourceToken ezt a módosítatlan esetre oldja meg. A parser közvetlenül a Value értékadása után hívja meg a nyers tokennel; a metódus csak számjegyekből, legfeljebb egy tizedespontból és egy opcionális előjelből álló tokeneket fogad el, és a tokent azzal az értékkel együtt tárolja, aminek megfelelt, az FSourceValue-ban. A SourceToken tulajdonság csak addig adja vissza a tárolt szöveget, amíg a Value egyenlő az FSourceValue-val. Változtasd meg a számot, és a token elpárolog, így egy módosított érték mindig a meglévő formázási útvonalon megy át, és soha nem ír ki elavult szöveget. A SaveNumericObject először a SourceToken-t ellenőrzi, és szó szerint kiírja, amikor jelen van, majd csak azokra a számokra esik át az egész, a színtér-referencia és a tört ágra, amiket memóriában hoztak létre vagy szerkesztettek
Az invariáns kicsi, és érdemes egyenesen kimondani: egy szám, amihez nem nyúltál, azokkal a bájtokkal íródik ki, amikkel beolvasták, egy szám, amihez hozzányúltál, pedig a HotPDF saját formázójával. A kompakt tagok ugyanígy profitálnak ebből, mint a törzsbeli objektumok, mivel az EnsureCompressedObjectLoaded ugyanazt a parsert futtatja a tagszeleten. Magát a számformázást és annak függetlenségét a folyamat locale-jától a locale-független PDF-számformázásról szóló cikk tárgyalja
Egy újraírási útvonal tesztelése objektumstreamekkel szemben
Három ellenőrzés elkapja a fent leírt összes hibát, és egyikhez sem kell Acrobat. Először hasonlítsd össze az IndexedObjectCount-ot a MaterializedObjectCount-tal a mentés után; teljes újraírásnál egyenlőnek kell lenniük, és minden rés egy eldobott tag. Másodszor nyerd ki a szöveget és enumeráld a struktúrafát mindkét fájlon, ne csak rendereld őket, hogy egy elveszett ActualText vagy egy elveszett struktúraelem diffként jelenjen meg. Harmadszor töltsd be a kimenetet egy friss példánnyal, és állítsd, hogy a GetLoadedQuarantinedObjStmCount nulla, ami azt is bizonyítja, hogy az író nem állított elő olyan konténert, amit az olvasó nem tud megnyitni. A FReloadObjectStreamsEncrypted-et eldöntő crypt filter kombinációkat a StmF, StrF és EFF politikáról szóló cikk fejti ki. Ennek a történetnek az író oldala, hogyan kell objektumstreameket kibocsátani és mikor érdemes inkrementális frissítést választani egy újraírás helyett, a az objektumstreamekről és inkrementális frissítésekről szóló útmutatóban van
A lusta tagbetöltés, az író előtti kicsomagolási menet, a visszafejtési karantén és a forrástoken megőrzése mind a HotPDF Delphi Component része Delphihez és C++Builderhez. A termékoldal linkeli az API-referenciát, ha a saját betöltési pipeline-od ellenében szeretnéd végigkövetni a GetLoadedObjectStreamCacheInfo-t és a karantén-accessorokat