Van egy PDF-ed a lemezen, az ügyfél egy csomó számláról szkennelt be egy példányt, és a feladatod az, hogy a lapképeket bitképként visszanyerd egy OCR futtatásához. Betöltöd a fájlt, megkeresed a kép XObjecteket, és ekkor jön az a rész, amiről senki nem szól előre: ezekben a streamekben a bájtok nem pixelek. Lehet, hogy JPEG kódfolyamról van szó, lehet JPEG 2000 hullámletörítéssel csomagolt blobról, Group 4 fax futamról, vagy egy paletta mögötti indexed raszterről Flate szűrő mögött. A képtárgy tudja a szélességét és a magasságát, de a tényleges minták az előállító által választott szűrő mögé vannak zárva. Egy használható TBitmap kinyeréséhez ezt a szűrőt vissza kell bontani, és a PDF nagyjából nyolc különböző módot ad arra, hogy a bájtok el legyenek zárva
Ezt a rést tölti be a ExtractLoadedImage a HotPDF-ben, a Delphihez és C++Builderhez készült natív VCL PDF komponensben. Felsorolja egy betöltött dokumentum kép XObjectjeit, megmondja, melyik micsoda, és a dekódolhatókat 24 bites bitképpé alakítja vissza. Az érdekes rész nem is annyira az API felülete, mert az mindössze három metódus. Hanem az, hogy miért kell egy külön dekódolási út egyáltalán, és mit tud, illetve mit nem tud visszafordítani pixelekké
Miért nincs a betöltött kép már eleve dekódolva
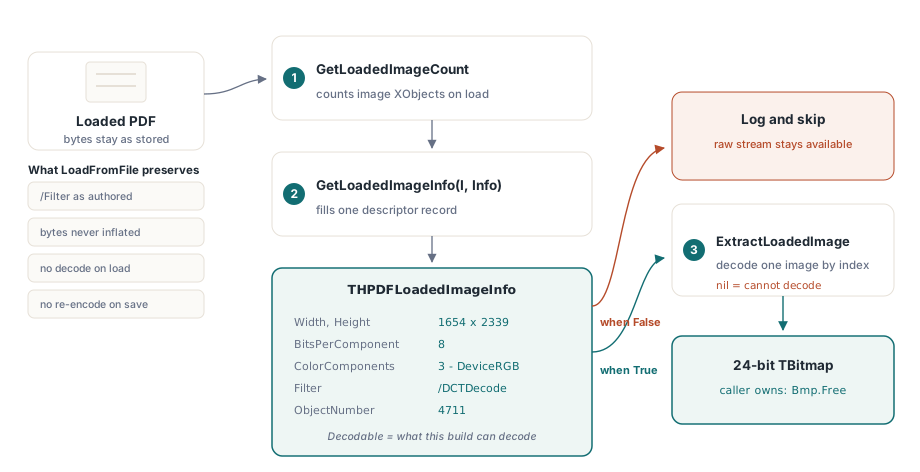
Amikor betöltöd a dokumentumot, a HotPDF a pass-through hűségre épít. A LoadFromFile hívás után a képstreamek pontosan úgy maradnak meg, ahogy a forrásfájlban vannak: az eredeti szűrővel, az eredeti tömörített bájtokkal, az eredeti szótárral. Ez tudatos döntés, mert a dokumentum betöltésének általában az a célja, hogy oldalakat másolj, fájlokat egyesíts, pecsételj, újraengedélyezz és visszaírd őket, és ehhez a legolcsóbb és legbiztonságosabb megoldás az, ha minden képstreamet érintetlenül hagysz. Ha minden képet betöltéskor raszterré bontanál, az rengeteg memóriát és CPU-t fogyasztana olyan munkára, amelyre a legtöbb hívónak nincs is szüksége, a mentéskor pedig újrakódolás rontaná el azokat a képeket, amelyeket eredetileg byte-pontosan kellett volna másolni
Ennek az a következménye, hogy a betöltött objektumgráf nem tartalmaz pixeleket. Egy kép XObject, amelynek /Filter mezője /DCTDecode, JPEG bájtokat tartalmaz; a HotPDF soha nem futtatott rajta JPEG dekódert, mert erre a másoló-és-újraíró útvonalon semmi szükség nem volt. Amikor tehát valóban pixelekre van szükséged, a kinyerő API-nak magának kell elvégeznie a dekódolást, a nulláról, attól függően, hogy az adott kép melyik szűrőt használja. Ugyanezen okból független a kódoló oldali kodekek is a betöltőtől: a JPEG 2000 képek hozzáadása PDF-ekhez Delphiben című cikk azt írja le, hogyan illeszkedik a JPX motor a létrehozási oldalhoz, és ez a motor egyszerűen nem volt bekötve az olvasási útvonalba, amíg a kinyerő API igényelni nem kezdte
A három metódusból álló API
A felület kicsi. A GetLoadedImageCount visszaadja, hány kép XObjectet tartalmaz a betöltött dokumentum. A GetLoadedImageInfo egy leíró rekordot tölt ki index alapján az egyikükhöz. Az ExtractLoadedImage visszaadja a dekódolt bitképet, vagy nil-t, ha nem tudja dekódolni azt a képet. A felsorolás index alapú és stabil egy adott betöltésen belül: belsőleg végigjárja az indirekt objektum táblát, és összegyűjt minden streamet, amelynek /Subtype mezője /Image-re oldódik fel, így a GetLoadedImageInfo-nak átadott index ugyanaz, mint amit az ExtractLoadedImage-nek adsz át
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  Bmp: TBitmap;
  I, Count: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('scanned-invoices.pdf', '') <= 0 then
      Exit;
    Count := Pdf.GetLoadedImageCount;
    for I := 0 to Count - 1 do
    begin
      if not Pdf.GetLoadedImageInfo(I, Info) then
        Continue;
      if not Info.Decodable then
        Continue;                       // a szűrő vagy a színtér nem támogatott
      Bmp := Pdf.ExtractLoadedImage(I);
      if Bmp <> nil then
      try
        Bmp.SaveToFile(Format('img_%d.bmp', [I]));
      finally
        Bmp.Free;                       // a bitkép a hívó felelőssége
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Két szerződési részlet számít itt igazán. Először is, a visszaadott TBitmap felszabadítása a te feladatod; a dokumentum nem gyorsítótárazza és nem birtokolja azt. Másodszor, ellenőrizd a Decodable mezőt hívás előtt, és az eredményt nil-lel szemben hívás után. A metódus nem dob kivételt nem támogatott szűrő esetén, hanem nil-t ad vissza, és egy csendes nil egy kötegelt ciklusban pontosan az a fajta hiba, amely egy ezeroldalas feladatból elnyel egy oldalt anélkül, hogy bárki észrevenné
Az leíró rekord elolvasása dekódolás előtt
A THPDFLoadedImageInfo megmondja, mi egy kép anélkül, hogy teljes dekódolásra kötelezné el magát. Mezői közvetlenül a kép szótárából származnak: Width és Height mintákban, BitsPerComponent, ColorComponents és ColorSpace, amelyek a dekódolás utáni értelmezést írják le (1 szürkéhez, 3 RGB-hez, 4 CMYK-hoz), Filter a megnevezett tömörítés, IsImageMask a sablonmaszkokhoz, ObjectNumber az alapul szolgáló indirekt objektumhoz, és a Decodable
Ez az utolsó jelző az őszinte. A Decodable csak akkor True, ha a futó build ténylegesen képes ezt a konkrét szűrő-és-színtér kombinációt bitképpé alakítani. A valódi támogatási mátrixot kódolja, nem egy kívánságot: az a kép, amelynek Filter mezőjét az aktuális build nem érti, Decodable = False értéket jelent, és ez alapján elágazhatsz naplózásra, kihagyásra, vagy visszaeshetsz arra, hogy a nyers streamet magad nyerd ki. Kezeld előfeltételként, ne csak tippként
// Minden képet triázsolj, mielőtt elköteleződnél a dekódolás mellett.
var
  Pdf: THotPDF;
  Info: THPDFLoadedImageInfo;
  I: Integer;
begin
  // ... Pdf betöltve ...
  for I := 0 to Pdf.GetLoadedImageCount - 1 do
  begin
    if not Pdf.GetLoadedImageInfo(I, Info) then
      Continue;
    if Info.Decodable then
      // ExtractLoadedImage(I) egy TBitmap-et fog visszaadni
    else
      // nem támogatott szűrő/színtér: naplózd az objektumot és hagyd ki
      Writeln(Format('Image %d obj %d: %dx%d %s/%s not decodable',
        [I, Info.ObjectNumber, Info.Width, Info.Height,
         String(Info.Filter), String(Info.ColorSpace)]));
  end;
end;
Egy implementációs részlet megharapja azokat, akik saját kezűleg építenek leíró rekordokat. A THPDFLoadedImageInfo két AnsiString mezőt tartalmaz, Filter és ColorSpace. Ezek referenciaszámlált, kezelt típusok, így az a reflex, hogy a rekordot FillChar(Info, SizeOf(Info), 0) hívással nullázzuk, itt hibás: felülírja a string referenciát anélkül, hogy csökkentené azt, ami szivárgáshoz vagy korrupcióhoz vezet. A HotPDF pontosan emiatt inicializálja a rekordot mezőnként, és ha valaha átveszed ezt a mintát a saját kódodban, tedd ugyanezt
Egy vezérlő, nyolc szűrőút
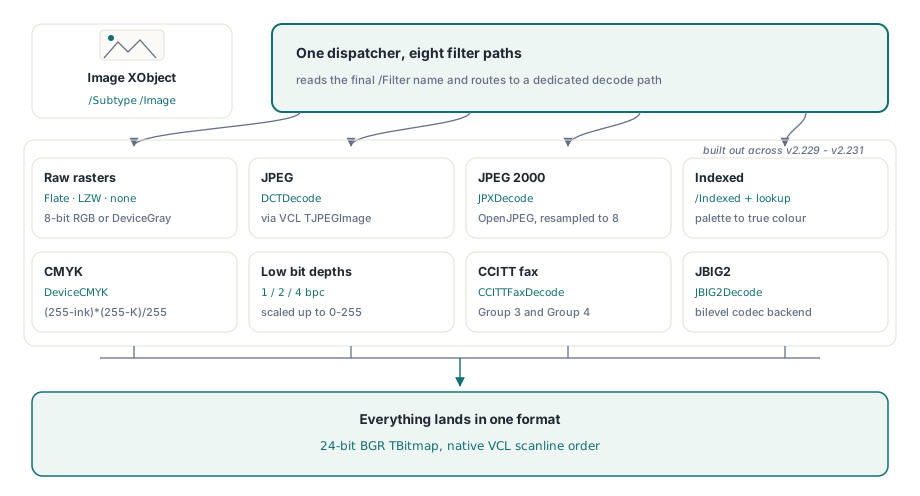
Ez a funkció azért igényelt egy sor kiadást egy helyett, mert a PDF-nek nincs saját képformátuma. Szűrői vannak, és az ISO 32000-1 §8.9.5 szakasza lehetővé teszi, hogy egy kép XObject bármelyiküket megnevezze a /Filter mezőben, míg a minták értelmezését külön a /ColorSpace, /BitsPerComponent és egy opcionális /Decode tömb szabályozza. Az ExtractLoadedImage beolvassa a szűrő nevét, és minden esethez egy dedikált dekóderhez irányít. A támogatott halmaz, amely a v2.229-től a v2.231-ig épült ki, mostanra nyolc különálló útvonalat fed le
- Nyers raszterek (FlateDecode, LZWDecode, vagy szűrő nélkül) 8 bites DeviceRGB vagy DeviceGray formátumban. A bájtok tömörítetlenítve egy csomagolt rasztert adnak, és az egyetlen átalakítás egy csatornacsere, amelyet alább tárgyalunk
- DCTDecode (JPEG). A kódfolyamot a VCL
TJPEGImageosztályának adjuk át, amely feloldja a geometriát és a színt, az eredményt pedig egy 24 bites bitképbe rendeljük - JPXDecode (JPEG 2000). Az OpenJPEG backenden keresztül dekódolva, ugyanazzal a motorral, amelyet a JPEG 2000 cikk ír le, a magas bitmélységű komponenseket pedig 8 bitre újramintavételezve
- Indexelt szín. A paletta a
[/Indexed base hival lookup]tömbből olvasódik ki, és minden minta a keresőtáblán keresztül valódi színre bővül - DeviceCMYK. A négycsatornás mintákat a szabványos tinta-fehér-alapon képlettel alakítjuk RGB-re
- 8 bit alatti DeviceGray és Indexed 1, 2 vagy 4 bit/komponens mélységben, mintánként kicsomagolva és a 0–255 tartományra skálázva
- CCITTFaxDecode, a Group 3 és Group 4 fax szűrők, egy dedikált T.4/T.6 backenddel dekódolva
- JBIG2Decode, a magas tömörítési arányú bilevel szűrő, a regisztrált JBIG2 backenden keresztül dekódolva, amelyet a natív JBIG2 tömörítés cikk a kódolási oldalról tárgyal
Minden ugyanoda fut ki: egy 24 bites BGR bitkép, mert ezt tárolja natívan a VCL TBitmap-je, és ezt várja minden downstream fogyasztó
Azok az átalakítások, amelyek csendben megváltoztatják a pixeleket
E útvonalak közül kettő olyan átalakítást tartalmaz, amelyet könnyű finoman elrontani, és érdemes megérteni akkor is, ha te magad soha nem nyúlsz a dekóderhez. Az első a színsorrend-csere. Egy PDF DeviceRGB raszter piros-zöld-kék sorrendben tárolja a mintákat, felülről az első sorral kezdve. Egy VCL 24 bites scanline kék-zöld-piros sorrendben tárolja őket. Egy egyszerű RGB kép dekódolása tehát nem memcpy; minden pixel első és harmadik bájtja felcserélődik, mire a scanline-ba kerül. Ha ezt fordítva csinálod, a pirosaid és kékjeid helyet cserélnek, ami szürkeárnyalatos tesztképen rendben néz ki, színes képen viszont katasztrofálisan rossz. A sorok sorrendje, ha már itt tartunk, egyenesen átvihető: a PDF felülről lefelé haladó raszterei megegyeznek a VCL ScanLine[0] mezőjével mint felső látható sorral, így függőleges tükrözésre nincs szükség
A második a CMYK. A PDF DeviceCMYK képei négy festéket hordoznak, és az RGB-re való átalakítás csatornánkénti számítás, nem keresés: minden kimeneti csatorna (255 - ink) * (255 - K) / 255. Ez egy eszközszintű közelítés, nem ICC profilon átvezetett színkezelt konverzió, így az eredmény elég pontos megjelenítéshez és újraraszterizáláshoz, de nem ez a megfelelő út, ha nyomdai pontosságú színre van szükséged. Ha a munkafolyamatod hűséget követel, kezeld a kinyert bitképet előnézetként, és tartsd meg az eredeti CMYK streamet a színkezelt folyamathoz
Az Indexed útvonal saját feldolgozási csapdát rejt. Az /Indexed színtér palettája tárolható literál stringként vagy hexadecimális stringként, és a HotPDF egy hex string értékét a hex szövegként tárolja, nem a dekódolt bájtokként. Ha tehát a paletta hex string, a keresőtáblát előbb egy hex-bájtokká dekódoláson kell átfuttatni; egy literál string már eleve nyers bájtokból áll. Ha ez az ág kimarad, egy négyszínű indexelt kép szemétként jön ki, mert minden palettabejegyzés rossz bájthatárról olvasódik ki
Szűrőláncok: az utolsó szűrő a kép sajátja
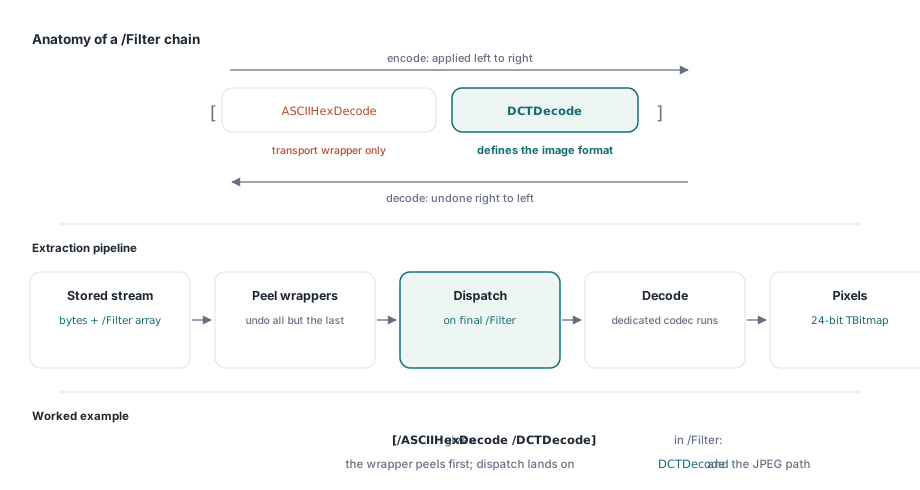
Egyetlen /Filter név a könnyű eset. A PDF megenged szűrők láncát is, ahol a streamet egymás után többön is átfuttatták, sorrendben felsorolva egy /Filter tömbben, mint például [/ASCII85Decode /FlateDecode] vagy [/ASCIIHexDecode /DCTDecode] (ISO 32000-1 §7.4). A szemantika pontos: a szűrők balról jobbra alkalmazódnak kódoláskor, tehát dekódoláskor jobbról balra kell visszafejteni őket, és a tömb utolsó szűrője az, amely ténylegesen meghatározza a kép formátumát. Az előtte lévő szűrők csupán szállítási kódolások, amelyek köré vannak csomagolva
A kinyerő ezt hámozással kezeli. Mielőtt bármelyik képdekóder lefutna, a láncban az utolsó kivételével minden szűrő alkalmazódik, hogy előállítsa azt a bemenetet, amit a végső szűrő elvár, és csak ezután történik meg az elágazás arra az utolsó szűrőre. A [/ASCII85Decode /DCTDecode] tehát először visszafejti az ASCII85-öt a streamből, majd az eredményt a JPEG útvonalra irányítja; a nyers raszter köré csomagolt [/FlateDecode] tömörítetlenítésre kerül, majd lefut a raszter útvonal. Ez teszi lehetővé, hogy a nyolc dekóder egyszerű maradjon. Egyiküknek sem kell tudnia az ASCII85-ről vagy a hex szállítási csomagolásokról, mert mire egy dekóder meglátja a bájtokat, a csomagolások már eltűntek. Azt is jelenti, hogy egy olyan lánc, amelynek végső szűrője nem támogatott, még mindig tisztán elbukik az elágazási lépésnél, nem félúton
Hol áll meg a kinyerés, és mit kell tenni utána
Légy őszinte magaddal a határokat illetően. Az a kép, amelynek végső szűrője a támogatott halmazon kívül esik, nil-t ad vissza, akárcsak az, amelynek színterét a build nem tudja értelmezni. A soft maszkok és az alfa nem épülnek vissza a bitképbe; az alapképet kapod meg, nem egy összeállított eredményt. A JPEG 2000-ből származó, 8 bit fölötti bitmélységek lefelé újramintavételezésre kerülnek, ami szándékosan veszteséges, és rossz lépés, ha újraarchiválsz, nem megjelenítesz. És egy képmaszk, egy egybites sablon saját szín nélkül, a leíróban le van írva, de más dolog, mint egy képi tartalom; ha fotóként várva dekódolod, meglepetés ér
Amikor a kinyerés nem elég, a nyers stream még mindig ott van a betöltött objektumgráfban, szűrőstül, és bájtról bájtra kihúzhatod, majd átadhatod egy saját, specializált kodeknek. Ez az a tartalék, amelyet a pass-through tervezés szándékosan megőriz: az eredeti bájtok soha nem dobódnak el, így a legrosszabb eset az, hogy magadnak kell dekódolnod őket, nem az, hogy az adat elveszett. A legtöbb valós feladathoz azonban a támogatott nyolc szűrő lefedi azt, amit a szkennerek, irodai csomagok és riportmotorok ténylegesen kiadnak, és egy GetLoadedImageCount feletti ciklus Decodable védelemmel néhány sorban visszaalakítja a betöltött PDF-et egy mappányi bitképpé
A betöltött kép kinyerő API, az itt leírt teljes dekódolási szűrőkészlettel együtt, a Delphihez és C++Builderhez készült HotPDF Delphi Component részét képezi