A PDF Library for Delphi Office automatizálás nélkül alakítja át a PDF-tartalmat két szerkeszthető formátumra. Az ExportPageMarkdown és az ExportDocumentMarkdown szemantikus Markdownt ad vissza kikövetkeztetett címsorokkal, rendezett és rendezetlen listákkal és pipe táblázatokkal, míg a SaveDOCXToFile és a SaveDOCXToStream egy WordprocessingML csomagot ír, amely bekezdéseket, címsorokat, natív listaszámozást, felismert táblázatokat, betűstílust, oldaltöréseket és pozicionált PNG-képeket tartalmaz
Mindkettő teljes egészében Pascalban fut, egy szerveren, Word telepítése és COM nélkül. Ez a megkötés az oka annak, hogy a funkció egy PDF-könyvtárban létezik, nem egy asztali eszközben
Miért nehéz igazán a „PDF Wordbe” konvertálás?
Mert egy PDF-oldal nem tartalmaz bekezdéseket. Szövegmegjelenítő operátorokat tartalmaz, amelyek glyph-futásokat helyeznek el koordinátákon, bármilyen sorrendben, ahogy az előállító kiadta őket, anélkül hogy kötelező lenne jelezni, hogy két futás ugyanahhoz a mondathoz tartozik, nemhogy ugyanahhoz a listaelemhez. A formátumot úgy tervezték, hogy pontosan leírjon egy nyomtatott oldalt, és ezt azzal éri el, hogy eldobja azt a szerkezetet, amely az oldalt létrehozta
Így minden konverternek újra kell építenie azt, amit a generátor eldobott. A sorcsoportosítás a függőleges térközből és az alapvonal-igazításból származik. A bekezdéshatárok térközváltozásokból és behúzásból származnak. Egy címsor egy olyan sor, amelynek betűtípusa nagyobb vagy vastagabb a törzsszövegnél, és amely elkülönül az azt követőktől. Egy lista olyan bekezdéssorozat, amely egy felsorolásjellel vagy egy számmintával kezdődik. Egy táblázat olyan szövegblokk-rács, amelynek élei sorok és oszlopok mentén igazodnak. Ezek mindegyike egy következtetés, és a következtetés jó eredményt jelent az olyan dokumentumoknál, amelyek követik a szokásos tipográfiai konvenciókat, és közepes eredményt azoknál, amelyek nem
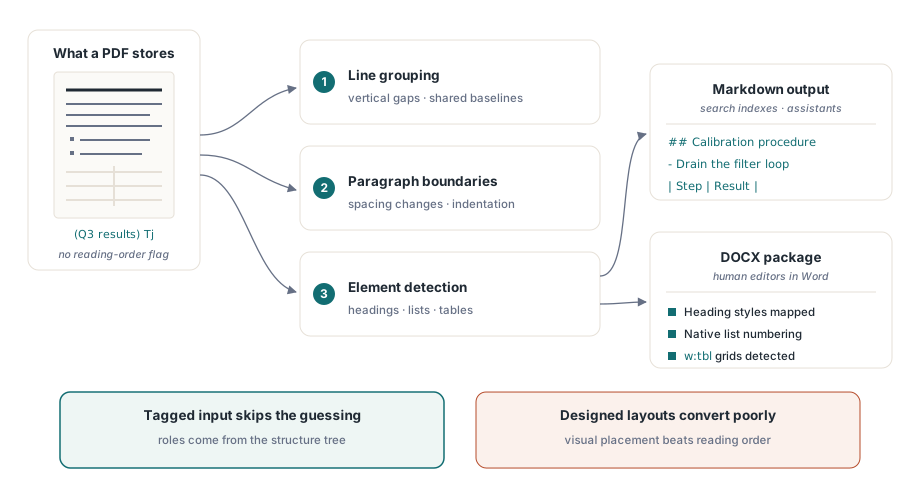
A tagelt PDF-ek a kivétel, méghozzá egy jelentős kivétel. Amikor a dokumentum egy struktúrafát hordoz, a bekezdés-, címsor-, lista- és táblázatszerepek rögzítve vannak, nem kitalálva, ezért fizetődik ki a tagelt PDF akadálymentességi struktúra című cikkben leírt akadálymentességi munka a konverzió minőségében is. Ha te irányítod az előállítót, a kimeneted tagelése az egyetlen legnagyobb hatású dolog, amit tehetsz bárkiért, akinek később konvertálnia kell azt
Markdown exportálás, egyszerre egy oldal
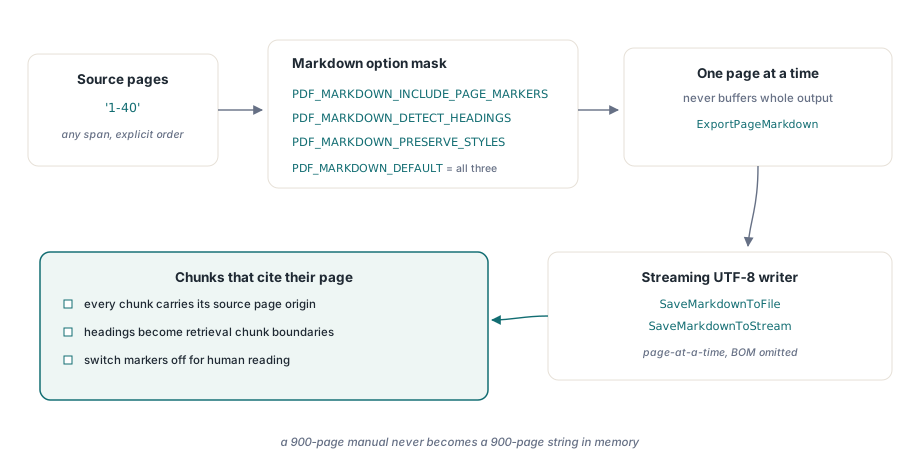
A Markdown útvonal az, amelyhez érdemes nyúlni, amikor a célpont egy szöveges pipeline: egy dokumentációs oldal, egy keresőindex, egy visszakeresési korpusz egy asszisztenshez. Az opciók egy bitmaszk: PDF_MARKDOWN_INCLUDE_PAGE_MARKERS, PDF_MARKDOWN_DETECT_HEADINGS, PDF_MARKDOWN_PRESERVE_STYLES, a PDF_MARKDOWN_DEFAULT pedig mindhármat kombinálja
var
  Pdf: TPDFlib;
  Md: WideString;
begin
  Pdf := TPDFlib.Create;
  try
    Pdf.LoadFromFile('handbook.pdf', '');

    // Egy oldal, stringként
    Md := Pdf.ExportPageMarkdown(1, PDF_MARKDOWN_DEFAULT);

    // Egy oldaltartomány, lemezre streamelve UTF-8-ként, BOM nélkül
    Pdf.SaveMarkdownToFile('1-40',
      PDF_MARKDOWN_DETECT_HEADINGS or PDF_MARKDOWN_PRESERVE_STYLES,
      'handbook.md');
  finally
    Pdf.Free;
  end;
end;
Az oldaljelölők megdolgoznak a visszakeresési munkában. Egy szövegdarab, amely magával hordozza, melyik oldalról származik, pontosan idézhető, és egy olvasó, aki követi az idézetet, oda érkezik, ahol az állítás valójában van. Kapcsold ki őket, amikor a Markdown emberi olvasásra szánt, ahol a forráselrendezésből származó oldalhatárok zajnak számítanak
A streamelő belépési pontok nagy dokumentumoknál számítanak. A SaveMarkdownToStream és a SaveMarkdownToFile egyszerre egy oldalnyi UTF-8-at ír, és nem pufferolja a teljes kimenetet, így egy 900 oldalas kézikönyv nem lesz először egy 900 oldalas stringgé a memóriában. A byte-sorrend jelző hiánya is szándékos: egy BOM egy Markdown fájlon meglepően sok statikus site generátort és diff eszközt zavar meg
DOCX Office nélkül a gépen
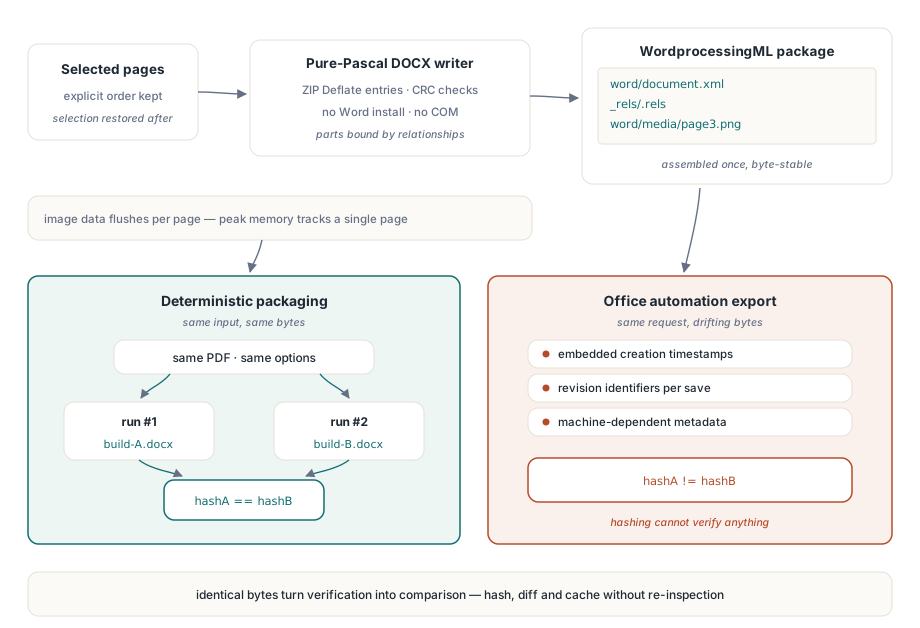
A DOCX-író magát a csomagot állítja elő: nyers Deflate-ként írt ZIP-bejegyzéseket CRC-ellenőrzésekkel, a WordprocessingML részeket, és az őket összekötő kapcsolatokat. Semmi sem hívja meg a Wordöt, ami azt jelenti, hogy a konverzió fut egy fej nélküli szerveren, egy szolgáltatásfiókon belül, egy konténerben, mindenhol, ahol az Office automatizálás vagy licenc nélküli, vagy instabil, vagy tiltott
var
  Pdf: TPDFlib;
  Target: TFileStream;
begin
  Pdf := TPDFlib.Create;
  Target := TFileStream.Create('handbook.docx', fmCreate);
  try
    Pdf.LoadFromFile('handbook.pdf', '');
    Pdf.SaveDOCXToStream('1-40',
      PDF_DOCX_INCLUDE_IMAGES or PDF_DOCX_DETECT_HEADINGS or
      PDF_DOCX_PRESERVE_STYLES or PDF_DOCX_PRESERVE_PAGE_BREAKS,
      Target);
  finally
    Target.Free;
    Pdf.Free;
  end;
end;
A képadatok minden oldal feldolgozásakor íródnak, nem a végén összegyűjtve és hozzáfűzve, így a csúcsmemória egyetlen oldalt követ, nem a teljes dokumentumot. Az explicit oldalsorrend megőrződik, és a kiválasztott PDF-oldal utólag visszaáll, ami akkor számít, amikor az export egy lépés egy hosszabb feladaton belül, amelynek más okokból volt kiválasztott oldala
Mit nyersz a determinisztikus csomagolással?
Byte-pontos reprodukálhatóságot. Ugyanazon bemenet két konverziója ugyanazokkal az opciókkal ugyanazt a csomagot állítja elő, ami azt jelenti, hogy hash-elheted a kimenetet a változás észleléséhez, diffelheted egy generált dokumentum két buildjét, és agresszíven gyorsítótárazhatsz anélkül, hogy aggódnál amiatt, hogy egy azonos bemenet más artefaktumot állított elő
Az Office automatizálás ezt nem tudja ígérni. Időbélyegeket, revíziós azonosítókat és géptől függő metaadatokat ágyaz be, így ugyanaz a dokumentum kétszer konvertálva olyan módon tér el, amely meghiúsítja a hashelést. Ugyanez a gondolatmenet vezérli a determinisztikus PDF ID-k reprodukálható buildekhez című cikkben tárgyalt determinisztikus fájlazonosítókat: amikor a kimenet reprodukálható, az ellenőrzés összehasonlítássá válik vizsgálat helyett
Hol jó a kimenet, és hol nem
Légy őszinte a felhasználóiddal ebben, mert a konverzió minősége jobban változik a bemenettel, mint a konverterrel. A tagelt PDF-ek és a tisztán generált üzleti dokumentumok, számlák, jelentések, szerződések jól konvertálódnak: a címsorok címsorként landolnak, a táblázatok túlélik, a listák helyesen újraszámozódnak Wordben. A kéthasábos akadémiai elrendezések elfogadhatóan konvertálódnak, ha a hasábgeometria szabályos. Az oldaltöréseken átívelő táblázatok következtetéssel kerülnek újraösszeállításra, és néha felosztásra. Az erősen tervezett marketinganyagok, ahol a szöveg vizuális hatás céljából van elhelyezve, nem olvasási sorrendben, rosszul konvertálódnak, és semennyi következtetés sem javítja ezt
A szkennelt dokumentumok teljesen külön esetet jelentenek. Egy oldal, amely egyetlen nagy kép, nem tartalmaz szövegobjektumokat, így nincs mit exportálni, amíg nem létezik szövegréteg; az azt előállító OCR útvonal előfeltétel, nem opció. Mielőtt egy nagy köteget futtatnál, mintavételezz egy tucat reprezentatív fájlt, és nézd meg a kimenetet, és fontold meg az oldalelemek előzetes felsorolását, ahogy azt a szöveges keresés és oldalelem-felsorolás című cikk leírja, hogy lásd, az oldalak valójában mit tartalmaznak
Asszisztens- és visszakeresési pipeline-oknál a Markdown útvonal általában a jobb célpont: a címsorok darabhatárokká válnak, a táblázatok pipe táblázatként olvashatók maradnak, és az oldaljelölők minden darabnak idézhető helyet adnak. Emberi szerkesztéshez a DOCX a válasz, mert amit a felhasználó akar, az nem a szöveg, hanem a módosításának képessége
A PDF Library for Delphi egy Delphi, C++Builder és Lazarus PDF-könyvtár, illeszkedő DLL és ActiveX interfészekkel, így ugyanezek az exporthívások C#, C++ vagy szkriptkezelő hosztok számára is elérhetők. A teljes dokumentáció és egy próbaverzió a PDF Library for Delphi Delphi PDF-könyvtár oldalán található