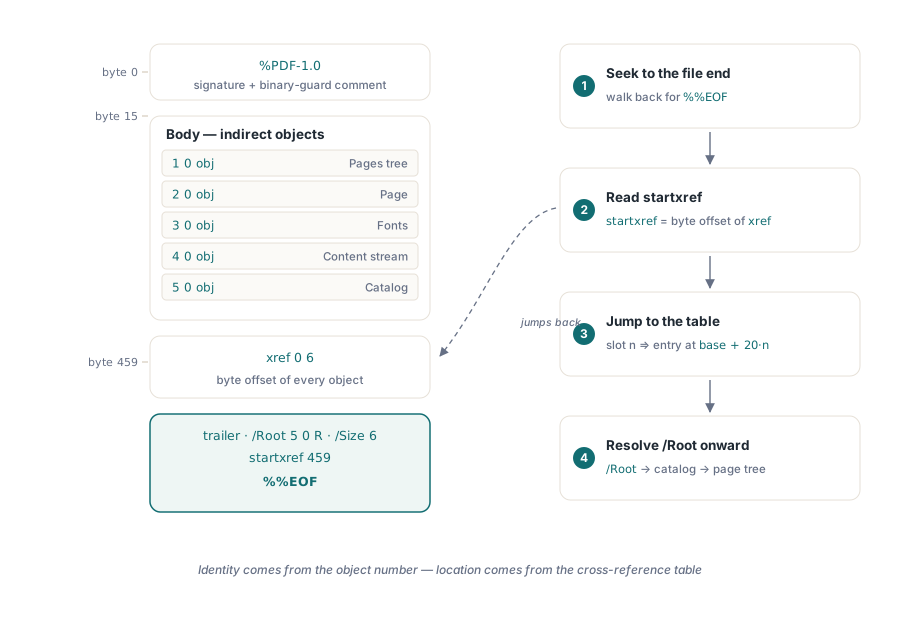
PDF čitač ne kreće od početka datoteke, nego od kraja. Zadnjih nekoliko bajtova nosi adresu svega ostalog, pa parser koji taj redoslijed ne razumije krivo čita format već od prvog retka. Zato PDF na disku ima smisla učiti onako kako ga čita sam čitač: prvo rep, pa skok unatrag na mapu, pa razrješavanje objekata na koje ta mapa pokazuje
Same bajtove možeš pročitati u običnom uređivaču teksta sve dok ništa nije komprimirano. Minimalan jednostranični dokument koji iscrtava "Hello, World!" stane u manje od petsto bajtova, a u njemu se vidi svaki strukturni element formata. Evo cijele datoteke, s označena četiri dijela:
%PDF-1.0                          % Zaglavlje
%âãÏÓ

1 0 obj                           % Tijelo: niz objekata
<<
/Kids [2 0 R]
/Count 1
/Type /Pages
>>
endobj

2 0 obj
<<
/Rotate 0
/Parent 1 0 R
/Resources 3 0 R
/MediaBox [0 0 612 792]
/Contents [4 0 R]
/Type /Page
>>
endobj

3 0 obj
<< /Font << /F0 << /BaseFont /Times-Italic /Subtype /Type1 /Type /Font >> >> >>
endobj

4 0 obj
<< /Length 65 >>
stream
1. 0. 0. 1. 50. 700. cm BT
  /F0 36. Tf
  (Hello, World!) Tj
ET
endstream
endobj

5 0 obj
<< /Pages 1 0 R /Type /Catalog >>
endobj

xref                              % Tablica unakrsnih referenci
0 6
0000000000 65535 f
0000000015 00000 n
0000000074 00000 n
0000000192 00000 n
0000000291 00000 n
0000000409 00000 n

trailer                           % Trailer
<<
/Root 5 0 R
/Size 6
>>
startxref
459
%%EOF
Četiri dijela, uvijek tim redom niz datoteku: zaglavlje, tijelo s objektima, tablica unakrsnih referenci i trailer. Kvaka je u tome da ih čitaš gotovo obrnutim redoslijedom. ISO 32000-2 §7.5.1 opisuje istu četverodijelnu anatomiju, a razlog za pristup od kraja prema početku posve je praktičan: čitač koji skoči ravno na objekt koji mu treba puno je brži od onoga koji pretražuje svaki bajt odozgo, a upravo taj nasumični pristup trailer i tablica unakrsnih referenci postoje da omoguće
Zaglavlje ima dva retka, a bitan je drugi
Prvi je redak %PDF-1.0. Znak postotka po sintaksi ga čini komentarom, ali ga čitači tretiraju kao potpis datoteke i iz njega vade broj verzije. U praksi je rukovanje verzijom labavo. Čitač napisan za PDF 2.0 bez pogovora otvara datoteku koja tvrdi da je 1.0, a većina čitača pokušat će i s datotekom kojoj je verzija krivo navedena ili kojoj redak s verzijom nije na nultom bajtu nego malo dublje u datoteci. Broj je natuknica o tome koje značajke očekivati, a ne rampa
Drugi je redak onaj koji ljudi slučajno obrišu pa poslije cijelo popodne love grešku. I on je komentar, ali mu je teret četiri bajta iznad ASCII 127. Postoje zato da bi svaki alat koji datoteku prenosi u tekstualnom načinu prepoznao da je sadržaj binaran i prestao prepisivati prijelome redaka. PDF nosi komprimirane streamove čiji bajtovi slučajno mogu ispasti isti kao CR ili LF; prepiše li ih alat za prijenos, duljina streama zapisana u rječniku više ne odgovara bajtovima na disku i datoteka je pokvarena. Taj komentar s visokim bajtovima obrana je stara četrdeset godina, još iz vremena FTP-a u ASCII načinu, i još je u svakoj datoteci koju napiše ozbiljan alat jer je kvar koji sprječava tih i potpun
Tijelo drži objekte, svaki sa svojim brojem
Sve od čega se dokument sastoji živi u tijelu kao ravan niz indirektnih objekata. Svaki počinje s dva cijela broja i ključnom riječi obj, nosi svoj sadržaj i zatvara se s endobj. Objekt 1 u gornjem primjeru čvor je stabla stranica: 1 0 obj, pa rječnik, pa endobj. Prvi cijeli broj je broj objekta, drugi je broj generacije. U svježe napisanoj datoteci generacija je gotovo uvijek nula; raste tek kad se broj objekta ponovno iskoristi kroz uređivanja, što je dovoljno rijetko da generaciju različitu od nule možeš čitati kao znak da je datoteka prošla kroz inkrementalna ažuriranja. Sadržaj između ključnih riječi ovdje je rječnik, napisan između << i >>, ali jednako je tako mogao biti broj, string, polje ili stream
Ono što od svega ovoga radi graf, a ne popis, referentni je token 2 0 R. On znači "objekt 2, generacija 0, gdje god se u datoteci zatekao". Gornji čvor stabla stranica ne sadrži svoju stranicu; pokazuje na objekt 2, koji istim mehanizmom pokazuje na svoje resurse i stream sadržaja. Tijelo je posloženo onim redom koji je piscu bio zgodan, a reference ga spajaju u stablo ukorijenjeno u katalogu. Položaj u datoteci ne znači ništa. Identitet dolazi od broja objekta, a lokacija iz tablice unakrsnih referenci
Tablica unakrsnih referenci indeks je pomaka u bajtovima
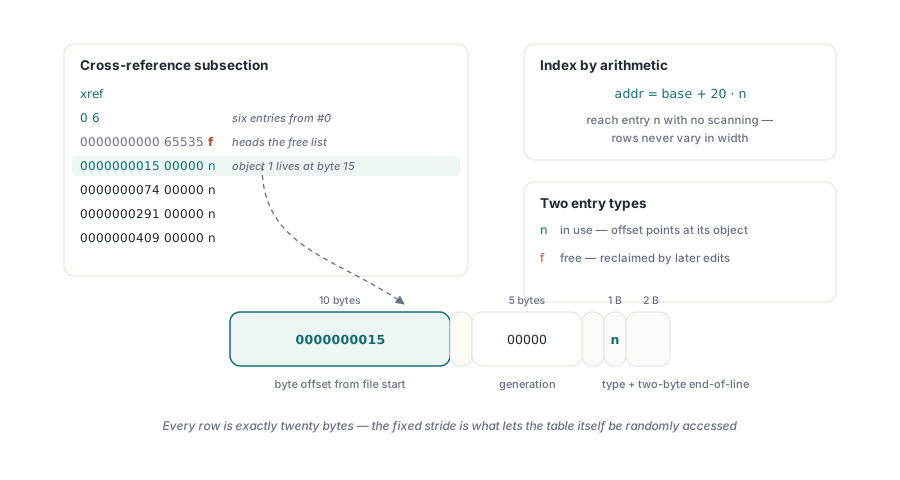
Tablica xref pretvara brojeve objekata u pozicije u datoteci. Ona je razlog zašto čitač može otvoriti dokument od tisuću stranica i prikazati stranicu 850 bez parsiranja prethodnih 849. Svaki unos bilježi točno gdje njegov objekt počinje, brojano u bajtovima od početka datoteke:
xref
0 6                  % 6 unosa, počevši od objekta 0
0000000000 65535 f   % unos 0: glava liste slobodnih
0000000015 00000 n   % objekt 1 počinje na bajtu 15
0000000074 00000 n   % objekt 2 počinje na bajtu 74
0000000192 00000 n   % objekt 3 počinje na bajtu 192
0000000291 00000 n   % objekt 4 počinje na bajtu 291
0000000409 00000 n   % objekt 5 počinje na bajtu 409
Fiksna širina nije slučajna. Svaki unos ima točno dvadeset bajtova: deseteroznamenkasti pomak, razmak, peteroznamenkasta generacija, razmak, jednoznakovni tip i dva bajta prijeloma retka. Kako su reci ujednačeni, čitač do unosa za objekt n dolazi aritmetikom umjesto pretraživanjem, pa je tablica koja daje nasumičan pristup tijelu i sama nasumično dostupna. Redak 0 6 zaglavlje je pododjeljka: kaže da sljedeći unosi opisuju šest objekata počevši od broja 0
Objekt 0 poseban je i uvijek prisutan. Tip mu je f, od free, generacija mu je 65535 i on vodi povezanu listu slobodnih brojeva objekata. U datoteci koja nikad nije uređivana ta lista ima samo taj jedan unos, čista formalnost. Kruh zaradi kod inkrementalnih ažuriranja: brisanjem objekta njegov broj ide na tu listu, pa ga kasnije uređivanje može ponovno iskoristiti. Ostali su unosi tipa n, u upotrebi, a njihov deseteroznamenkasti broj pomak je na koji se pozicioniraš da pročitaš definiciju tog objekta
Trailer je ulazna točka, a stoji na kraju
Trailer je prvo što čitač zapravo pročita, iako se piše zadnji. Parser otvori datoteku, pozicionira se na kraj i hoda unatrag tražeći %%EOF. Odmah iznad njega stoji startxref pa jedan jedini broj, a taj je broj pomak u bajtovima do ključne riječi xref. S njim čitač skače ravno na tablicu unakrsnih referenci, a da nije parsirao nijedan objekt:
trailer
<<
/Root 5 0 R          % katalog dokumenta
/Size 6              % jedan više od najvećeg broja objekta
>>
startxref
459                  % pomak u bajtovima do tablice xref
%%EOF
Rječnik trailera nosi dvije vrijednosti koje čitaču trebaju prije nego što išta drugo može napraviti. /Root pokazuje na katalog dokumenta, ovdje objekt 5, koji je vrh grafa objekata i put do stabla stranica. /Size je broj unosa koje bi tablica unakrsnih referenci trebala imati, a to je jedan više od najvećeg broja objekta zbog slobodnog unosa na mjestu nula. Iz %%EOF ispada cijeli redoslijed čitanja: nađi marker, pročitaj startxref da nađeš tablicu, učitaj tablicu da saznaš gdje koji objekt živi, pročitaj /Root da nađeš katalog i odatle razrješavaj objekte po potrebi. Zaglavlje, koje stoji na vrhu, gotovo se i ne konzultira sve do kraja. Mapa na dnu ono je što čitaču treba prvo
Inkrementalno ažuriranje dodaje drugu mapu umjesto da datoteku prepiše
Taj se dizajn od kraja prema početku isplati kad se datoteka mijenja. PDF se može urediti bez prepisivanja ijednog bajta koji je već na disku. Novi i izmijenjeni objekti dodaju se na kraj, iza njih ide svježi odjeljak unakrsnih referenci i svježi trailer, a izvorna datoteka ispod ostaje netaknuta. Jedina je nova evidencija unos /Prev u novom traileru, koji drži pomak u bajtovima do prethodne tablice unakrsnih referenci:
% ... izvorna datoteka, nepromijenjena, završava ovdje ...

6 0 obj                          % objekt dodan ovim uređivanjem
<< /Type /Annot /Subtype /Text /Rect [100 700 120 720] >>
endobj

xref                             % drugi xref odjeljak, samo za novi objekt
6 1
0000000612 00000 n

trailer
<<
/Root 5 0 R
/Size 7
/Prev 459                        % pomak u bajtovima do ranije tablice xref
>>
startxref
680                              % pomak ovog novog xref odjeljka
%%EOF
Čitač i dalje kreće od zadnjeg %%EOF, i dalje preko startxref ide na najnoviju tablicu, ali sad lancem /Prev ide unatrag na starije tablice i spaja ih tako da za svaki broj objekta pobjeđuje najnoviji unos. Odjeljci unakrsnih referenci tvore povezanu listu niz datoteku, a svaki nadglasava prethodni za objekte kojih se dotakne. Objekt koji je uređivanje zamijenilo i dalje fizički postoji na svom starom pomaku; samo više nije dohvatljiv, jer kasniji xref unos pokazuje negdje drugdje
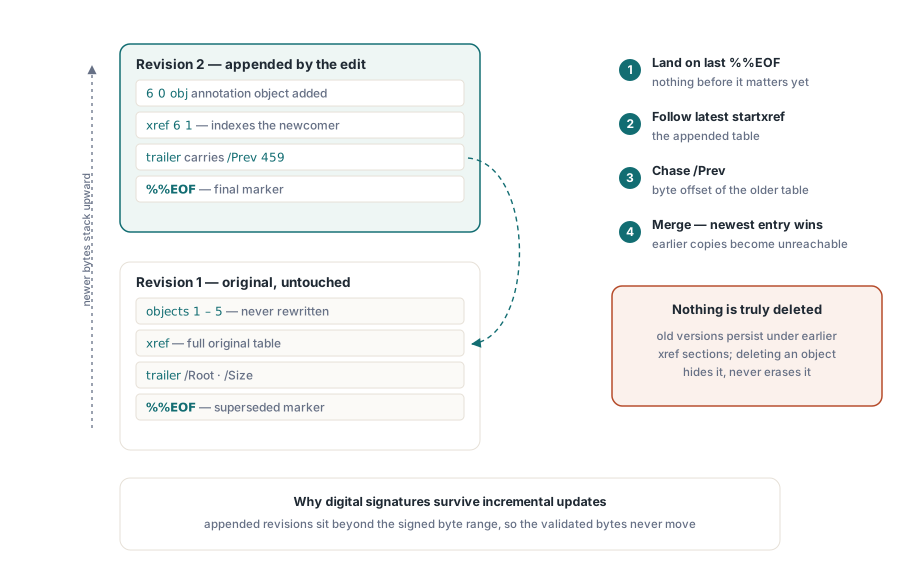
To je mehanizam koji potpisane PDF-ove čini provjerljivima. Digitalni potpis pokriva raspon bajtova u datoteci, a kako inkrementalno ažuriranje samo dodaje na kraj, potpisani se bajtovi nikad ne pomiču. Potpis i dalje prolazi provjeru nad izvornim rasponom, dok kasnije revizije leže iza njega, svaka sa svojim xrefom i trailerom. Zbog istoga PDF može nositi i povijest koja se da povratiti: svaki nadomješteni objekt još je na disku pod ranijim odjeljkom unakrsnih referenci, što je značajka za praćenje verzija i teret za svakoga tko je mislio da "obriši" znači da bajtova više nema
Cijena je rast. Svako uređivanje nadodaje, ništa se ne oslobađa na mjestu, pa datoteka mnogo puta revidirana skuplja mrtve objekte i dugačak lanac xref odjeljaka. Lijek je potpuno prepisivanje: učitaj dokument i spremi ga iznova, čime se preživjeli objekti prenumeriraju, nedohvatljivi ispadaju, a izlazi jedna čista tablica unakrsnih referenci. Dvije se strategije izravno sudaraju. Dodavanje je brzo i čuva potpise i povijest; prepisivanje je sporije i oboje baca, u zamjenu za kompaktnu datoteku
Čitanje četiriju dijelova u praksi
Poznavanje rasporeda dovoljno je da rukom razmrsiš većinu problema tipa "ova se datoteka ne otvara". Ako čitač odbije PDF, krivci su obično na dva kraja, a ne u sredini. Prekinuto preuzimanje odreže trailer, pa nedostaje startxref ili %%EOF i čitač nema ulaznu točku; tolerantniji se čitači vraćaju na pretraživanje cijele datoteke da rekonstruiraju xref, a to je upravo onaj spori put koji je tablica trebala izbjeći. Zabrljan prijenos u tekstualnom načinu pokvari bajtove streama ili pomaci prestanu odgovarati stvarnosti, pa se objekti učitavaju s krive pozicije. Kad pomaci u tablici više ne pokazuju na stvarne ključne riječi obj, datoteka je strukturno slomljena i onda kad je svaki objekt sam za sebe u redu
Za novi kod pouka rasporeda je da knjigovodstvo nad bajtovima prepustiš biblioteci. Pomaci u tablici unakrsnih referenci moraju se do bajta slagati sa stvarnim položajima svih objekata, trailer mora pokazivati na pravu tablicu, a inkrementalna se ažuriranja moraju ispravno ulančati kroz /Prev. Nativna komponenta poput HotPDF Delphi Component za Delphi i C++Builder sve to rješava kad piše datoteku, uključujući izbor između dodavanja inkrementalne revizije i prepisivanja u kompaktnu. Ako te zanima kako se ista struktura gradi ni iz čega umjesto da je rastavljamo, prateći tekst o izgradnji PDF dokumenta ispočetka vodi kroz ispisivanje zaglavlja, objekata, xrefa i trailera po redu