Upišite =NORM.DIST(115,100,15,TRUE) u ćeliju i Excel bez ceremonije vrati 0.8413447. Poziv izgleda kao obično traženje vrijednosti. Nije. Iza tog jednog broja stoji kumulativna normalna razdioba, integral bez zatvorenog oblika, a iza CHISQ.INV.RT i BETA.DIST stoje posebne funkcije koje pomna biblioteka mora izračunati, a ne procijeniti napamet. Komponenta za proračunske tablice koja tvrdi da je kompatibilna s Excelom te vrijednosti mora reproducirati do posljednje znamenke koju Excel prikaže, a to znači reproducirati numeričke metode, ne samo nazive funkcija
HotXLS implementira više od pedeset takvih statističkih funkcija, a posao koji ih čini ispravnima gotovo je posve nevidljiv iz trake formule. Ovo je obilazak načina na koji ih mehanizam računa: zajednička jezgra posebnih funkcija, odluke o grananju koje aritmetiku drže stabilnom i jedna pogreška u inverznoj normalnoj razdiobi koja se dugo skrivala u repu jer uobičajeni slučaj pokvareni redak nikada nije ni dotaknuo
Jedan poziv u radnom listu, pedeset razdioba iza njega
Funkcije pokrivaju obitelji za kojima statistička radna knjiga poseže. Tu je normalna obitelj, NORM.DIST i NORM.S.DIST sa svojim inverzima; obitelj game i hi-kvadrata, GAMMA.DIST, CHISQ.DIST, CHISQ.DIST.RT, CHISQ.INV.RT; beta obitelj, BETA.DIST i BETA.INV; razdiobe uzorkovanja T.DIST, T.DIST.2T, F.DIST i F.INV; diskretni par BINOM.DIST i POISSON.DIST; te pomoćnice za zaključivanje poput CONFIDENCE.T i CONFIDENCE.NORM. Iz pozivateljeve stolice svaka je od njih jedna formula. Ulaze postavite u ćelije, zatražite od radne knjige da izračuna i pročitate rezultat
var
  wb: IXLSWorkbook;
  sh: IXLSWorksheet;
begin
  wb := TXLSWorkbook.Create;
  sh := wb.Sheets.Add;
  sh.Range['A1', 'A1'].Value := 115;   // opažanje
  sh.Range['A2', 'A2'].Value := 100;   // aritmetička sredina
  sh.Range['A3', 'A3'].Value := 15;    // standardna devijacija

  // Raščlanjivač XLS formula kao razdjelnik argumenata koristi ';'.
  Writeln(wb.Calculate('=NORM.DIST(A1;A2;A3;TRUE())'));   // 0.8413447
  Writeln(wb.Calculate('=CHISQ.INV.RT(0.05;10)'));        // 18.3070381
  Writeln(wb.Calculate('=BETA.DIST(0.5;2;3;TRUE())'));    // 0.6875
end;
Metoda Calculate na radnoj knjizi prevodi i izračunava prigodnu formulu nad živim listom te vraća Variant. Jedan detalj zapinje ljudima iz prvog pokušaja: raščlanjivač formula iza Calculate kao razdjelnik argumenata uzima točku sa zarezom, pa je to =SUM(A1;B1), a ne =SUM(A1,B1). Pohranjene formule u ćelijama zadržavaju zarez po Excelovom standardu. Isti izračunavač otprema svaku statističku funkciju u nastavku, pa kad jedna od njih proradi u Calculate, ostale slijede isti put
Dvije funkcije na kojima sve ostalo počiva
Većina kumulativnih razdioba u ovom skupu ne računa se zbrajanjem ni integriranjem vlastitih definicija. Računaju se iz dviju posebnih funkcija: regularizirane donje nepotpune game, pisane P(a, x), i regularizirane nepotpune bete, pisane Ix(a, b). Interno su to pomoćnice na koje se otpremnici oslanjaju, a lanac je kratak. CDF hi-kvadrata je CDF game s oblikom df/2 i mjerilom 2. CDF game izravno je P(a, x). Kumulativne funkcije t, F i binomne razdiobe sve su vrijednosti regularizirane nepotpune bete pri odgovarajućim argumentima. Poissonov je CDF gornja nepotpuna gama Q. Dobro implementirajte funkcije game i bete i tucet razdioba njihovu točnost naslijedi besplatno
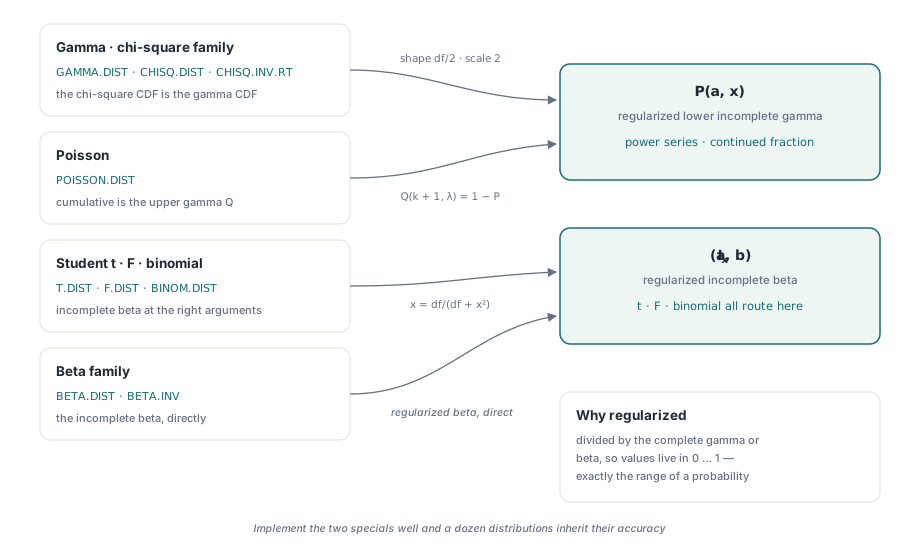
Riječ "regularizirana" cijela je poanta. Sirova nepotpuna gama raste poput faktorijela, a sirovi beta integral može podbaciti ili prekoračiti raspon davno prije nego to učini sam odgovor. Regularizirani su oblici podijeljeni potpunom gamom ili betom, pa žive isključivo u intervalu od nule do jedan, a to je točno raspon koji vjerojatnost zauzima. Ta normalizacija omogućuje da ista rutina posluži i hi-kvadrat s dva stupnja slobode i onaj s dvjesto, bez da međurezultati iskliznu iz opsega tipa double. Objašnjava i zašto CDF ne računate zbrajanjem dugog repa članova gustoće: svaki član nosi vlastitu pogrešku zaokruživanja, pogreške se tijekom niza gomilaju, a regularizirana posebna funkcija zbroj potpuno zaobilazi tako što umjesto njega izračuna brzo konvergentni red ili verižni razlomak
Red ispod dijagonale, verižni razlomak iznad nje
Rutina nepotpune game prije bilo kakvog računanja donosi jednu odluku: usporedi x s a + 1. Ta granica nije proizvoljna. Razvoj P(a, x) u potencijski red brzo konvergira kad je x malen u odnosu na a, a sporo i naposljetku beskorisno kad je x velik. Verižni razlomak ima suprotan karakter. Mehanizam stoga za x manji od a + 1 koristi potencijski red, a za x jednak ili veći od a + 1 Lentzov verižni razlomak, pa se od svake grane traži samo posao u kojem je dobra
Verižni razlomak treba jednu zaštitu. Lentzova metoda radi tako da vodi tekući brojnik i nazivnik i nazivnik u svakom koraku invertira, pa ako se bilo koji približi nuli, inverzija eksplodira. Rješenje je sićušan pod: kad god međučlan po iznosu padne ispod otprilike 1e-30, ograničava se na 1e-30, čime rekurzija ostaje konačna bez utjecaja na konvergiranu vrijednost. Isto se ograničenje pojavljuje u verižnom razlomku nepotpune bete iz istog razloga. Riječ je o maloj konstanti koja nosi veliku težinu, o razlici između stabilnog izračuna i dijeljenja nečim što se od nule ne razlikuje
Gornji je rep, Q(a, x), naprosto 1 minus P(a, x), i tako se računa Poissonova kumulativna grana: vjerojatnost od najviše k događaja uz srednju vrijednost λ je Q(k + 1, λ). Vođenje toga kroz gornju nepotpunu gamu umjesto zbrajanja k + 1 Poissonovih članova opet je odluka da se izračuna jedan konvergentan izraz umjesto da se gomilaju mnogi mali
Diskretne mase bez prekoračenja faktorijela
Diskretne razdiobe donose drugu opasnost. Binomna vjerojatnosna masa uključuje binomni koeficijent, a koeficijent za pedeset dva povrh dvadeset šest golem je cijeli broj. Oblikujte ga izravno i brojnik prekorači raspon tipa double prije dijeljenja koje bi ga vratilo na razumnu vjerojatnost. Mehanizam ga nikada ne oblikuje. Faktorijele računa u logaritamskom prostoru preko log-gama funkcije, logaritme zbraja i oduzima, uklapa logaritme vjerojatnosti uspjeha i neuspjeha te potencira jedanput, tek na samom kraju
// Binomna vjerojatnosna masa, izračunata u cijelosti u logaritamskom prostoru.
// LnGammaF(n+1) je ln(n!); tri logaritamska faktorijela tvore ln(C(n,k)),
// a cijeli se eksponent sastavlja prije jednog jedinog poziva Exp.
//   ln P(X=k) = ln(n!) - ln(k!) - ln((n-k)!) + k*ln(p) + (n-k)*ln(1-p)
result := Exp(LnGammaF(nt + 1) - LnGammaF(kk + 1) - LnGammaF(nt - kk + 1)
  + kk * Ln(pp) + (nt - kk) * Ln(1 - pp));
Sama je log-gama funkcija Lanczosova aproksimacija, točna na cijeloj pozitivnoj osi i jeftina za izračun. Budući da se svaka velika veličina drži kao svoj logaritam sve do završnog Exp, najveći broj koji rutina ikad materijalizira jest sama vjerojatnost, a ona je najviše jedan. Poissonova funkcija mase slijedi isti recept, s jednim log-gama članom umjesto faktorijela u nazivniku. Zatvoreni su oblici posebno obrađeni na rubovima, gdje je p točno nula ili jedan, pa kôd nikada ne poziva Ln(0). HotXLS za BINOM.DIST(5,10,0.5,FALSE) vraća 0.2460938, a za kumulativni POISSON.DIST(2,2,TRUE) 0.6766764, što se poklapa s Excelom kroz sve znamenke koje ispisuje
Inverzi omeđivanjem prednje krivulje
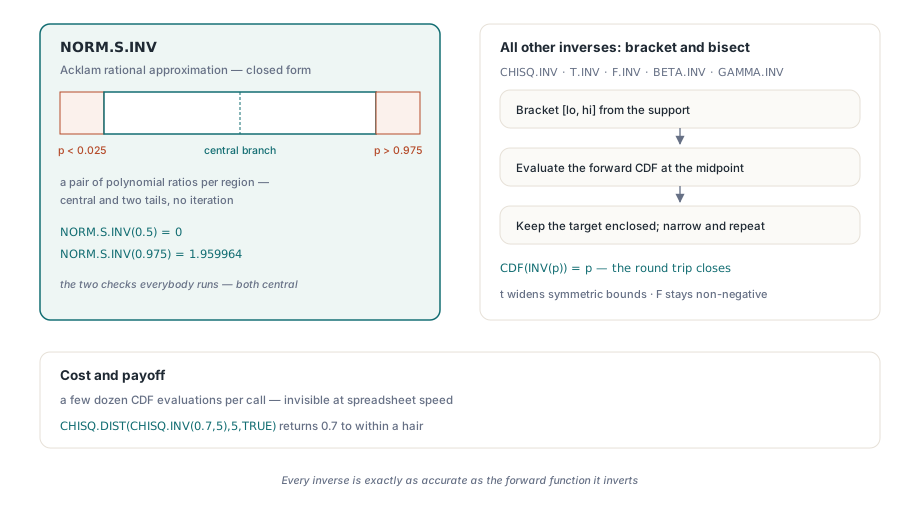
Inverzna funkcija razdiobe postavlja obrnuto pitanje: uz zadanu vjerojatnost pronađi vrijednost čiji joj je CDF jednak. Samo jedan inverz u ovom skupu ima brzu izravnu formulu. NORM.S.INV, inverz standardne normalne razdiobe, koristi Acklamovu racionalnu aproksimaciju, par polinomnih omjera točan otprilike do preciznosti tipa double na cijelom rasponu, podijeljen na središnje područje i dva repa. Riječ je o izračunu u zatvorenom obliku, bez iteracije
Ostali inverzi takvu formulu nemaju, pa ih mehanizam invertira numerički. Odgovor omeđuje donjom i gornjom granicom odabranima iz nosača razdiobe, a zatim raspolavlja: prednji CDF izračuna u polovištu, pomakne onu granicu koja ciljanu vjerojatnost i dalje drži zatvorenom i ponavlja dok interval ne postane uzak. Za inverze game i hi-kvadrata omeđivanje počinje od nule i darežljive gornje procjene sastavljene iz oblika i mjerila, uz udvostručavanje gornje granice ako vjerojatnost još nije obuhvaćena. Inverz t razdiobe omeđuje simetrične granice koje se šire prema van; inverz F razdiobe raspolavlja na nenegativnom intervalu. Cijena je nekoliko desetaka izračuna CDF-a po pozivu, što je pri brzini proračunske tablice nevidljivo, a dobitak je što je svaki inverz točno onoliko točan koliko i prednja funkcija koju invertira. Zato povratni put poput CHISQ.DIST(CHISQ.INV(0.7,5),5,TRUE) vraća 0.7 do u dlaku
Logaritam po bazi 10 koji se skrivao u repu
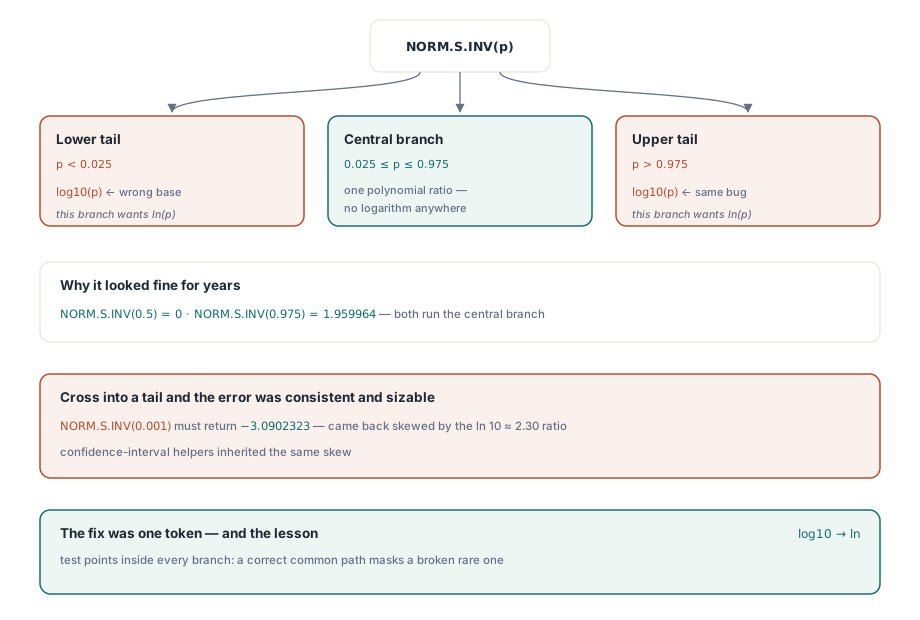
Evo pogreške koju vrijedi ispričati, jer je od one vrste koja dugo preživi. Acklamova rutina inverzne normalne razdiobe ima tri grane. Široka središnja grana, koja se koristi kad god vjerojatnost leži otprilike između 0.025 i 0.975, ulaz provodi kroz polinomni omjer u kojem logaritma nema nigdje. Dvije grane repa, za vrlo male ili vrlo velike vjerojatnosti, ulaz najprije logaritmiraju, jer se rep ponaša poput drugog korijena iz minus prirodnog logaritma od p
Rana je verzija grane repa uzimala logaritam po bazi 10 ondje gdje pripada prirodni logaritam. Njih se dvoje razlikuje za stalni faktor od približno 2.30, pa su rezultati u repu bili pogrešni za dosljedan i priličan iznos. Pa ipak, funkcija je u svakoj usputnoj provjeri izgledala ispravno, jer usputne provjere žive u sredini. NORM.S.INV(0.5) je nula, NORM.S.INV(0.975) je udžbenički 1.959964, a oboje prolazi kroz središnji polinom koji logaritam uopće ne poziva. Pogreška se javljala tek kad bi vjerojatnost prešla u rep, recimo NORM.S.INV(0.001), koji mora vratiti -3.0902323, a vraćao se promašen za omjer prirodnog logaritma prema onom po bazi 10. Svaka funkcija koja u repu ovisi o inverznoj normalnoj razdiobi, uključujući pomoćnice za intervale pouzdanosti, naslijedila je isto iskrivljenje. Pouka je obična i skupa: funkcija s granatom strukturom treba ispitne točke unutar svake grane, jer će ispravan uobičajeni put veselo prikriti pokvaren rijetki. Popravak je bila izmjena jednog tokena, s logaritma po bazi 10 na prirodni logaritam, nakon čega su se vrijednosti u repu poklopile s Excelovima
Predznak x odlučuje o repu t-razdiobe
Studentova kumulativna t funkcija nosi finesu koju je lako shvatiti naopako. Njezina vrijednost dolazi iz regularizirane nepotpune bete izračunate pri df / (df + x²), ali ta beta vrijednost jest vjerojatnost u repu iza iznosa od x, a ne kumulativna vjerojatnost do x. Simetričan oblik t-razdiobe znači da pretvorba ovisi o tome na kojoj strani nule x leži
// Studentov t CDF. ib je regularizirana nepotpuna beta pri df/(df+x*x),
// koja mjeri simetrični rep. Kumulativna vrijednost ovisi o
// predznaku x; vraćanje nepretvorenog ib daje pogrešan rep.
ib := BetaIF(df / 2, 0.5, df / (df + x * x));
if x > 0 then
  result := 1 - 0.5 * ib        // iznad sredine: jedan minus polovica repa
else if x < 0 then
  result := 0.5 * ib            // ispod sredine: polovica repa
else
  result := 0.5;                // točno na sredini
Za x iznad nule kumulativna je vjerojatnost jedan minus polovica simetričnog repa; za x ispod nule polovica je tog repa; u nuli je točno jedna polovica. Vratite beta vrijednost izravno i prijavljujete pogrešnu stranu razdiobe, promašenu za cijelo tijelo krivulje pri bilo kojem x različitom od nule. Varijante s desnim repom i s dva repa grade se na istoj grani, i zato T.DIST.2T(1,1) vraća 0.5, a T.DIST(1,1,TRUE) 0.75, dok inverz T.INV raspolavlja prema tom ispravljenom CDF-u pa se povratni put zatvara
Ništa od ovoga iz ćelije nije vidljivo, a to je i namjeravani ishod. Napišete formulu i pročitate broj koji se slaže s Excelom. Ako mehanizam proširujete vlastitom logikom, mehaniku registriranja funkcije pokriva naš vodič kroz mehanizam formula i prilagođene funkcije, a način na koji formule sežu preko listova i imenovanih područja pokriva članak o definiranim imenima i formulama među listovima. Sve to dolazi u sklopu komponente HotXLS Delphi spreadsheet component za Delphi i C++Builder, uz API-je za čitanje, zapisivanje, grafikone i oblikovanje obrađene drugdje na ovom blogu