PDFium Component בודק שקילות מטא-נתונים Info-XMP של PDF/A עם TPdf.InspectPdfAMetadata ומתקן אותה עם TPdf.NormalizePdfAMetadata. ISO 19005-1 (כפי שתוקן על ידי Cor.1) מחייב כל אחת משמונת כניסות ה-Info הממופות, מ-Title ועד ModDate, לשאת את אותו ערך כמו המאפיין XMP שלה, ולא רק להתקיים; הבדיקה קוראת את צורת ה-RDF הנכונה, מתאימה מרחבי שמות לפי URI ומשווה תאריכים בתור רגעים
דוח הבאג שבדרך כלל פותח את השיחה הזאת נראה תמים. מערכת ניהול מסמכים חותמת /ModDate חדשה לתוך מילון ה-Info בכל שמירה מצטברת, משאירה את חבילת ה-XMP לנפשה, וחצי שנה אחר כך ביקורת ארכיון מסמנת אלפי קבצים כלא תואמים. שני התאריכים שם. הם פשוט הפסיקו להסכים בעריכה הראשונה, ובדיקת נוכחות לעולם לא שמה לב. עריכות Title שנעשו דרך API של Info בלבד, ומחרוזת Author כמו Finance; Controlling שכלי כלשהו פיצל לשני פריטי dc:creator, נכשלות באותו אופן
למה PDF/A דוחה מטא-נתונים שקיימים בשני המקומות?
PDF/A דוחה זאת כי ISO 19005-1 §6.7.3 הוא כלל ערך, לא כלל נוכחות: טבלה 1 ממפה שמונה מפתחות Info למאפייני XMP, וברגע שמפתח Info נוכח, המאפיין XMP הממופה חייב להחזיק ערך שקול. הסורק ברמת הבייטים שמתואר במאמר על בדיקת preflight של PDF/A עם PDFium Component מאשר רק ש-xmp:CreateDate ו-xmp:ModifyDate קיימים (pvaiMissingXmpDates). החל מ-v3.72.0, TPdf.ValidatePdfA מריץ בנוסף את השוואת הערכים המלאה ומוסיף pvaiInfoXmpValueMismatch לסט הסוגיות כשחבילת XMP קיימת אבל חולקת על Info (חבילה שאי אפשר לפרס נחשבת חולקת). חבילה חסרה נשארת מדווחת בתור pvaiMissingXmpMetadata, כך ששתי הסוגיות לעולם לא סופרות כפול את אותו פגם
איזו צורת RDF דורש כל מאפיין XMP ממופה?
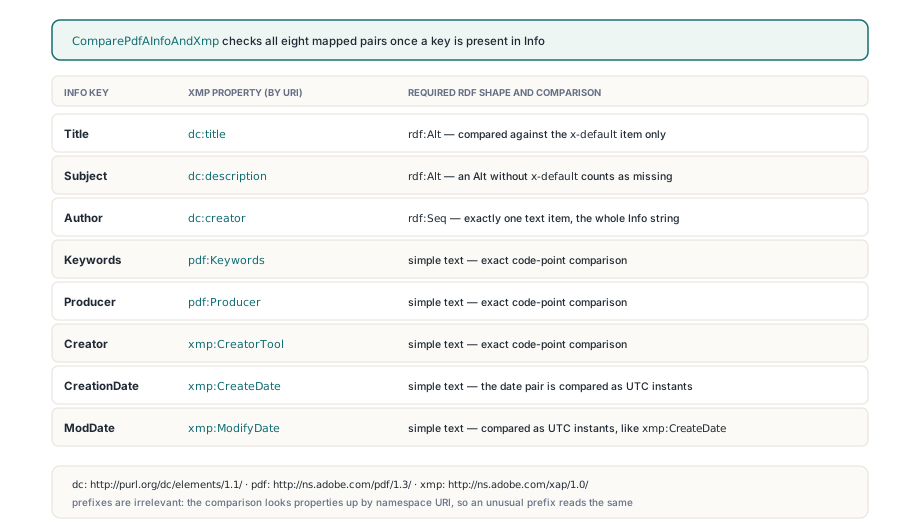
לכל אחד משמונת המיפויים יש טיפוס XMP קבוע, וערך נכון במיכל הלא נכון עדיין נכשל. ComparePdfAInfoAndXmp ב-FPdfPdfa.pas מאתר מאפיינים לפי URI של מרחב שמות, כך שחבילה שקושרת את http://purl.org/dc/elements/1.1/ לקידומת לא שגרתית נקראת בדיוק כמו כזאת שמשתמשת ב-dc. הצורות הנדרשות הן:
- Title →
dc:titleו-Subject →dc:description: חלופת שפה שלrdf:Alt, שמושווית מול הפריטx-defaultשלה בלבד (התגית של השפה מותאמת בלי תלות ברישיות); Alt בליx-defaultנחשב חסר - Author →
dc:creator:rdf:Seqעם פריט טקסט אחד בדיוק שמחזיק את מחרוזת ה-Info כולה, כך שרשימת מחברים המופרדת בנקודות-פסיק נשארת כניסה אחת - Keywords →
pdf:Keywordsו-Producer →pdf:Producer(מרחב שמותhttp://ns.adobe.com/pdf/1.3/): מאפייני טקסט פשוטים - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(מרחב שמותhttp://ns.adobe.com/xap/1.0/): מאפייני טקסט פשוטים
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
ערכי טקסט מושווים בתור רצפי נקודות קוד Unicode מדויקים, בלי חיתוך, קיפול רישיות או נרמול. רווח מיותר בסוף, או é מורכב מראש בצד אחד ו-e מפורק בתוספת סימן משלב בצד השני, הוא אי-התאמה אמיתית. הצד של ה-Info מגיע תמיד מהפענוח של PDFium עצמו לטקסט PDFDocEncoding ו-UTF-16 דרך FPDF_GetMetaText, מה שמונע מהספרייה לממש מחדש פענוח מחרוזות ולטעות בו בעדינות; הצד של ה-XMP נקי בדיוק כמו הבייטים שיצרו אותו, ומכאן ש-מלכודות ה-codepage שמשחיתות מטא-נתוני XMP תחת Free Pascal רלוונטיות גם כאן
מתי תאריך PDF ותאריך XMP שווים?
תאריך PDF ותאריך XMP שווים כשהם מתארים את אותו רגע עד לשנייה, עם אותה ידיעת אזור זמן בשני הצדדים. שני הפרסרים מקבלים דיוק מצומצם חוקי, כך ש-D:2026 ו-2026 שניהם משמעותם 1 בינואר 2026, 00:00:00. כששני הערכים נושאים אזור, הם מומרים ל-UTC לפני ההשוואה: D:20260827093659+08'00' שווה ל-2026-08-27T01:36:59Z. כשאף אחד מהם לא נושא אזור, הרכיבים המקומיים מושווים כפי שנכתבו. כשרק צד אחד מחזיק אזור, התוצאה היא pamsValueMismatch, כי המצאת היסט היא ניחוש. שנייה שברית שאינה אפס כמו .250 ב-XMP גם כופה אי-התאמה, מכיוון שלתאריך PDF אין דרך לבטא אותה ועיגול שקט שלה יסתיר חוסר הסכמה אמיתי; .000 מתקבל. ערכים שאי אפשר לפרס מדווחים בנפרד בתור pamsInvalidInfoDate או pamsInvalidXmpDate
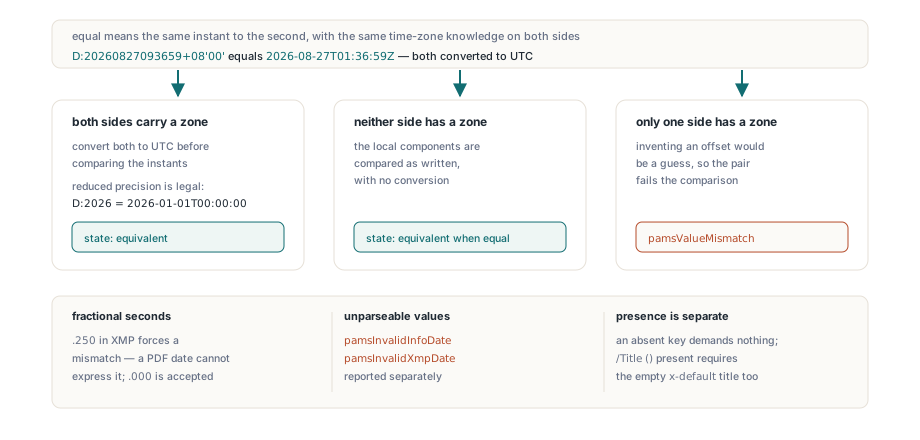
לנוכחות יש כלל משלה. TPdfAMetadataValues.Present הוא קבוצה שממולאת על ידי מעבר על מילון ה-/Info של ה-trailer הפעיל, והיא מפרידה בין "מפתח נעדר" לבין "מפתח נוכח עם מחרוזת ריקה". מפתח נעדר מניב pamsNotRequired ולא דורש דבר מה-XMP; /Title () נוכח, ולכן חבילת ה-XMP חייבת לשאת גם כותרת x-default ריקה
איך בוחנים מטא-נתוני Info ו-XMP לפני שמירה?
TPdf.InspectPdfAMetadata מחזיר TPdfAMetadataReport עם TPdfAMetadataComparison אחד לכל שדה, כל אחד מחזיק את ערך ה-Info, את ערך ה-XMP ו-TPdfAMetadataState, כך שניתן להסביר כשל בלי לבצע הנדס לאחור של דגל אימות בודד. MismatchFields מסכם את הסט הנכשל, HasXmpPacket אומר לך אם נמצאה חבילה, ו-XmpParseError נושא את הודעת הפרסר כשהחבילה קיימת אבל לא ניתנת לקריאה
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
מה NormalizePdfAMetadata משנה, וממה הוא מסרב?
TPdf.NormalizePdfAMetadata מתייחס למילון ה-Info בתור מקור האמת וכותב מחדש רק את המאפיינים של XMP שהשדה שלהם נחת ב-MismatchFields; כל השאר בחבילה שורד. Title ו-Subject נכתבים לתוך הפריט x-default בזמן שחלופות שפה אחרות נשארות שלמות, Author הופך ל-rdf:Seq של פריט אחד, מרחבי שמות לא מוכרים ומאפיינים לא קשורים נשמרים, ומאפייני XMP עבור מפתחות Info נעדרים נותרים בלי מגע. תאריך Info עם אזור נכתב כתאריך XMP קנוני של UTC עם סיומת Z; כזה ללא אזור שומר על הרכיבים המקומיים שלו. ה-overload לקובץ שומר דרך קובץ זמני והחלפה אטומית, והעדכון של ה-XMP עצמו מצורף בתור עדכון מצטבר
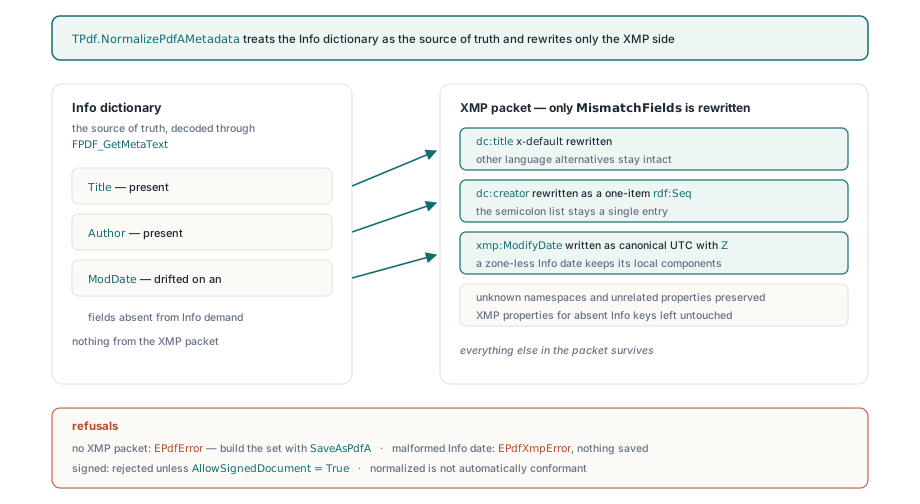
הסירובים מכוונים. בלי חבילת XMP המתודה מעלה EPdfError, כי בניית סט זיהוי ומטא-נתונים מלא של PDF/A היא עבודתה של SaveAsPdfA, שמכוסה במאמר על יצירת קבצי ארכיון PDF/A עם PDFium Component. תאריך Info פגום מעלה EPdfXmpError במקום לכתוב ערך שגוי שנראה סביר, ולא נשמר דבר. מסמכים חתומים נדחים אלא אם הקורא מעביר AllowSignedDocument = True. שקילות היא רק כלל אחד של ISO 19005-1 גם כן, כך שקובץ מנורמל אינו אוטומטית קובץ תואם
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // כבר עקבי, לא נוגעים בקובץ
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // תאריך Info פגום או חבילה שאי אפשר לקרוא
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
הרצת ההשוואה על חבילת XMP משלכם
ComparePdfAInfoAndXmp ו-SynchronizePdfAInfoToXmp הן פונקציות פשוטות ב-FPdfPdfa שעובדות על TPdfXmpPacket בלי מסמך טעון, מה שמתאים לבדיקות יחידה ול-pipelines שמרכיבים XMP מתבנית. המלכודת האחת היא Present: רשומה שאותחלה עם Default(TPdfAMetadataValues) מחזיקה קבוצה ריקה, כל שדה אז מדווח pamsNotRequired, וההשוואה עוברת בריקנות לא משנה אילו ערכים מילאתם
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present מכריע אילו שדות חובה; ערכים לבדם מוזנחים
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // xmp:ModifyDate עכשיו 2026-08-27T01:36:59Z, ו-dc:creator rdf:Seq של פריט אחד
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
אם ה-pipeline שלכם מארכז מסמכים שמערכות אחרות ממשיכות לערוך, שלבו סריקת לילה של InspectPdfAMetadata עם NormalizePdfAMetadata עבור הקבצים שסוטים, והחזיקו את ValidatePdfA בתור השער לפני שמשהו יוצא לאחסון ארוך-טווח. הדוח המטופוס, נתיב התיקון ושאר כלי ה-PDF/A נשלחים בתוך PDFium Component עבור Delphi ו-C++Builder