רכיב PDFium גרסה 3.117.0 מקשר טבלה שנשברת על גבול עמוד כששני הקטעים נוגעים בשולי העמוד, או כששום טקסט גוף לא יושב מתחת לקטע הראשון ומעל השני, תוך התעלמות מכותרות עליונות ותחתונות. ExtractDocumentTables מחילה את הבדיקה המודעת-תוכן הזו כחלופה לבדיקת שולי העמוד הישנה, מסרבת לקטע בעמוד הבא ששורתו הראשונה היא תא כיתוב בודד ברוחב מלא, ומשאירה שורה בודדת שנשפכת לעמוד הבא כחלק משרשרת ההמשכיות שלה
המאמר על זיהוי וחילוץ טבלאות הציג את ההמשכיות כארבעה שערים מחמירים והתייחס ל"נוגע בשולי העמוד" כאחד מהם. התיאור הזה היה מדויק לגרסה שהוא כיסה, והוא גם היה שגוי לרוב הטבלאות שאנשים באמת מאכילים בהן את הרכיב. המאמר הזה הוא התיקון: אילו מסמכים בדיקת השוליים לא מצליחה לטפל בהם, מה החליף אותה, ושני מקרי הצד שהתיקון גרר איתו
למה בדיקת שולי העמוד נכשלת בייצוא מ-Word?
בדיקת שולי העמוד נכשלת כי מעבד תמלילים מפסיק לפרוס שורות בשוליים התחתונים, לא בקצה הנייר. עם ברירת המחדל ContinuationMargin של 36 נקודות, הכלל המקורי דרש שהקצה התחתון של הקטע המוקדם ייפול בתוך 36 נקודות מתחתית העמוד ושהקצה העליון של הקטע המאוחר ייפול בתוך 36 נקודות מראש העמוד. מסמך שיוצא מ-Word עם שוליים של אינץ' כברירת מחדל ממקם את השורה האחרונה לפחות 72 נקודות מעל תחתית העמוד, ויותר אם יש כותרת תחתונה, כך שהתנאי מעולם לא התקיים. כל טבלה ארוכה במסמך כזה חזרה כקטעים עצמאיים עם ContinuationGroup אפס, והקורא חזר לתפור ביד. הבדיקה עדיין הגיונית למה שהיא תוכננה סביבו: דוחות שנוצרו על ידי מנועי פריסה שממלאים עמוד לתיבת תוכן קבועה ומתחילים את העמוד הבא צמוד לראש. זה לא כלל גרוע, זה כלל חלקי, ולכן גרסה 3.117.0 שמרה אותו והוסיפה מסלול שני במקום להחליף אותו
מה בודקת הבדיקה המודעת-תוכן במקום זאת?
הבדיקה המודעת-תוכן בודקת אם משהו שאינו הטבלה תופס את החלל שבין שני הקטעים, לפי תיבות המילים של כל עמוד ולא לפי הגאומטריה של העמוד. בזמן ש-ExtractDocumentTables עוברת על המסמך היא רושמת, לכל עמוד, את הקצה התחתון הנמוך ביותר של כל מילה שראשה מעל רצועת הכותרת התחתונה, ואת הקצה העליון הגבוה ביותר של כל מילה שתחתיתה מתחת לרצועת הכותרת העליונה. שתי הרצועות בעומק ContinuationMargin נקודות, כך שאותה אפשרות משמשת כעת בשני תפקידים — מרווח בשולי העמוד וגובה אזורי הכותרת העליונה והתחתונה. זוג קטעים עובר כשהקצה התחתון של המוקדם נמצא בגובה טקסט הגוף הנמוך ביותר בעמוד שלו או מתחתיו, והקצה העליון של המאוחר נמצא בגובה טקסט הגוף הגבוה ביותר בעמוד הבא או מעליו, כל אחד בתוך AlignmentTolerance. במילים פשוטות: הטבלה הייתה הדבר האחרון בעמוד N והראשון בעמוד N+1, ומספר עמוד או כותרת מסמך ברצועת השוליים לא נחשבים. ההחרגה הזו אינה שרירותית. ISO 32000-1 §14.8.2.2 מסווג כותרות עליונות ותחתונות כחפצי עימוד, תוכן שקיים בגלל שבירת העמוד ולא למרותה, ואותו רעיון שמאפשר לקורא מתויג לדלג עליהן הוא מה שמאפשר לטבלה להמשיך מעברן. המאמר על תוכן מסומן מכסה איך קבצים מתויגים מצהירים על החפצים האלה במפורש; כאן הסיווג מוסק מהמיקום, כי רוב הטבלאות המיוצאות לא נושאות תגים בכלל
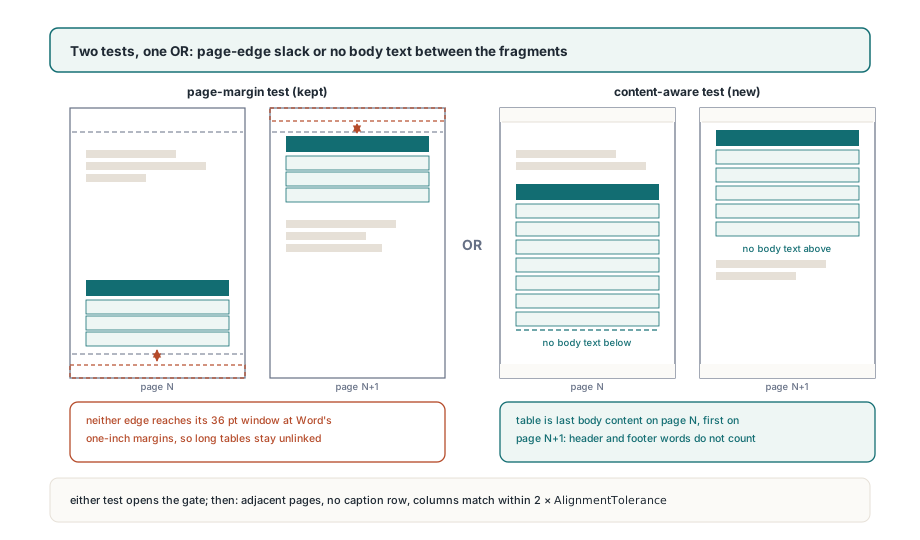
שתי הבדיקות מתחברות ב-OR. דוח של מנוע פריסה שהטבלאות שלו מגיעות עד קצה הנייר עובר את הראשונה; ייצוא מ-Word שהטבלאות שלו נעצרות בשוליים עובר את השנייה; מסמך שעושה גם וגם עובר פעמיים. רק אחרי שאחת מהן מצליחה רצים שאר השערים, והם רצים בסדר קבוע: מספרי העמודים חייבים להיות סמוכים, הקטע המאוחר לא יכול להיפתח בשורת כיתוב, וגבולות העמודות חייבים להתאים בתוך פעמיים AlignmentTolerance, שזה 6 נקודות בברירות המחדל. המנייה היא TPdfTableContinuation עם הערכים ptcNone, ptcStart, ptcMiddle ו-ptcEnd. קטע שסומן ptcEnd ואז נקשר הלאה לעמוד נוסף מקודם ל-ptcMiddle, כך שטבלה בת שלושה עמודים נקראת התחלה, אמצע, סוף לפי סדר העמודים. מספרי הקבוצות מתחילים ב-1 ו-0 פירושו לא מקושר, ו-ToJson פולט את אותו מידע בחברים continuation ו-continuationGroup, שזו הצורה שעדיפה אם שירות במורד הזרם עושה את התפירה
uses
  PDFium;

var
  Pdf: TPdf;
  Options: TPdfTableExtractionOptions;
  Tables: TPdfTables;
  I: Integer;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'itinerary-from-word.pdf';
    Pdf.LoadDocument;

    Options := TPdfTableExtractionOptions.Default;
    Options.DetectContinuations := True;     // ברירת מחדל; מוצג לשם הבהירות
    Options.ContinuationMargin := 54;        // כותרת תחתונה בת שתי שורות, בעומק ~50 נקודות

    Tables := Pdf.ExtractDocumentTables(Options);
    for I := 0 to High(Tables) do
      case Tables[I].Continuation of
        ptcStart:
          Writeln(Format('group %d starts on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
        ptcMiddle, ptcEnd:
          Writeln(Format('group %d continues on page %d (%d rows)',
            [Tables[I].ContinuationGroup, Tables[I].PageNumber,
             Tables[I].RowCount]));
      else
        Writeln(Format('standalone table on page %d (%d rows)',
          [Tables[I].PageNumber, Tables[I].RowCount]));
      end;
  finally
    Pdf.Free;
  end;
end;
איך שורת כיתוב מונעת משתי טבלאות להתמזג?
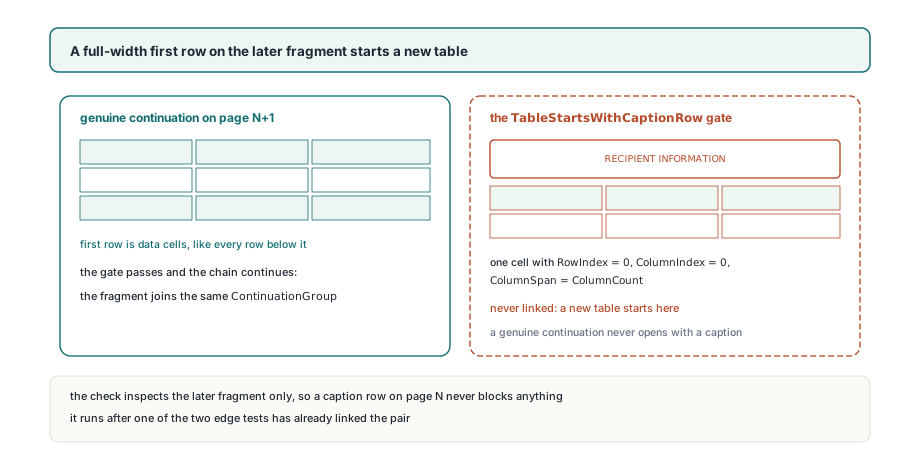
קטע בעמוד הבא ששורתו הראשונה היא תא אחד שמשתרע על כל העמודות מטופל כטבלה חדשה, אף פעם לא כהמשך של הקודמת. הכלל הזה קיים כי הבדיקה המודעת-תוכן, לבדה, מקשרת בשקיקה יתרה. המקרה שחשף אותו היה טופס בסגנון תמלול: טבלה נגמרת סמוך לתחתית עמוד 1, טבלה שנייה עם רוחבי עמודות זהים מתחילה סמוך לראש עמוד 2, שום דבר מלבד הכותרת התחתונה לא יושב ביניהן, והעמודות מתאימות עד לנקודה. תחת בדיקת השוליים השתיים מעולם לא נפגשו כי אף אחת מהן לא נגעה בקצה; תחת בדיקת התוכן הן התקשרו מיד, וטופס עם מקטעים הפך לרשת אחת חסרת היגיון. מה שמפריד ביניהן נראה במבנה התאים. הטבלה השנייה נפתחת בכיתוב מקטע כמו "RECIPIENT INFORMATION" שמונח כתא ממוזג בודד ברוחב המלא, והמשכיות אמיתית אף פעם לא עושה זאת, כי הכיתוב שייך לטבלה שכבר התחילה בעמוד הקודם. TableStartsWithCaptionRow מקודדת בדיוק את זה: בקטע יש לפחות שתי עמודות והוא מכיל תא עם RowIndex = 0, ColumnIndex = 0 ו-ColumnSpan = ColumnCount. הבדיקה רצה רק על הקטע המאוחר, כך שטבלה ששורת הכיתוב שלה יושבת בעמוד הראשון שלה לא מושפעת; הכיתוב בעמוד N, ורק הקטע של עמוד N+1 נבדק
השוואת העמודות שבאה אחר כך, TablesHaveMatchingColumns, מחמירה יותר מ"אותו מספר עמודות". היא בונה מחדש את מיקומי הגבולות של כל קטע מתיבות התאים, משלימה גבולות שתאים ממוזגים מסתירים, ודוחה את הזוג כשגבול כלשהו סוטה ביותר מהסבילות. שתי טבלאות בנות ארבע עמודות עם פרופורציות שונות נשארות לכן נפרדות גם כשכל השאר מתיישר
מה קורה לשורה בודדת שנשפכת לעמוד הבא?
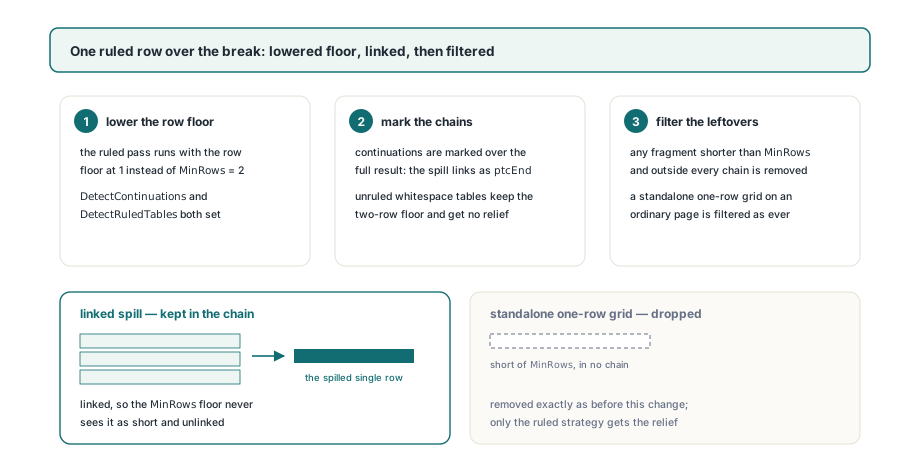
רשת עם קווים שמעבירה שורה אחת לעמוד הבא מזוהה כעת ומקושרת, בתנאי שהיא נכנסת לשרשרת המשכיות; לבדה היא נזרקת. ברירת המחדל MinRows של 2 קיימת כדי למנוע מזוג שורות תקוע לדווח כטבלה, אבל שורה אחרונה שנדחפה מעבר לשבירה היא שורה אמיתית שרצפה קשיחה של 2 השליכה בשקט, ושאר הטבלה נראתה שלמה כשהיא לא הייתה. הסריקה ברמת המסמך מטפלת בזה בשלושה שלבים. כשגם DetectContinuations וגם DetectRuledTables דלוקים, המעבר לכל עמוד מריץ את מזהה הרשתות עם רצפת השורות מונמכת זמנית ל-1, ולכן ExtractTables מקבלת כעת MinRows של 1 לרשתות עם קווים בעוד זיהוי לפי רווחים לבנים שומר על רצפה פנימית של 2. ההמשכיות מסומנות על כל התוצאה. ואז כל טבלה שקצרה מ-MinRows של הקורא ושאינה חלק משום שרשרת מוסרת. הקטע בן השורה הבודדת שורד רק כי הוא קושר, ורשת בת שורה אחת באמצע עמוד רגיל אחרת מסוננת בדיוק כמו קודם
// לבנות כל שרשרת מחדש כ-CSV אחד, ולהשמיט שורות כותרת חוזרות
// בקטעי ההמשכיות
procedure ExportChains(const Tables: TPdfTables; const Folder: string);
var
  I, R: Integer;
  Lines: TStringList;
  Csv: TStringList;
begin
  Csv := TStringList.Create;
  Lines := TStringList.Create;
  try
    for I := 0 to High(Tables) do
    begin
      if Tables[I].Continuation in [ptcNone, ptcStart] then
        Csv.Clear;
      Lines.Text := string(Tables[I].ToCsv);
      if (Tables[I].Continuation in [ptcMiddle, ptcEnd]) and
         (Lines.Count > 1) and (Tables[I].RowCount > 1) then
        Lines.Delete(0);            // כותרת שחזרה על עצמה מהמעבד תמלילים
      for R := 0 to Lines.Count - 1 do
        Csv.Add(Lines[R]);
      if Tables[I].Continuation in [ptcNone, ptcEnd] then
        Csv.SaveToFile(Format('%s\page%d-group%d.csv',
          [Folder, Tables[I].PageNumber, Tables[I].ContinuationGroup]));
    end;
  finally
    Lines.Free;
    Csv.Free;
  end;
end;
שני פרטים בשגרה הזו מכוונים. השפיכה בת השורה האחת לא נגזרת אף פעם, כי השומר על RowCount משאיר אותה, ומעבד תמלילים שחוזר על שורת הכותרת בכל עמוד מפיק קטע ששורתו הראשונה היא הכותרת שוב, כך שהשמטת שורה אפס בקטעי אמצע וסוף נכונה למקרה הזה ושגויה לגנרטור שלא חוזר על כותרות. בדקו מסמך אחד לפני שאתם משחררים את השגרה על תיקייה
איפה הכללים עדיין נעצרים
הבדיקה המודעת-תוכן טובה בדיוק כמו שכבת הטקסט שהיא קוראת. בעמוד סרוק בלי טקסט בכלל, קיצוני טקסט הגוף שנרשמו נופלים בחזרה לגבולות העמוד, תנאי ה"אין כלום באמצע" מתקיים באופן ריק, ורק שערי שורת הכיתוב והעמודות נשארים; רשת עם קווים בעמוד כזה עדיין נמצאת כשלד ריק, כך שהשרשרת עשויה להתקשר נכון, אבל שום דבר בטקסט שסביב לא אומת באמת. הוסיפו שכבת טקסט קודם אם זה חשוב. כותרות תחתונות שמוצגות כתמונות ולא כטקסט בלתי נראות להיגיון הרצועות ולא מזיקות מאותה סיבה
הרצועות הן מספר אחד. כותרת תחתונה עמוקה מ-ContinuationMargin משאירה את שורותיה התחתונות בתוך אזור הגוף, מה שגורם לקטע המוקדם להיראות כאילו טקסט עוקב אחריו וחוסם את הקישור; העלו את האפשרות לעומק הרצועה האמיתי, כמו שהדוגמה הראשונה עושה. העלו אותה רחוק מדי ופסקה קצרה שסוגרת סמוך לתחתית העמוד מחליקה לתוך הרצועה ומודלגת, מה שמקשר טבלה לכל מה שבא אחריה. לכלל הכיתוב יש כשל במראה: גנרטור שכותב באנר ממוזג של "continued" כשורה הראשונה של כל קטע המשכיות יגרום לקטעים האלה להידחות כטבלאות חדשות, והתרופה היחידה היום היא לתפור בעצמכם לפי ContinuationGroup בלי להרפות משום דבר, כי לכלל אין מתג
טבלאות שזוהו לפי רווחים לבנים לא מקבלות שום הקלה בשורה בודדת. אסטרטגיית הרווחים הלבנים צריכה שתי שורות מיושרות כדי לראות טבלה בכלל, כך שטבלה בלי קווים שנשפכת בשורה אחת עדיין מדווחת קצרה באותה שורה. כשאתם נתקלים בזה, תיבות המילים שמאחורי בלוקי טקסט מובנים וסדר קריאה נותנות לכם את המיקומים הגולמיים לשחזר אותה. בסט הדגימות שהניע את העבודה הזו, שלושה עשר ייצואים של מעבדי תמלילים ודפדפנים, חמשת המסמכים עם טבלאות מרובות עמודים אמיתיות התקשרו כולם לשרשראות בודדות וטופס התמלול שהתמזג קודם נשאר נפרד, וזה הרף שהגרסה נמדדה מולו, לא הבטחה לגבי כל פריסה
סימון ההמשכיות, כלל הכיתוב ומעבר השורה הבודדת כולם חיים במסלול ברמת המסמך שמשותף לבניות Delphi, C++Builder ו-Lazarus; ה-API המלא של חילוץ הטבלאות מתואר בעמוד רכיב PDFium ל-Delphi