הנח דוח סרוק של 80 מ"ב מאחורי קישור, פתח אותו בדפדפן, וראה מה קורה: המציג יושב על חלונית ריקה עד שחלק גדול מהבתים האלה הגיעו, ואז צובע את עמוד אחד בבת אחת. קפוץ לעמוד 40 ובקובץ בנוי גרוע ההורדה כולה עשויה להתחיל מחדש. החלק המתסכל הוא שהקורא רצה מלכתחילה רק את העמוד הראשון. לינאריזציה היא התשובה המבנית לבעיה הזו. היא מסדרת מחדש PDF כך שמציג יוכל לשרטט את עמוד הפתיחה מקידומת קטנה של הקובץ ולהביא את השאר לפי דרישה, ולכן Adobe משווקת את התכונה כ-"Fast Web View."
שום דבר מכל זה אינו פורמט קובץ אחר. PDF מלואנר הוא PDF רגיל שקורא תואם יפתח בלי טיפול מיוחד. הטריק נמצא כולו באופן שבו הבתים מסודרים ובשני מבנים נוספים שהקובץ נושא. ISO 32000-1 מפרט את כל הסידור בנספח F, וברגע שראית את הפריסה, ההתנהגות מפסיקה להיראות כקסם ומתחילה להיראות כעסקה מכוונת של סדר הקובץ תמורת השהיית הצביעה הראשונה
מה לינאריזציה באמת מסדרת מחדש
PDF רגיל יכול לפזר את האובייקטים שלו כמעט בכל סדר. טבלת ההפניות הצולבות בסוף הקובץ היא מה שמאפשר זאת: קורא מדלג אל הסוף, קורא את המצביע startxref, טוען את ה-xref, ומשם יכול לאתר כל אובייקט לפי ההיסט שלו. התכנון הזה מצוין עבור קבצים מקומיים, שבהם דילוג אל הסוף אינו עולה דבר, וגרוע עבור קובץ שזורם ברשת, שבו הסוף הוא בדיוק החלק שמגיע אחרון. כדי לשרטט את עמוד אחד קורא רגיל זקוק לאובייקט העמוד, לזרם התוכן שלו, לגופנים שהוא מפנה אליהם, ולכל תמונה שהוא מצייר, ובקובץ לא מסודר אלה יכולים לשבת בכל מקום, כולל המגה-בייט האחרון
לינאריזציה מתקנת את הסדר. האובייקטים הדרושים כדי להציג את העמוד הראשון נאספים לבלוק רציף סמוך לקדמה, מיד אחרי מקטע כותרת קטן, כך שהם מגיעים מוקדם בזרם הבתים. כל השאר, העמודים הנותרים והמשאבים שהם חולקים, בא ברצף צפוי. טבלת הפניות צולבות שנייה ומלאה עדיין חיה בסוף עבור קוראים שמתעלמים מהאופטימיזציה, אבל קובץ מלואנר גם ממקם בקדמה הפניה צולבת של העמוד הראשון ואת הפרמטרים שקורא זורם זקוק להם. הקורא כבר אינו צריך להגיע אל הזנב לפני שהוא יכול לצייר משהו
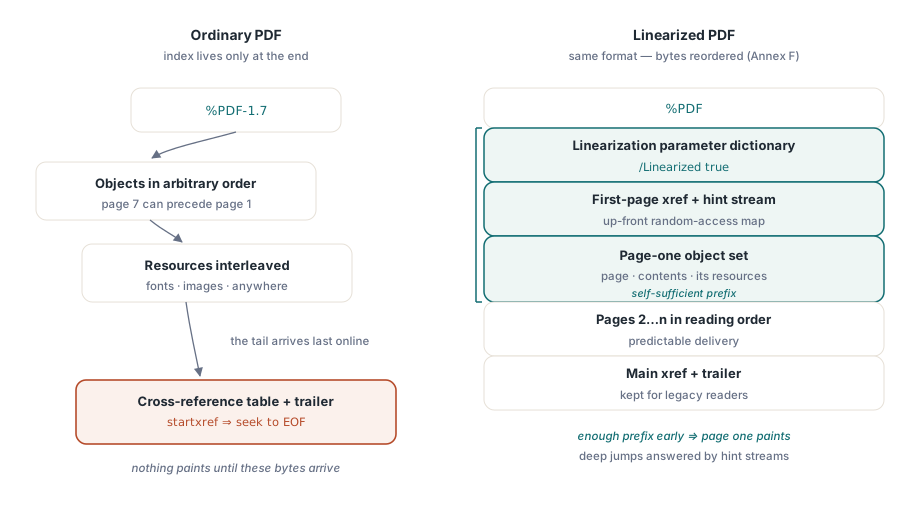
קבוצת האובייקטים של העמוד הראשון ומילון פרמטרי הלינאריזציה
האובייקט הראשון ממש בקובץ מלואנר, אחרי כותרת ה-%PDF, הוא מילון פרמטרי הלינאריזציה. זה מה שקורא זורם מחפש כדי להחליט אם האופטימיזציה קיימת ואיך להשתמש בה. המילון רושם את אורך הקובץ כולו, את היסט הבתים שבו מתחיל מקטע ההפניות הצולבות הראשי, את מספר האובייקט של העמוד הראשון, ואת המיקום והאורך של זרם הרמזים שבא אחריו. עם המספרים האלה קורא יודע, מקילובייטי הפתיחה בלבד, כמה עליו להביא כדי להציג את עמוד אחד והיכן לחפש את האינדקס שמאפשר לו לקפוץ למקום אחר
נספח F קפדני בנוגע למשמעות "העמוד הראשון" כאן. מקטע העמוד הראשון חייב להכיל את אובייקט העמוד עצמו, את זרמי התוכן שלו, ואת המשאבים שהזרמים האלה מפנים אליהם, כך שהעמוד יהיה עצמאי ברגע שהקידומת הזו ירדה. משאבים משותפים, גופן שמשמש בכל עמוד, לוגו שחוזר בכותרת, מטופלים במיוחד: הם מופיעים מוקדם מספיק כדי לשרת את העמוד הראשון אך מסומנים כמשותפים כך שהקורא לא יביא אותם שוב כשהוא ישרטט מאוחר יותר את עמוד 30. ההבחנה הזו בין אובייקטים פרטיים לעמוד לבין אובייקטים משותפים היא החלק שרוב ה"מייעלים" תוצרת בית מפספסים, ופספוס שלו הוא מה שמייצר קובץ שטוען שהוא מלואנר אך עדיין נתקע
זרמי רמזים: האינדקס שהופך קפיצות בין עמודים לזולות
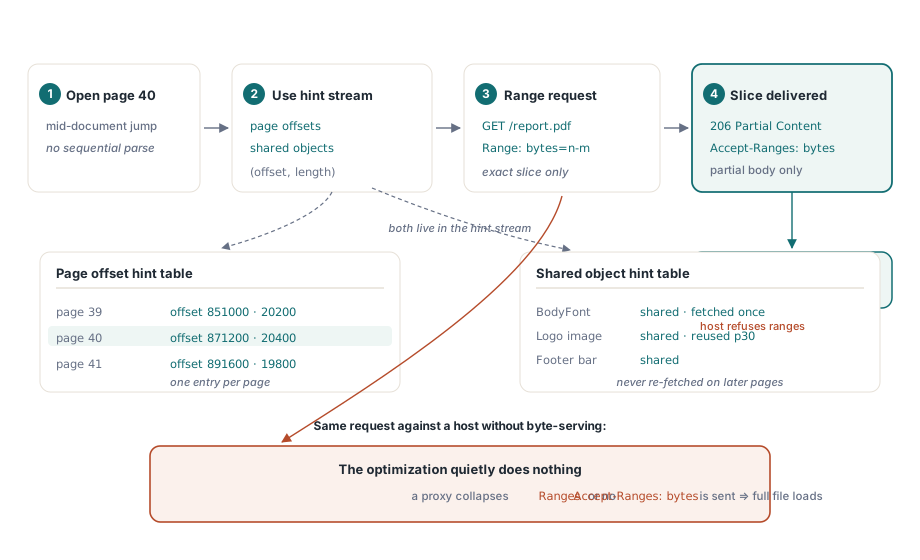
הצגת עמוד אחד במהירות היא רק מחצית הערך. המחצית השנייה היא קפיצה לעמוד שרירותי בלי להוריד את כל מה שביניהם, וזה מה שזרמי הרמזים מספקים. קובץ מלואנר נושא טבלת רמזים של היסטי עמודים וטבלת רמזים של אובייקטים משותפים, המאוחסנות כזרם שמופנה אליו ממילון הפרמטרים. טבלת היסטי העמודים רושמת, עבור כל עמוד, היכן האובייקטים שלו מתחילים בקובץ ולאורך כמה הם רצים. טבלת האובייקטים המשותפים עושה את אותו הדבר עבור משאבים שמשמשים על פני עמודים מרובים
בהינתן הטבלאות האלה, קורא שרוצה את עמוד 40 אינו מנתח את הקובץ ברצף. הוא מתייעץ עם טבלת הרמזים כדי ללמוד את טווח הבתים שעמוד 40 תופס, מבקש מהשרת בדיוק את הטווח הזה, ומשרטט את העמוד ברגע שהבתים האלה מגיעים, ושולף דרך אותו מנגנון כל משאב משותף שאינו כבר בידיו. זרם הרמזים הוא, למעשה, מפת גישה אקראית הפרוסה על המסמך, והוא הסיבה שקובץ מלואנר היטב בן 500 עמודים מרגיש מגיב על קו איטי בעוד קובץ לא ממוטב באותו גודל אינו כזה
למה השרת חייב לשתף פעולה
לינאריזציה מניחה שהתעבורה יכולה לספק פרוסות שרירותיות של הקובץ, וההנחה הזו ראויה לבדיקה לפני שאתה זוקף לחובת הפורמט תוצאות גרועות. המנגנון הוא הגשת בתים של HTTP: הקורא מנפיק בקשות טווח, והשרת עונה להן בתשובות 206 Partial Content. אם השרת אינו מכריז על Accept-Ranges: bytes, או אם פרוקסי או CDN שלפניו מקווצים בקשות טווח להעברות מלאות, לקורא אין דרך להביא את עמוד 40 בבידוד והוא נופל בחזרה להורדת הקובץ כולו. המבנה שבתוך ה-PDF נכון אז לחלוטין ומבוזבז לחלוטין
זה הכשל שמאובחן שגוי לרוב כ"לינאריזציה לא עובדת". הקובץ תקין; נתיב האספקה אינו. לפני שאתה בונה מסמך מחדש, ודא בבקשה מותנית שהמארח באמת מחזיר תוכן חלקי עבור הכתובת שהקורא פונה אליה. מארחים סטטיים רבים עושים זאת כברירת מחדל, ושרתי יישומים ושכבות מטמון רבים שהוגדרו שגוי אינם עושים זאת
עדכונים הדרגתיים שוברים לינאריזציה בשקט
הנה האילוץ שמפתיע אנשים שמייצרים קבצים מלואנרים כהלכה ואז תוהים למה האופטימיזציה מתאדה. לינאריזציה תלויה בפריסה יחידה ומסודרת בקפידה שהאינדקס שלה בקדמה. עדכון הדרגתי מפר זאת מעצם תכנונו. כשכלי מוסיף חתימה, ממלא שדה טופס, או מצרף אנוטציה דרך שמירה הדרגתית, הוא אינו כותב את הקובץ מחדש. הוא מצרף אל הסוף את האובייקטים שהשתנו, מקטע הפניות צולבות חדש, וטריילר חדש, ומשאיר את הבתים המקוריים ללא נגיעה. הצירוף הזה הוא כל העניין בעדכונים הדרגתיים: הוא מהיר, והוא משמר את הגרסה הקודמת לצורך ביקורת או אימות חתימה
תופעת הלוואי היא שלקובץ יש כעת את נתוני ההפניות הצולבות החדשים ביותר בזנב, אחרי בלוק העמוד הראשון שמוקם בקפידה, ומילון פרמטרי הלינאריזציה שבקדמה מתאר פריסה שכבר אינה תואמת לקובץ. קורא תואם מזהה את אי-ההתאמה ומתייחס למסמך כאל PDF רגיל ולא מלואנר. Fast Web View נעלם, אף שהמבנה המלואנר המקורי עדיין יושב שם במחצית הראשונה של הקובץ. אם תצרף כמה עדכונים, כל אחד מהם ערם גרסה נוספת בסוף והפער בין אינדקס הקדמה המיושן לבין המצב האמיתי מתרחב
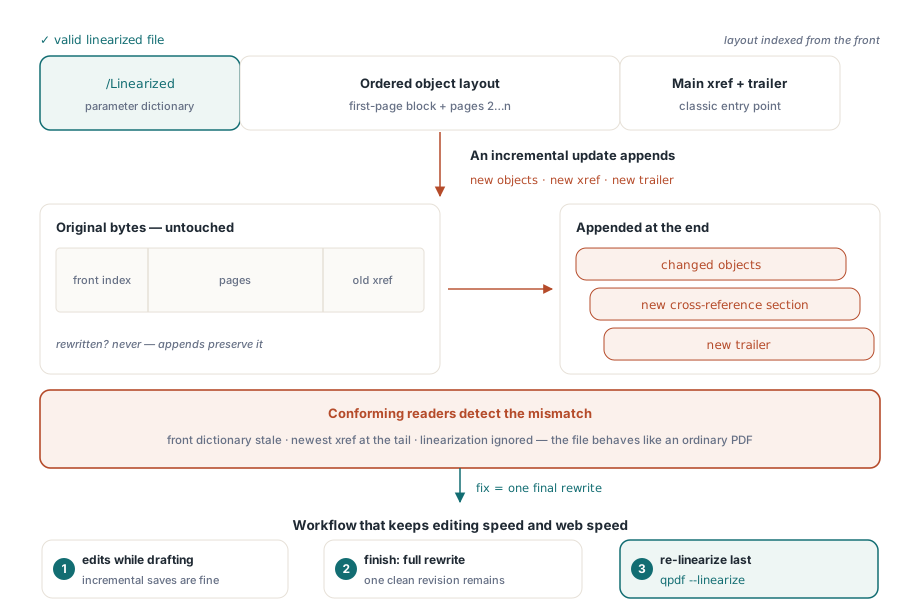
אם זרימת העבודה שלך זקוקה גם לעריכות וגם ל-Fast Web View, הכלל נובע ישירות מהמבנה: ערוך בצורה הדרגתית כל עוד המסמך נזיל, ואז בצע לינאריזציה מחדש פעם אחת בסוף. כתיבה מחדש מלאה היא מה שמשחזר את הפריסה. במונחי HotPDF, זה אומר שעריכה בתהליך עוברת דרך BeginIncrementalUpdate ו-SaveIncrementalUpdate, שמצרפים דלתא, בעוד שלב הסיום טוען את המסמך כולו ומסדר אותו מחדש מאפס עם LoadFromFile ואחריו SaveLoadedDocument, שמשליך את הגרסאות הישנות שהצטברו ופולט פריסה נקייה אחת. אותה עסקה מופיעה עם זרמי אובייקטים: הפעלת UseObjectStreams יחד עם UseXRefStream דוחסת את ההפניות הצולבות ואורזת אובייקטים בצפיפות, וזה עוזר לגודל הקובץ אך, כמו כל בחירה מבנית, חייב להיות מוחל בזמן הכתיבה מחדש הסופית ולא מוברג על גרסה מצורפת
// עריכות תוך כדי תנועה: צרף דלתא, שמור על הגרסאות הקודמות שלמות.
// זה משאיר את הקובץ לא מלואנר.
Pdf.BeginIncrementalUpdate('report.pdf');
Pdf.AddPage;
Pdf.CurrentPage.TextOut(72, 760, 0, 'Addendum');
Pdf.SaveIncrementalUpdate('report.pdf');

// שלב הסיום: סידור מחדש מלא מפיק פריסה נקייה אחת,
// ומשליך את הגרסאות שנערמו. הרץ מחדש את המלאנר שלך על הפלט.
Pdf.LoadFromFile('report.pdf');
Pdf.SaveLoadedDocument('report-final.pdf');
HotPDF אינו חושף שגרת "לינאריזציה" בקריאה אחת, ולכן התבנית המעשית היא להפיק קובץ נקי שנכתב מחדש במלואו ולהריץ עליו כלי ייעול ייעודי. כלי שורת פקודה מטפלים בסידור מחדש ישירות. qpdf כותב קובץ מחדש לצורה מלואנרת בדגל יחיד:
qpdf --linearize report-final.pdf report-web.pdfאיך לדעת אם קובץ מלואנר
אל תסמוך על שם הקובץ או על הכלי שטוען שהפיק אותו; אמת את הבתים. הבדיקה הישירה ביותר היא ראש הקובץ: פתח אותו וחפש את מילון פרמטרי הלינאריזציה כאובייקט הראשון אחרי הכותרת, הנושא את המפתח /Linearized. קיצור דרך מצד הקורא הוא דיאלוג מאפייני המסמך של Acrobat, שמדווח "Fast Web View: Yes" רק כשהמבנה באמת קיים ועדכני
לבדיקות מתוסרטות, qpdf מדווח גם על קיום המבנה וגם על שלמותו, וזה חשוב משום שקובץ יכול לשאת מילון לינאריזציה שכבר אינו משקף את הפריסה שלו, בדיוק המצב שעדכון הדרגתי משאיר אחריו:
# מדווח "File is linearized" ומאמת טבלאות רמזים מול הפריסה
qpdf --check report-web.pdf

# משליך את פרמטרי הליניאריזציה ואת נתוני הרמז בפירוט
qpdf --show-linearization report-web.pdf
שלב האימות הוא זה שמצדיק את קיומו. מעבר שרק מאשר שהמילון קיים יברך בשמחה קובץ שהאינדקס שלו מצביע על היסטים שגויים; בדיקה שמיישבת את טבלאות הרמזים מול מיקומי האובייקטים בפועל היא מה שאומר לך שהאופטימיזציה תחזיק מעמד תחת בקשות טווח של קורא אמיתי
לינאריזציה נשארת שווה יישום בכל מסמך גדול שמוגש ברשת, ובמיוחד לקוראים ניידים על חיבורים לא יציבים, והיא עולה כמה אחוזים מגודל הקובץ עבור האינדקס שנטען בקדמה. שני הדברים שיש לשמור ברורים הם שגם המבנה בתוך ה-PDF וגם הגשת הבתים מחוצה לו חייבים להיות נכונים, ושכל עריכה בדיעבד מבטלת את האופטימיזציה עד שתכתוב את הקובץ מחדש. התייחס ללינאריזציה מחדש כאל השלב האחרון בצינור, אחרי שכל שינוי אחר הוסדר. התנהגות ההפניות הצולבות, זרמי האובייקטים והעדכונים ההדרגתיים שמתוארת כאן היא חלק מהמודל המבני שHotPDF Delphi Component עבור Delphi ו-C++Builder מממש; לרקע רחב יותר על פריסת הקובץ ראה איך PDF בנוי, ולזרימת העבודה של עדכונים הדרגתיים וקבצים גדולים בקוד ראה עיבוד קובצי PDF גדולים מתוך Delphi