שם מוגדר שמפנה לעמודה שלמה נקרא על ידי Excel כתא בודד כשהוא מופיע בעמדה סקלרית: =Vertical+1 בשורה 7 פירושו "התא של Vertical בשורה 7", לא כל האזור. רכיב HotXLS ל-Delphi מיישם את ההצטלבות המרומזת הזו ב-v2.382.4 בשתי רמות, בזמן ההערכה ובזמן חילוץ התלויות, כי תבנית הלוואה עם 4805 נוסחאות הראתה שלקבל את הערך הנכון זה לא מספיק. כשהמהלכן על התלויות מרחיב את השם לאזור המלא שלו, נוסחה במורד הזרם שמזינה תא כלשהו באזור הזה סוגרת מעגל שלא קיים, ו-TXLSXWorkbook.Recalculate דוחה את כל החוברת
התבנית המדוברת היא חוברת תקנית של לוח סילוקין להלוואה. כשכל ערך שמור מורעל ל-777 ורצה Recalculate מלא, שתי ארכיטקטורות המנוע החזירו 23, שהוא lxErrorRef, קוד ההפניה המעגלית. 3842 מתוך 4805 הנוסחאות לא תאמו את הציפייה העצמאית, B18 החזיק #VALUE!, E18 עוד היה 777, ומונה התשלומים ב-J7 קרא את מחזיקי המקום בעמודת יתרה שלא הושלמה. שלושה פגמים נפרדים התחבאו מאחורי קוד החזרה אחד, והמאמר הזה עובר על כל אחד מהם עם הקוד שתיקן אותו
למה הפניה סקלרית לשם של עמודה יוצרת מעגל כוזב?
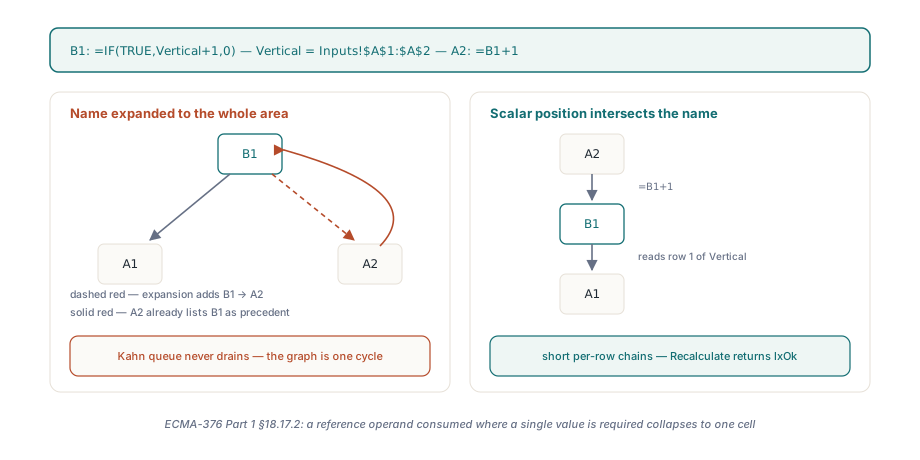
כי גרף תלויות מכיר רק קשתות, וקשת מנוסחה לאזור של 480 שורות היא 480 קשתות, שאחת מהן מצביעה חזרה דרך תא שתלוי בנוסחה. קחו את =IF(TRUE,Vertical+1,0) ב-B1 עם Vertical שמוגדר כ-Inputs!$A$1:$A$2, ואת =B1+1 ב-A2. Excel מעריך את B1 כ-A1+1 ואת A2 כ-B1+1, שרשרת ישרה. מהלכן שרשום את B1 כתלוי ב-A1:A2 הופך את A2 לתלויה של B1, A2 כבר מפרטת את B1 כתלויה, ותור קאהן שמניע את החישוב מחדש המצטבר ב-HotXLS אף פעם לא רואה את אחד משני הצמתים מגיע לדרגת כניסה אפס. זה הדפוס שתבניות הלוואה עשויות ממנו: כל שורת תקופה מפנה לשמות של עמודות היתרה, הריבית ומונה התשלומים, כל שם משתרע על כל לוח הזמנים, וכל שורה גם כותבת לאותן עמודות. הרחיבו את השמות והגרף הוא רכיב חזק קשיר אחד ענק. העריכו אותם עם הצטלבות מרומזת והגרף הוא אוסף של שרשראות קצרות, אחת לכל שורה, וזה מה ש-ECMA-376 חלק 1 §18.17.2 מתאר לאופרנד reference שנצרך במקום שנדרש בו ערך בודד
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // עמדה סקלרית: Vertical מתכווץ ל-A1 כי הנוסחה נמצאת בשורה 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // שם שההגדרה שלו היא שם אחר עדיין מצטלב, כך שזה A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // ארגומנט מסוג reference: כל האזור נסכם, בלי הצטלבות
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // שורה 6 נמצאת מחוץ ל-A1:A2, ההצטלבות ריקה ו-IFERROR תופסת את זה
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // לפני v2.382.4 הענף הזה היה בלתי נגיש: B1 -> A2 -> B1 היה מעגל
    end;
  finally
    Book.Free;
  end;
end;
איך HotXLS מחליט שארגומנט הוא סקלרי?
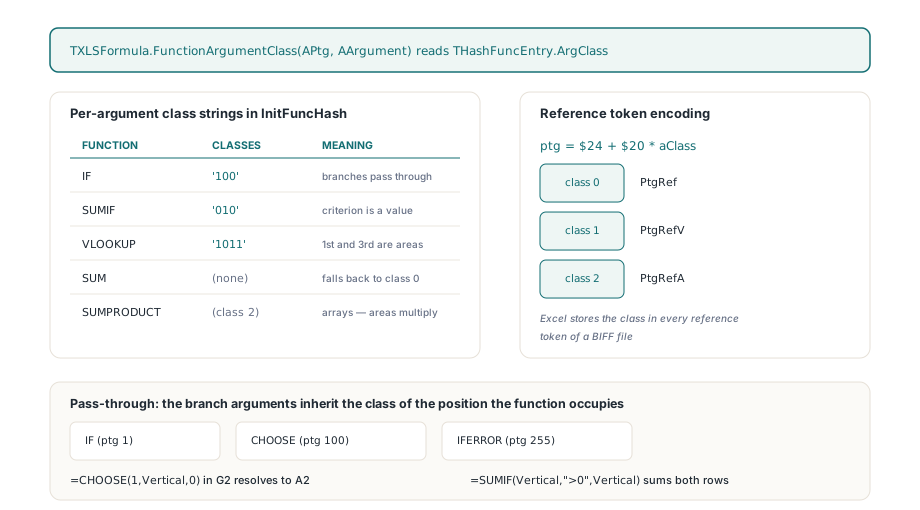
HotXLS קורא את התשובה מטבלת הפונקציות ולא מצורת הארגומנט. כל רשומה ב-TXLSFormula.InitFuncHash נרשמת דרך THashFunc.SetValue עם מחרוזת סיווג אופציונלית לכל ארגומנט: 'IF' נושאת '100', 'SUMIF' נושאת '010', 'VLOOKUP' נושאת '1011', ו-'SUM' לא נושאת כלום, כך שכל הארגומנטים שלה נופלים בחזרה לסיווג 0 ברמת הפונקציה. הפונקציה החדשה TXLSFormula.FunctionArgumentClass(APtg, AArgument) חושפת את הבית הזה דרך THashFuncEntry.ArgClass, ותוצאה של 1 פירושה סיווג value. אלה אותם שלושה סיווגים ש-[MS-XLS] §2.2.2 מקצה לאסימוני אופרנד, והמקודד כבר היה תלוי בהם: כשהוא כותב reference הוא מחשב את ה-ptg כ-$24 + $20 * aClass, שנותן PtgRef לסיווג 0, PtgRefV לסיווג 1 ו-PtgRefA לסיווג 2. קובץ BIFF שנכתב על ידי Excel מאחסן את הסיווג הזה בכל אסימון reference, כך שמנוע שהטבלה שלו תואמת למפרט יכול לענות "האם הארגומנט הזה סקלרי" בלי להסתכל על הנתונים. הארגומנט האמצעי של SUMIF הוא הקריטריון, ערך; הראשון והשלישי הם אזורים, כלומר references. SUMPRODUCT נרשמת עם סיווג 2 ברמת הפונקציה, array, ולכן =SUMPRODUCT(Vertical,Vertical) עדיין מכפילה את כל האזור
שלוש פונקציות לא מתייעצות עם הרשומה שלהן בשום דבר מעבר לארגומנט הראשון. IF (ptg 1), CHOOSE (ptg 100) ו-IFERROR (ptg 255) מעבירות הלאה כל מה שהן בוחרות, כך שארגומנטי הענפים שלהן יורשים את הסיווג של העמדה שהפונקציה עצמה תופסת. הכלל הבודד הזה הוא מה שמאפשר ל-=CHOOSE(1,Vertical,0) ב-G2 להתברר כ-A2 בעוד ש-=SUMIF(Vertical,">0",Vertical) שלידו עדיין מסכם את שתי השורות, וזה הכלל שלוח סילוקין מפעיל יותר מכולם, כי תאי התקופה שלו נשענים על IF כדי לבדוק אם ההלוואה עוד פתוחה
להעביר את הסיווג דרך מהלך התלויות
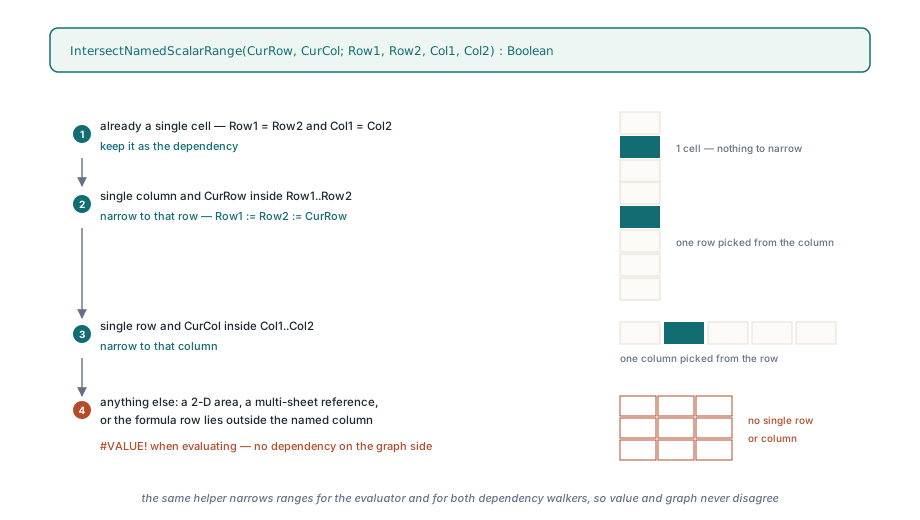
מחלץ התלויות ב-lxCalc.pas הוא Walk רקורסיבי מעל עץ התחביר המקומפל, והוא קיים פעמיים, פעם ב-TXLSCalculator.ExtractDependencies בשביל הגרף לכל חוברת ופעם ב-ExtractWorkspaceDependencies בשביל הגרף החוצה חוברות. גרסה 2.382.4 נותנת לשני המהלכנים שני פרמטרים נוספים. AScalar מתחיל כ-True בשורש של נוסחה, מחושב מחדש לכל ילד פונקציה מתוך FunctionArgumentClass, ומועבר ללא שינוי לארגומנטי הענפים של ptg 1, 100 ו-255. ANameRoot הופך ל-True רק כשהמהלכן יורד לתוך ההגדרה המקומפלת של שם, והוא שורד רק דרך צמתי SA_GROUP, הסוגריים, כך ששם שמוגדר כ-=A1:A2+1 לא ייחשב בטעות לאזור רגיל. כששני הדגלים True בצומת SA_RANGE, AddResolvedRange מצמצם את האזור עם אותו עוזר שהמעריך משתמש בו לפני שהוא רושם את התלות. העוזר קצר מספיק כדי לצטט אותו במלואו
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // כבר תא
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // עמודה בודדת: לקחת את השורה הזו
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // שורה בודדת: לקחת את העמודה הזו
    Result := True;
  end;
end;
כל מה שהעוזר דוחה, אזור דו-ממדי, reference מרובה גיליונות או נוסחה ששורתה נמצאת מחוץ לעמודה הנקובה בשם, מניב #VALUE! בצד ההערכה ושום תלות בכלל בצד הגרף, וזה מה ש-Excel עושה להצטלבות ריקה. צד ההערכה יושב ב-TXLSCalculator.GetValueItemName: הוא מסיר עטיפות SA_GROUP מההגדרה המקומפלת, ואם השורש הוא SA_RANGE הוא קורא ל-GetRangeInfo, מצטלב, ומביא את התא האחד דרך FGetValue במקום להעריך את כל ההגדרה. references חיצוניים נשארים במסלול הישן, כי אין שורה מקומית להצטלב מולה. מאיפה מגיעים בכלל האחסון והתחום של שם מכוסה במאמר על שמות מוגדרים ונוסחאות חוצות גיליונות; הנקודה כאן היא רק מה המנוע עושה אחרי שהשם מתברר
למה MATCH מעל עמודה שחושבה חלקית קראה 777?
כי ארגומנט מערך החיפוש של MATCH הוא reference סריקה, ו-references של סריקה הוצאו בכוונה מסדר ההערכה. מאמר על סריקת ה-lookup הציג את TXLSDepRange.LookupScan וסיים בפרק בשם "מה אתם מוותרים כשמוציאים קשתות סריקה מהסדר": נוסחת lookup עשויה לרוץ לפני שכל תא בטווח שלה חושב מחדש ולקרוא ערכים מיושנים. בסשן אינטראקטיבי זה מתכנס במעבר הבא. בחישוב מחדש אצווה של תבנית מורעלת זה לא, ו-PaymentCount, שמוגדר כ-=MATCH(0.01,Balances,-1)+1, קרא את מחזיקי המקום 777 שעדיין ישבו בעמודת היתרה והחזיר מספר תקופות שלא יכול להיות נכון
TXLSDepGraph.TopoOrder מתייחס כעת לקשתות סריקה כאל קשתות סדר רכות. לצד דרגת הכניסה הקשיחה הוא שומר מערך ScanInDeg, שסופר תלויות סריקה מלוכלכות לכל צומת ומקטין אותו ככל שהן נפלטות, תוך שימוש ברשימות ScanPrecedents, ScanDependents ו-ScanPrecedentCount שהשינוי הקודם כבר אחסן. בכל איטרציה תור קאהן סורק את חלון המוכנים שלו אחר הצומת הראשון שה-ScanInDeg שלו אפס ומחליף אותו לראש; אם כל צומת מוכן עדיין ממתין לתלויה סריקה, הראש נשלף בסדר היציב שלו. קשתות סריקה אף פעם לא נכנסות לדרגת הכניסה הקשיחה, כך ש-VLOOKUP שמפנה לעצמו מעל העמודה של עצמו עדיין חוקי, אבל lookup שיכול לחכות לתלויה ניתנת להשלמה אכן מחכה כעת. הרגרסיה שמקבעת את זה, LookupScan_WaitsForDirtyFormulaValues, מרעילה שלושה תאי יתרה ל-777 ומצפה ש-PaymentCount יחזור כ-3, ואז מהפכת את הקלט לאפס ומצפה ש-=IFERROR(PaymentCount,99) יראה את ה-#N/A ויחזיר 99
מאיפה הגיע הקיצוץ לארבעה עשרוניים?
מאריתמטיקת Variant של דלפי, ורק בעמדות מקוננות. האופרטורים הבינאריים ב-TXLSCalculator.GetValueItem כבר העתיקו + או - ברמה העליונה לשני משתנים מסוג Double, כך ש-=B1-A1 היה תקין. בתוך =IF(TRUE,B1-A1,0) אותו חיסור רץ כ-Value := Value - SubValue על שני Variants, וכשאחד האופרנדים היה ערך תא מסוג Int64 והשני Double, התוצאה שראינו הייתה Currency, טיפוס בנקודה קבועה עם ארבעה מקומות עשרוניים, כך ש-1066.1854641400994 פחות 120 חזר מקוצץ לארבעה עשרוניים. בלוח זמנים שבו כל תשלום מורכב מהשורה הקודמת, השגיאה הזו עוברת מאות תקופות לפני שהיא מגיעה לסכומים
// TXLSCalculator.GetValueItem, ענף אריתמטיקה בינארית (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// אריתמטיקה מעורבת של Variant מסוג Int64/Double יכולה לקדם ל-Currency.
// אריתמטיקה של גיליון חייבת לשמור על דיוק נקודה צפה.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
השמירה רצה לפני SA_ADD, SA_SUB, SA_MUL ו-SA_DIV כאחד, והרגרסיה Arithmetic_MixedInt64AndDoubleKeepsPrecision מאחסנת Int64(120) ב-A1 ואת 1066.1854641400994 ב-B1, ואז בודקת את ההפרש והסכום המקוננים בדיוק של 1E-10 ואת המכפלה והמנה בדיוק של 1E-8 ו-1E-12. HotXLS לא מתיימרת להכיר כל כלל קידום שה-RTL מחיל על טיפוסי Variant מעורבים בין גרסאות קומפיילר; היא כן מתיימרת שאריתמטיקה של גיליון היא IEEE double, והיא עושה כעת את שני האופרנדים ל-double לפני שהאופרטור רואה אותם, מה שמסיר את השאלה
מה התיקון מבטיח, ומה הוא לא
אחרי v2.382.4 שתי ארכיטקטורות המנוע מחזירות lxOk לתבנית המורעלת, כל 4805 הערכים השמורים תואמים את הציפייה העצמאית שורה-שורה בדיוק של 1E-7, והקביעות שהמטמונים באמת הורעלו, ש-hash המקור לא השתנה ושכל נוסחה עדיין קיימת כולן מתקיימות. שום איטרציה לא הופעלה ושום קוד שגיאה לא הושתק כדי להגיע לשם. מעגל אמיתי דרך שם, =B1 ב-A1 כשהשם B1 עדיין קורא ל-Vertical, עדיין מחזיר שגיאה, והבדיקה NamedScalarRanges_IntersectWithoutFalseCycles מסתיימת בקביעה בדיוק של זה
הגבולות ראויים להיאמר בפשטות. הצטלבות מרומזת חלה רק על שם שההגדרה המקומפלת שלו, אחרי הסרת סוגריים, היא אזור של עמודה בודדת או שורה בודדת בגיליון אחד; שם דו-ממדי בעמדה סקלרית הוא #VALUE!, כמו ב-Excel, ופונקציה שהטבלה לא מכירה מקבלת סיווג 0 מ-FunctionArgumentClass, כך שארגומנטי השמות שלה עדיין מורחבים במלואם. הסדר הרך הוא העדפה, לא הבטחה: מעגל שהוא סריקה בלבד עדיין מוערך בסדר יציב וקורא כל מה שבמטמון, וזו ההתנהגות שמאמר סריקת ה-lookup קיבל בכוונה. והתוצאה של כל התבנית מאומתת מול סקריפט ציפיות עצמאי, לא מול מנוע גיליון אחר, כי חבילת המשרד לבדיקה לא סיימה לחשב מחדש את התבנית המקורית בתקציב של 60 שניות. HotXLS הוא רכיב גיליון ילידי ל-Delphi ו-C++Builder שקורא, מחשב מחדש וכותב XLS, XLSX, ODS ו-CSV בלי Excel מותקן; הצטלבות השמות, טבלת סיווג הארגומנטים והסדר הרך של הסריקות חלים על כל פורמט כי מנוע החישוב משותף, וכיסוי הפונקציות הנוכחי מפורט בעמוד המוצר של רכיב הגיליון HotXLS ל-Delphi