HotPDF מריץ Tesseract בתוך התהליך של Delphi שלכם דרך HPDFCreateTesseractDLLOCREngine, מפעל שנוסף ב-v2.772.0 שטוען באופן דינמי DLL תואם Tesseract 5, מנהל את ה-C API שלו (TessBaseAPIInit2, TessBaseAPIRecognize, ה-result iterator) ומחזיר IHPDFOCREngine. THotPDF.ApplyLoadedOCRTextLayer משתמש באותו מנוע כדי להוסיף שכבת טקסט Unicode בלתי נראית וניתנת לחיפוש לעמודי PDF סרוקים
אותו מזהה כבר היה נגיש דרך מתאם ה-tesseract.exe החיצוני שכותב BMP ומפרסר TSV. הנתיב הזה עובד, אבל כל עמוד משלם עבור שיגור תהליך, קובץ bitmap זמני ופורמט טקסט בלי baselines ובלי שליטה בפילוח עמודים. קריאה ל-DLL מסירה את שלושתם. היא גם מסירה את חומת ה-process, מה שאומר ש-binding של פסקל יושב ישירות מעל מבני C, בוליאנים של C ומחרוזות שהוקצו על ידי C. רוב מה ששווה לדעת על המתאם הזה הוא המקומות שבהם ה-binding הזה יכול להשתבש בשקט
איך מריצים Tesseract בתוך התהליך מ-Delphi עם HotPDF?
הרצת Tesseract בתוך התהליך עם HotPDF דורשת קריאת מפעל אחת ביחידת ה-HPDFTesseractRecognition ואת קריאת ה-ApplyLoadedOCRTextLayer שכל מנוע OCR של HotPDF משתמש בה. המפעל מאמת בחפזון. קובץ ה-DLL וספריית ה-tessdata חייבים להתקיים, מזהה השפה רשאי להכיל רק אותיות ASCII, ספרות, _ ו-+, כל מודל בשילוב כמו chi_sim+eng חייב להחזיק קובץ .traineddata תואם, וכל 21 ה-exports הנדרשים חייבים להיפתר לפני שהמנוע מוחזר. טעויות הגדרות מעלות EArgumentException; DLL שנכשל בטעינה מעלה EOSError עם קוד השגיאה של Windows ורמז לבדוק ארכיטקטורה ותלות
uses
  SysUtils, HPDFDoc, HPDFTesseractRecognition;

procedure MakeSearchable(const SourceFile, TargetFile: string);
var
  Doc: THotPDF;
  Engine: IHPDFOCREngine;
  Options: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  // אפליקציית Win64 זקוקה ל-DLL בן 64 ביט; DLLי התלות הולכים לצידו
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'chi_sim+eng');   // THPDFTesseractOptions.Default
  Doc := THotPDF.Create(nil);
  try
    Doc.AutoLaunch := False;
    if Doc.LoadFromFile(SourceFile) < 1 then
      raise Exception.Create('Cannot load ' + SourceFile);
    Options := THPDFOCRTextLayerOptions.Default;   // 300 DPI, MinimumConfidence 0.5
    // רשימת עמודים ריקה פירושה כל עמוד; עמודים שכבר יש להם טקסט מדולגים
    if not Doc.ApplyLoadedOCRTextLayer([], Engine, Options, Info) then
      raise Exception.Create(string(Info.Diagnostic));
    Writeln(string(Info.EngineName), ': ', Info.AcceptedWordCount,
      ' words accepted, ', Info.DroppedWordCount, ' dropped');
    Doc.SaveLoadedDocument(TargetFile);
  finally
    Doc.Free;
  end;
end;
THPDFTesseractOptions.Default מגדיר את PageSegMode ל-tpsAuto, את EngineMode ל-temDefault, את TimeoutMilliseconds ל-60,000 ואת MaxPixels ל-16,777,216. תקציב הפיקסלים חשוב יותר משנדמה. עמוד US Letter ב-300 DPI המוגדר מרונדר ל-2,550 × 3,300 פיקסלים, כ-8.4 מיליון, מה שנכנס. אותו עמוד ב-600 DPI הוא 5,100 × 6,600, כ-33.7 מיליון, והמתאם דוחה אותו לפני ש-Tesseract רואה פיקסל. מרימים את MaxPixels (התקרה היא 67,108,864) או משאירים את ה-DPI במקומו; כל צלע גם חסומה ב-32,767 פיקסלים
ה-DLL נטען עם LoadLibraryEx בשימוש בדגלי החיפוש עבור תיקיית ה-DLL עצמה בתוספת הספריות הבטוחות כברירת מחדל, כך שספריות התמונה ש-Tesseract תלוי בהן יכולות לשכון לצידו בלי לגעת ב-PATH או בספרייה הנוכחית. HotPDF לא מצרף ולא מוריד שום ראנטיים או מודל OCR; את שניהם מספקים בעצמכם
מה משתנה בהשוואה למתאם ה-tesseract.exe?
מתאם ה-DLL סוחר בידוד process תמורת פלט עשיר יותר ותקורה נמוכה יותר לעמוד. שני המתאמים מתחברים לאותו צינור שכבת-טקסט, ולכן מיפוי הקואורדינטות, סינון הביטחון והקביעה של הכול-או-כלום זהים; מה ששונה הוא איך פיקסלים נכנסים ומילים יוצאות
| היבט | מתאם tesseract.exe | מתאם ה-Tesseract DLL |
|---|---|---|
| מפעל | HPDFCreateTesseractOCREngine | HPDFCreateTesseractDLLOCREngine |
| פיקסלים נכנסים | קובץ BMP בספרייה זמנית פרטית | חוצץ grayscale בן 8 ביט בזיכרון |
| מילים יוצאות | TSV ברמת מילה, חסום ב-64 MiB | Result iterator, UTF-8 לכל מילה |
| Baselines | לא זמינות | מועברות מ-TessPageIteratorBaseline |
| פילוח עמודים ומצב מנוע | פילוח אוטומטי בלבד | THPDFTesseractPageSegMode, THPDFTesseractEngineMode |
| פסק זמן | קשה: תהליך הבן מחוסל | שיתופי: Tesseract חייב להבחין |
| בידוד קריסות וזיכרון | תהליך נפרד | אין, חולק את מרחב הכתובות שלכם |
עלות אחת לא נעלמת. כל קריאת Recognize יוצרת מופע API משלה וקוראת ל-TessBaseAPIInit2, ולכן מודלי השפה מאותחלים לכל עמוד ולא פעם אחת למנוע. מטמון הקבצים של מערכת ההפעלה מרכך את הטעינה מחדש, אבל על קבוצות מודלים גדולות ורבות-שפה זו עדיין העלות הקבועה הדומיננטית לעמוד, והיא נחשבת מול דדליין הזיהוי. מנוע ה-DLL של RapidOCR בתוך התהליך בוחר עיצוב הפוך ומשאיר את מודלי ה-ONNX שלו תושבי זיכרון לכל חיי המנוע; בעיות הגבול (C ABI, חוצצים בהשאלה, עבודה מקורית שלא ניתנת להפרעה) הן אותה משפחה
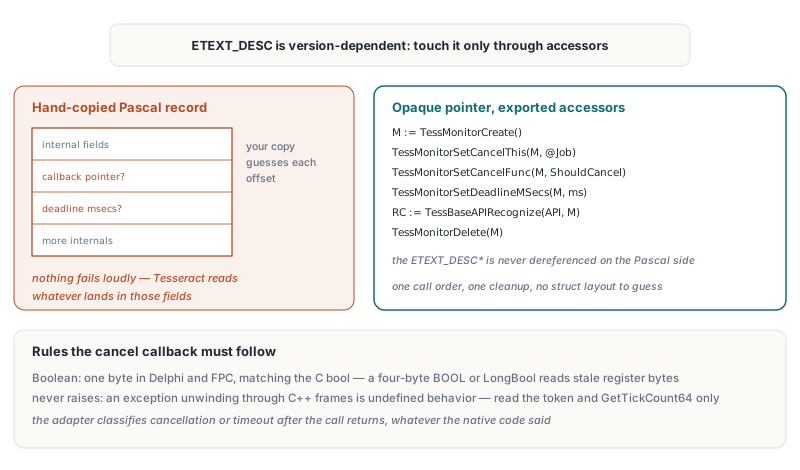
למה Delphi לא יכולה להעתיק את struct ה-monitor של Tesseract?
Delphi לא יכולה לשקף בבטחה את מוניטור ההתקדמות של Tesseract כי ETEXT_DESC מכיל שדות פנימיים תלויי-גרסה, ולכן רשומה שהועתקה ביד מציבה את callback הביטול ואת הדדליין בהיסטים הלא נכונים בחלק מה-builds. שום דבר לא נכשל בקול כשזה קורה. Tesseract פשוט קורא את מצביע ה-callback שלכם משדה שעכשיו מחזיק משהו אחר, או לעולם לא רואה את הדדליין כלל
לכן HotPDF מתייחס למוניטור בתור מצביע אטום ונוגע בו רק דרך פונקציות מיוצאות: TessMonitorCreate, TessMonitorSetCancelThis, TessMonitorSetCancelFunc, TessMonitorSetDeadlineMSecs ו-TessMonitorDelete. אם קושרים את ה-C API בעצמכם למטרה אחרת, אותה תבנית חלה. השרטוט להלן הוא קוד ה-binding שלכם, לא API של HotPDF, ומשקף את ההצהרות ש-HotPDF משתמש בהן פנימית
type
  // C: typedef bool (*TessCancelFunc)(void *cancel_this, int words);
  TTessCancelFunc = function(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
  TTessMonitorCreate = function: Pointer; cdecl;   // ETEXT_DESC*, לעולם לא נפרק מההפניה
  TTessMonitorDelete = procedure(Monitor: Pointer); cdecl;
  TTessMonitorSetCancelFunc = procedure(Monitor: Pointer; Func: TTessCancelFunc); cdecl;
  TTessMonitorSetCancelThis = procedure(Monitor, CancelThis: Pointer); cdecl;
  TTessMonitorSetDeadlineMSecs = procedure(Monitor: Pointer; MSecs: Integer); cdecl;
  TTessBaseAPIRecognize = function(Handle, Monitor: Pointer): Integer; cdecl;

  TOCRJob = record
    CancelRequested: Boolean;
    DeadlineTick: UInt64;
  end;
  POCRJob = ^TOCRJob;

function ShouldCancel(CancelThis: Pointer; Words: Integer): Boolean; cdecl;
begin
  // רץ על המחסנית של Tesseract: קורא דגלים ושעון, לעולם לא מעלה חריגה
  Result := (CancelThis = nil) or POCRJob(CancelThis)^.CancelRequested or
    (GetTickCount64 >= POCRJob(CancelThis)^.DeadlineTick);
end;

// שימוש, עם מצביעי הפונקציות שנפתרו על ידי GetProcAddress:
//   Monitor := MonitorCreate();
//   try
//     MonitorSetCancelThis(Monitor, @Job);
//     MonitorSetCancelFunc(Monitor, ShouldCancel);
//     MonitorSetDeadlineMSecs(Monitor, RemainingMs);
//     RC := BaseAPIRecognize(API, Monitor);
//   finally
//     MonitorDelete(Monitor);
//   end;
שני פרטים בשרטוט הזה מכוונים. ה-callback מחזיר Boolean, שהוא ביט אחד גם ב-Delphi וגם ב-Free Pascal, בהתאמה ל-bool של C ב-TessCancelFunc. ה-BOOL של Windows בן ארבעת הבייטים או ה-LongBool של Delphi נראים חליפיים ואינם: כשצד אחד כותב ביט בודד והשני קורא ארבעה, הבייטים העליונים של רגיסטר ההחזרה הם מה שנשאר שם, ו-false יכול להגיע בתור true. אותה כותרת מסבכת עוד יותר, כי פונקציות כמו TessPageIteratorBoundingBox מחזירות int, ש-HotPDF מצהיר עליו בתור Integer. קוראים את סוג ה-C של כל ערך מוחזר במקום להניח קונבנציה אחת לכל ה-API
הפרט השני הוא שה-callback לעולם לא מעלה חריגה. חריגת Delphi שמתפרקת דרך frames ה-C++ של Tesseract היא התנהגות לא מוגדרת, ולכן ה-callback של HotPDF קורא רק את token הביטול וערך GetTickCount64 מונוטוני. המתאם הופך את התוצאה לדיאגנוסטיקת ביטול או פסק-זמן אחרי ש-TessBaseAPIRecognize מחזירה, והוא מבצע את הבדיקה הזאת בלי קשר לקוד ההחזרה המקורי
אילו מצביעים מקוריים בבעלות הצד של Delphi?
מתאם ה-Tesseract DLL של HotPDF בבעלותו שלושה אובייקטים מקוריים לבקשה, מופע ה-API, המוניטור וה-result iterator, ושואל בהשאלה את כל השאר. כל קריאת Recognize יוצרת קבוצה משלה ומשחררת אותה בבלוק finally: TessResultIteratorDelete, אחר כך TessMonitorDelete, ואז TessBaseAPIDelete. שחרור ממשק המנוע פורק את הספרייה
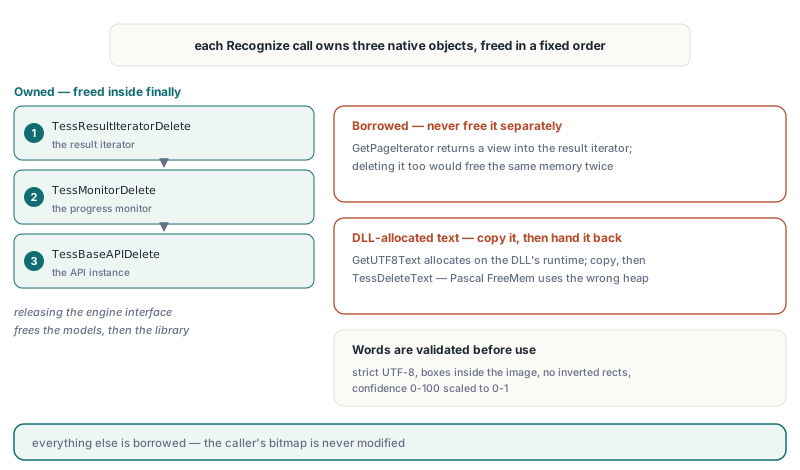
TessResultIteratorGetPageIteratorמחזיר תצוגה בהשאלה אל תוך ה-result iterator, לא אובייקט חדש. HotPDF משתמש בו עבורTessPageIteratorBoundingBoxו-TessPageIteratorBaselineולעולם לא משחרר אותו; מחיקתו בנפרד הייתה משחררת את אותו זיכרון פעמייםTessResultIteratorGetUTF8Textמחזיר מחרוזת שהוקצתה על ידי הראנטיים של ה-DLL עצמו. HotPDF מעתיק אותה ומשיב אותה דרךTessDeleteTextבבלוקfinally;FreeMemשל פסקל היה משחרר אותה על ה-heap הלא נכון- טקסט מילים מפוענח עם אימות UTF-8 מחמיר ונבדק באורך לפני ההמרה. מילים עם תווי בקרה, UTF-8 פגום, תיבות מחוץ לתמונה, מלבנים הפוכים או ביטחון מחוץ ל-0–100 מכשילות את הבקשה במקום לתוקן אותן בשקט
- הטקסט הכולל לבקשה חסום ב-1,048,576 יחידות קוד של UTF-16, ומניין המילים חייב להיכנס לתקציב הבקשה שמועבר על ידי
ApplyLoadedOCRTextLayer
הביטחון מגיע בתור 0–100 ומותאם ל-0–1, כך ש-THPDFOCRTextLayerOptions.MinimumConfidence אומר את אותו דבר עבור כל מנוע. כש-Tesseract מדווח baseline, שני הקצוות מועברים; אחרת צינור שכבת הטקסט נופל בחזרה אל ההערכה הגאומטרית שלו, בדיוק כפי שהוא עושה עבור קלט TSV
למה לאמת enum לפני שהוא מגיע אל ה-DLL?
HotPDF מעתיק את ה-ordinal הגולמי של PageSegMode ו-EngineMode אל Integer לפני בדיקת הטווח, כי מהדר רשאי להניח שמשתנה enum תמיד מחזיק ערך מוצהר ולקפל Ord(X) > Ord(High(T)) אל false קבוע. ה-ordinals אינם קישוט: THPDFTesseractPageSegMode הולך אחרי מספור פילוח העמודים של Tesseract מ-0 עד 13, THPDFTesseractEngineMode הולך אחרי מספור מצבי המנוע מ-0 עד 3, ושניהם נעים אל ה-DLL בתור שלמים פשוטים. רשומת אפשרויות שנבנתה עם FillChar, מולאה מתוך stream, או הועברה מ-C++Builder עם מספר שלם בהמרה יכולה לשאת בייט כמו 200. אימות ה-ordinal המועתק הופך את זה ל-EArgumentException בזמן המפעל במקום למצב לא מוגדר בתוך קוד מקורי. המפעל גם דוחה tpsOSDOnly ו-tpsAutoOnly, שאינם מניבים מילים, ודורש osd.traineddata עבור tpsAutoOSD ו-tpsSparseTextOSD
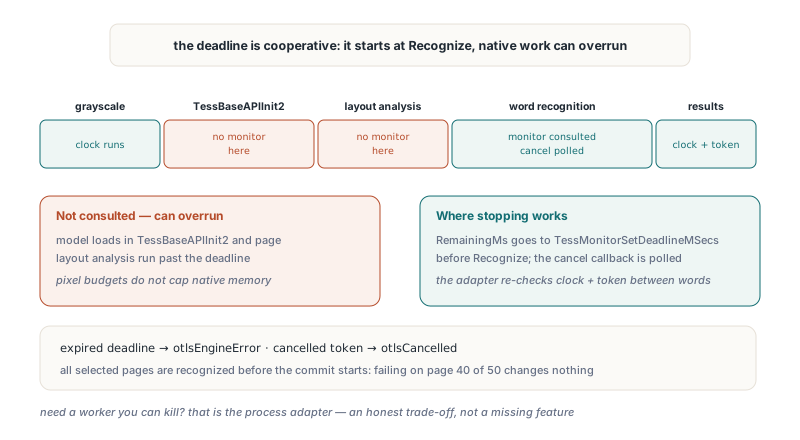
מה פסק הזמן של הזיהוי באמת מערב?
פסק הזמן של ה-Tesseract DLL הוא שיתופי: HotPDF יכול לעצור את עבודתו שלו ולבקש מ-Tesseract לעצור, אבל אינו יכול לכפות על קוד מקורי לחזור. השעון מתחיל כש-Recognize מתחיל, ולכן המרת ה-bitmap ואתחול המודלים צורכים את אותו תקציב כמו הזיהוי. HotPDF בודק זמן שחלף ואת token הביטול במהלך המרת ה-grayscale ובין מילים בזמן מעבר על התוצאות, ומעביר את מילישניות הנותרות אל TessMonitorSetDeadlineMSecs לפני קריאת TessBaseAPIRecognize
הפער נמצא בתוך הקריאה המקורית. המוניטור של Tesseract נשאל במהלך זיהוי מילים, לא במהלך TessBaseAPIInit2 או ניתוח פריסת העמוד, ולכן טעינת מודל איטית או פריסה פתולוגית יכולות לרוץ מעבר לדדליין לפני שפסק הזמן מדווח. תקציבי הפיקסלים והפלט גם לא חוסמים את השימוש בזיכרון של הספרייה המקורית עצמה. אם צריך worker שאפשר להרוג, משתמשים במתאם ה-process; זהו הפשרה כנה, לא יכולת חסרה
פילוח עמודים הוא המקום שבו מתאם ה-DLL מרוויח את לחמו על קלט קשה. טפסים, תוויות וטבלאות סרוקות עם שדות מפוזרים לעיתים קרובות מזוהים טוב יותר עם tpsSparseText מאשר עם פילוח אוטומטי, שמנסה להרכיב עמודות ופסקאות שאינם שם
procedure OCRFormPages(Doc: THotPDF; const Pages: array of Integer);
var
  Engine: IHPDFOCREngine;
  TessOptions: THPDFTesseractOptions;
  LayerOptions: THPDFOCRTextLayerOptions;
  Info: THPDFOCRTextLayerInfo;
begin
  TessOptions := THPDFTesseractOptions.Default;
  TessOptions.PageSegMode := tpsSparseText;  // שדות מפוזרים, בלי הרכבת עמודות
  TessOptions.EngineMode := temLSTMOnly;     // דורש מודלי LSTM ב-tessdata
  TessOptions.TimeoutMilliseconds := 20000;  // כולל אתחול מודלים
  Engine := HPDFCreateTesseractDLLOCREngine('C:\OCR\Win64\libtesseract-5.dll',
    'C:\OCR\tessdata', 'eng+deu', TessOptions);

  LayerOptions := THPDFOCRTextLayerOptions.Default;
  LayerOptions.MinimumConfidence := 0.6;
  if not Doc.ApplyLoadedOCRTextLayer(Pages, Engine, LayerOptions, Info) then
    case Info.Status of
      otlsCancelled:
        Writeln('OCR cancelled, document unchanged');
      otlsEngineError:
        Writeln('Tesseract failed or timed out: ', string(Info.Diagnostic));
    else
      Writeln(string(Info.Diagnostic));
    end;
end;
פסק זמן מתגלה בתור otlsEngineError עם הדיאגנוסטיקה Tesseract DLL OCR timed out, בזמן ש-token שבוטל מתגלה בתור otlsCancelled. בשני המקרים ApplyLoadedOCRTextLayer זיהה את כל העמודים הנבחרים לפני שהוא פותח את טרנזקציית הקביעה, כך שכישלון בעמוד 40 מתוך 50 משאיר את המסמך הטעון בדיוק כפי שהיה. שימו לב ש-tpsSingleLine, tpsSingleBlock ו-tpsSparseText משנים פילוח בלבד; אף אחד מהם לא מיישר סריקה מוטה
Free Pascal ו-Lazarus: פיקסלים מיושנים וסינית שנעלמה
שני מפעלי ה-Tesseract עובדים ב-builds של Windows Free Pascal ו-Lazarus Win32 ו-Win64 מאז v2.772.1, אחרי שני תיקונים ייחודיים ל-FPC. בונים מחדש את חבילת ה-Lazarus עבור ארכיטקטורת היעד קודם; ה-port הכללי מכוסה ב-HotPDF על Free Pascal ו-Lazarus Win64
התיקון הראשון נוגע לפיקסלים. TBitmap של LCL שנכתב דרך scanlines יכול לעדכן את התמונה הגולמית שלו בלי לרענן את ה-handle של ה-bitmap של Windows, ולכן GetDIBits על אותו handle מחזיר את הפיקסלים הישנים. הסימפטום היה מתסכל בעיקום: טקסט שצויר ישירות על bitmap זוהה, בזמן שעמוד שרונדר על ידי מרנדר ה-PDF של HotPDF הניב רשימת מילים ריקה. ב-FPC המתאם קורא עכשיו snapshot מודע-פורמט דרך CreateIntfImage, שמכבד את פורמט הפיקסלים וסדר השורות של התמונה הגולמית. ה-build של Delphi משאיר את נתיב ה-GetDIBits על עותק פרטי בן 24 ביט. אף build לא משנה את ה-bitmap של הקורא
התיקון השני שייך למתאם ה-tesseract.exe. ה-TStringList של FPC מאחסן מחרוזות ANSI, ולכן השמה של טקסט TSV שפוענח מ-UTF-8 אל Lines.Text השמיטה בשקט כל תו סיני או ממישור משלים ש-code page ה-ANSI המערכתי לא יכול היה לייצג. נתיב ה-FPC משאיר עכשיו את ה-TSV בתור בייטי UTF-8, מסיר את ה-BOM ברמת בייטים ומפענח כל מילה אל UnicodeString בנפרד. למתאם ה-DLL לעולם לא הייתה הבעיה הזאת כי הוא מפענח כל מילה ישירות מהאיטרטור
עזר זריז
- מפעל:
HPDFCreateTesseractDLLOCREngine(LibraryPath, TessDataDirectory, Language[, Options])ב-HPDFTesseractRecognition, נוסף ב-v2.772.0, תמיכת FPC ב-v2.772.1 - ברירות מחדל:
tpsAuto,temDefault, 60,000 ms, 16,777,216 פיקסלים; טווח פסק-זמן 1–3,600,000 ms, תקרת פיקסלים 67,108,864 - מתאימים את bitness של ה-DLL לאפליקציה ומציבים DLLי תלות לצד ה-DLL של Tesseract
- מתייחסים למוניטור בתור אטום; לעולם לא מעתיקים
ETEXT_DESCאל רשומת פסקל - מצהירים על callback הביטול בתור
cdeclעם תוצאתBooleanבת ביט אחד, ולעולם לא מרשים לחריגה לברוח ממנו - משחררים טקסט איטרטור עם
TessDeleteText; לעולם לא משחררים את ה-page iterator שהתקבל מה-result iterator - מצפים שהדדליין יהיה שיתופי: אתחול מודלים וניתוח פריסה יכולים לחרוג ממנו
- משתמשים במתאם ה-tesseract.exe כשצריך חיסול קשה או בידוד קריסות
מתאם ה-Tesseract DLL, מתאמי ה-process ומנוע ה-OCR המובנה מגיעים כולם עם רכיב HotPDF Delphi PDF עבור Delphi, C++Builder ו-Free Pascal; ראו את עמוד המוצר של HotPDF למהדורות והורדות