כש-PDF לא מטמיע פונט, רכיב HotPDF מרנדר את הטקסט הזה עם פונט Windows מותקן שנבחר על ידי ה-HPDFMapBaseFontToSystem: הוא מפענח את שם ה-/BaseFont, משייף את חלק הסגנון, מנסה כמה איותים עד ש-GDI מאשר שהמשפחה מותקנת, מודד רוחבי standard 14 חסרים מפונטים תואמי-מטריקה, וממיר קודים חד-בייתיים ל-Unicode לפני ציור. כל אחד מהצעדים האלה קיים כי הגרסה התמימה נכשלה על קבצים אמיתיים. רנדרר העמודים RenderLoadedPageToBitmap מתמודד היטב עם תוכניות מוטמעות; זה הסיפור של הפונטים שלא נמצאים בקובץ בכלל
למה GDI מצייר בשקט את ה-typeface הלא נכון עבור פונט לא מוטמע?
GDI לעולם לא מדווח על פונט חסר: תמסרו ל-CreateFontIndirect שם פנים שהוא לא מכיר והוא יבחר בשקט תחליף, לעיתים קרובות serif אחר בלי משקל bold. הרנדרר המוקדם העביר את שם ה-PDF כמעט מילולית, ולכן ה-TimesNewRoman,Bold, ה-TimesNewRomanPS-BoldMT וה-SegoeUI-Semibold כולם לא התאימו לכלום ויצאו במה ש-GDI בחר. שמות יכולים להיות גרועים מזה. ISO 32000-1 §7.3.5 מרשה לשם לכתוב כל בייט כ-#xx, ומפיקי CJK אייתו בשגרה שמות פונטים כ-UTF-8 בריחה או כבייטי code page ישן; לפני v2.766.69 הבריחות עצמן הפכו לשם הפנים. ה-HPDFMapBaseFontToSystem מפענח עכשיו את הבריחות קודם, מחזיר רצף בייטים תקף של UTF-8 כתוויו, וקורא כל בייט גבוה אחר ב-code page של המערכת
חיתוך הסגנון הוא המקום שבו היוריסטיקות נושכות. פסיק תמיד מסיים את המשפחה (ה-Arial,Bold נותן Arial), אבל מינוס עושה זאת רק כשהמילה אחריו היא סגנון: Bold, Italic, Oblique, Regular, Roman, Medium, Light, Black, Heavy, Semi, Demi, Thin, Extra, Ultra או Condensed. הכלל הזה שומר על ה-MS-Mincho שלם בזמן שהוא הופך את ה-Calibri-Light ל-Calibri. HotPDF אז מנסה איותים של המשפחה, ואחריהם איותים של המשפחה עם סיומת PSMT, MT או PS מושמטת. מאז v2.768.18 האיותים האלה מכסים כל בחירת רווחים במקומות שבהם מילה יכולה להתחיל: לפני אות גדולה שאחריה אות קטנה (ה-MyriadPro הופך ל-Myriad Pro), באות הגדולה האחרונה של ריצה שאחריה אות קטנה (ה-UIGothic), ואחרי MS פותח (ה-MSPGothic), מהצורה המרווחת במלואה ועד השם כפי שנכתב; מעבר לארבעה מקומות כאלה מנוסים רק הצורה המרווחת במלואה והשם המחובר. לא ניתן ליישם ריווח בעיוורון, כי Windows שומר על כמה מילים מחוברות: ה-SimSun מותקן תחת אותו איות בדיוק, בזמן שה-MicrosoftYaHei, ה-MicrosoftJhengHei וה-MSPGothic שייכים ל-Microsoft YaHei, ל-Microsoft JhengHei ול-MS PGothic. לפני v2.768.18 ה-mapper שם רווח לפני כל אות גדולה פנימית, כך שה-MicrosoftYaHei נחפש כ-Microsoft Ya Hei ולעולם לא נמצא. מועמד נחשב מותקן כש-CreateFontIndirect ואז GetTextFace מחזירים את השם שהתבקש, או, מאז v2.768.18, כשטבלת ה-name של הפונט שנבחר מפרטת אותו כמשפחה, שם משפחה מלא או טיפוגרפי בכל שפה; התשובה נשמרת ב-cache לפי שם, כך שמסמכים עם הרבה פונטים שאינם מותקנים לא מגרדים יותר את Windows עבור כל שם בכל עמוד
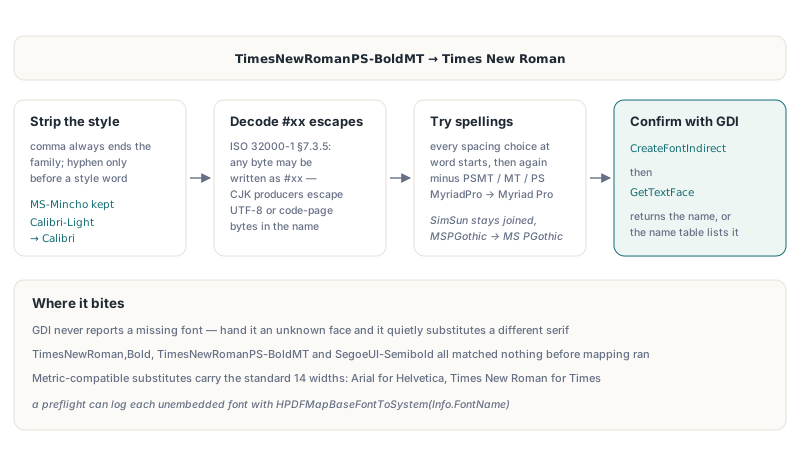
מכיוון שפונקציית המיפוי ציבורית ביחידה HPDFRenderFontMetrics, דוח preflight יכול להציג באיזו משפחה מותקנת כל פונט לא מוטמע ירנדר, באמצעות מניית הפונטים שה-THotPDF כבר חושף עבור מסמכים טעונים:
uses
  HPDFDoc, HPDFRenderFontMetrics;

procedure ListSystemFontMappings(Pdf: THotPDF; Log: TStrings);
var
  Page, I: Integer;
  Info: THPDFLoadedFontInfo;
begin
  for Page := 0 to Pdf.LoadedPageCount - 1 do
    for I := 0 to Pdf.GetLoadedFontCount(Page) - 1 do
      if Pdf.GetLoadedFontInfo(Page, I, Info) and not Info.IsEmbedded then
        Log.Add(Format('page %d  /%s  %s -> %s',
          [Page + 1, string(Info.ResourceName), string(Info.FontName),
           HPDFMapBaseFontToSystem(Info.FontName)]));
end;
איך HotPDF מודד פונטי standard 14 בלי /Widths?
HotPDF מודד את ההתקדמויות החסרות על הפונט המותקן עם אותן מטריקות, כי ISO 32000-1 §9.6.2.2 מרשה לפונטי ה-standard 14 להשמיט את ה-/Widths ולספרייה אין טבלאות AFM. Arial נושא מטריקות Helvetica, Times New Roman נושא את Times ו-Courier New נושא את Courier, ולכן ה-HPDFMeasureBaseFontWidths בונה את הפנים התואמות ב-lfHeight = -1000 וקורא ל-GetCharWidth32W; בגובה הזה התוצאה כבר ביחידות 1/1000 של em שבהן משתמשים רוחבי ה-PDF. הרנדרר הופך קודם כל קוד ל-Unicode דרך ה-/Encoding, ה-/BaseEncoding וה-/Differences, בברירת מחדל StandardEncoding. ייצוא SVG וחילוץ טקסט פגעו במלכודת נוספת: פונט Type 1 תקני בלי /Encoding בכלל הניב מפענח בלי מידע קידוד, ייצוא ה-SVG לעולם לא רשם אותו, וכל רוחב שנמדד הלך לפח. אספקת ה-StandardEncoding המשתמעת תיקנה זאת, בתנאי שהיא מסומנת כקידוד מוגדר מראש; ניתובה בנתיב שם-CMap מפענח כל קוד כ-0 וכל רוחב הולך אחריו
Bold, italic וטעות off-by-one בדגלי descriptor הפונט
רשומת ה-/Flags של descriptor פונט ממספרת את הביטים שלה מ-1, לא מ-0, כך ש-ForceBold הוא ביט 19 ($40000) ו-Italic הוא ביט 7 ($40), לפי טבלה 123 של ISO 32000-1. הקוד הישן בדק את $20000, שהוא ביט 18, SmallCap. הטעות שרדה מ-v2.345.0 עד v2.766.53 כי ה-/FontDescriptor כמעט תמיד הפניה עקיפה ובונה הפונטים קרא רק אובייקטים ישירים, ולכן הענף כולו של הדגלים מעולם לא רץ, ואותה עיוורון התעלמה מ-/Widths 12 0 R וסידרה טקסט בהתקדמות גיבוי של 500 יחידות. ברגע ש-v2.766.53 החל לפתור הפניות עקיפות דרך הרנדרר, היה חובה לתקן את הביט באותו שינוי, אחרת כל פנים small-caps פתאום הייתה מרונדר בולט:
const
  // טבלה 123 של ISO 32000-1 מונה מיקומי ביטים מ-1
  FD_ITALIC     = $00040;  // ביט 7
  FD_SMALLCAP   = $20000;  // ביט 18, לא משקל
  FD_FORCEBOLD  = $40000;  // ביט 19

procedure ApplyDescriptorFlags(Flags: Integer; var LF: TLogFont);
begin
  if (Flags and FD_FORCEBOLD) <> 0 then
    LF.lfWeight := FW_BOLD;
  if (Flags and FD_ITALIC) <> 0 then
    LF.lfItalic := 1;
end;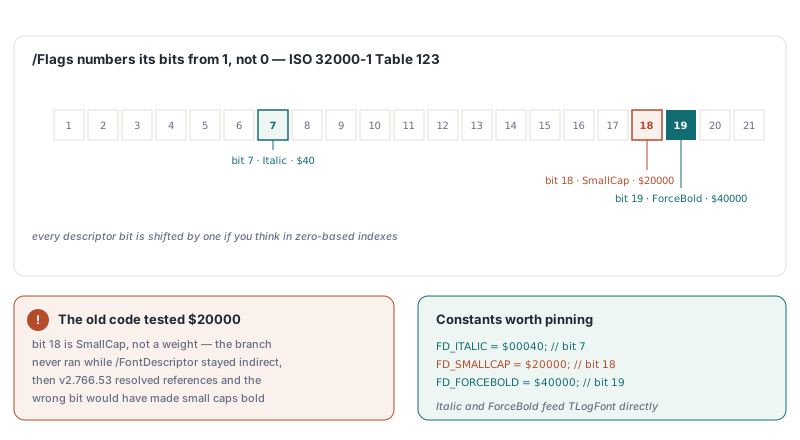
למה פונטי CJK עם CMap של UCS2 מקבלים רוחבים שגויים?
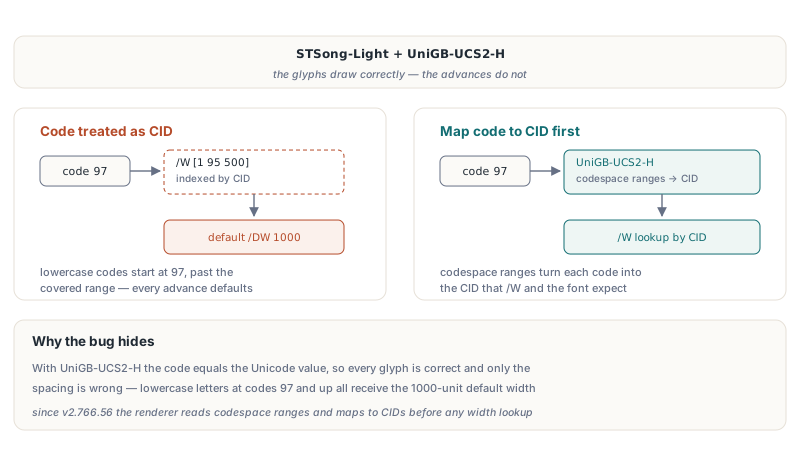
טקסט CJK עם CMap UCS2 מוגדר מראש מצייר את ה-glyph-ים הנכונים אבל את הריווח הלא נכון כשרנדרר מתייחס אל הקוד כאל ה-CID, כי ה-/W ממופה לפי CID, לא לפי קוד תו. עם STSong-Light ו-UniGB-UCS2-H הקוד במקרה שווה לערך ה-Unicode, ולכן GDI מצייר את התווים הנכונים והבאג מסתתר בהתקדמויות: אותיות קטנות מגיעות כקודים 97 ומעלה, נופלות מחוץ לרשומת /W כמו [1 95 500], וכולן מקבלות את רוחב ברירת המחדל /DW של 1000. מאז v2.766.56 הרנדרר של HotPDF קורא קודים דרך טווחי ה-codespace של ה-CMap (ISO 32000-1 §9.7.6.2) וממפה אותם אל CIDs לפני חיפוש רוחבים. רק הטבלאות המובנות UCS2 ו-UTF16 וזרמי CMap מוטמעים בשימוש; קירוב identity עבור משהו כמו GBK-EUC-H היה נראה נתמך בלבד תוך הפקת פלט שגוי, ולכן הרנדרר לא מעמיד פנים
למה תווים עם הטעמות הופכים לסימני שאלה על Windows סיני?
קודים חד-בייתיים לעולם לא צריכים להגיע אל פונקציות ה-GDI ה-ANSI ("A"), כי ה-GetGlyphOutlineA וה-GetGlyphIndicesA מפרשים בייטים ב-code page של המערכת בזמן שה-TextOutA משתמש במערכת התווים של הפונט הנבחר. על מערכת סינית, בייט $A9 של Arial (סימן זכויות היוצרים ב-Windows-1252) הפך לבייט הובלה של GBK ורונדר כ-"?", מלכודת שנתיב הקווים-ללא-hinting שנוסף ב-v2.766.83 צלל אליה ישר. v2.767.3 שואל את הפונט הממומש מהי מערכת התווים שלו עם GetTextCharset, ממיר זאת ל-code page דרך TranslateCharsetInfo, מעביר את הבייט דרך MultiByteToWideChar וקורא לפונקציות ה-W; פונטי symbol משתמשים במקום זאת ב-U+F000 ועוד הקוד. קידודים שחולקים על Windows-1252 — ה-/Differences, StandardEncoding, MacRomanEncoding — ממופים ל-Unicode לפני שכל פונט מערכת פוגש בהם
מה הגבולות של ציור עם פונטי מערכת?
רנדור פונטי-מערכת הוא קירוב, ורכיב HotPDF ישר לגבי המקום שבו הוא עוצר. לפני v2.768.18 בדיקת ההתקנה השוותה רק את השם שה-GetTextFace מחזיר, ועל Windows מקומח פונקציה זו מדווחת את שם המשפחה בשפת המערכת, ולכן Microsoft YaHei על Windows סיני או Yu Mincho על Windows יפני נשפטו חסרים וצוירו בתחליף GDI; מאז v2.768.18 פנים שחוזרת תחת שם אחר נחפשת גם בטבלת ה-name של הפונט, ופונטים כאלה נמצאים. תאימות מטריקות מובטחת רק עבור משפחות Helvetica, Times ו-Courier; Symbol ממופה אל Symbol ו-ZapfDingbats אל Wingdings, פתרון חירום ולא התאמה. ה-preflight למעלה גם רואה רק פונטים במילון ה-/Resources של כל עמוד, לא אלה שמופנים מבפנים ל-form XObjects. כשקוד עדיין לא יכול להיצייר, מעקב ה-glyph-ים שלא נפתרו בזמן ציור מדווח עליו, אות טוב יותר מבחינת אצבע בתמונות ממוזערות
התיקון העמיד יושב בצד הכתיבה. HotPDF עצמו כותב עם FontEmbedding מוגדר True כברירת מחדל, ומחליף Arial מוטמע גם כשהקוד קורא ל-SetFont עם Helvetica, וטקסט מוטמע עובר דרך רנדרר ה-glyph-ים של פונטים מוטמעים במקום כל הניחושים שלמעלה. שומר זול עבור קבצים נכנסים הוא להזהיר לפני רנדור כשמשפחה ממופה אינה ברשימת הפונטים של המסך:
// VCL: ה-Screen.Fonts מפרט שמות משפחות מותקנות (יחידת Forms)
function MissingSystemFamily(const BaseFont: AnsiString): Boolean;
begin
  Result := Screen.Fonts.IndexOf(HPDFMapBaseFontToSystem(BaseFont)) < 0;
end;
עבור הרכיב המלא, כולל רנדור עמודים, חילוץ טקסט ו-subsetting של פונטים בצד הכתיבה, ראו את עמוד המוצר של רכיב HotPDF ל-Delphi PDF