ספריית PDF של losLab יכולה להטמיע את תוכניות הגופנים החסרות של קובץ PDF שכבר נטען באמצעות קריאה אחת: EmbedMissingFonts עובר על כל מילון גופנים במסמך, מאתר את הגופן המותקן במערכת התואם לפי שם ה-BaseFont שלו, וכותב את תוכנית הגופן בחזרה לקובץ. עבור צוותים המתקנים מסמכים של צד שלישי שנכשלים באימות PDF/A עקב הטמעת גופנים, זהו התיקון שגורם לשגיאת preflight 00030 להיעלם
התרחיש הזה נפוץ באופן מדכא. צינור קליטה לארכיון מקבל קובצי PDF מספקים, לקוחות או משרד סריקה; המסמכים מרונדרים היטב בכל שולחן עבודה בבניין; ואז מאמת ה-PDF/A דוחה את כל האצווה עם אותה תלונה שחוזרת על עצמה פעם אחת לכל קובץ: לפחות גופן אחד אינו מוטמע. אף אחד במעלה הזרם לא ייצר מחדש את הקבצים, ולכן הצינור חייב לתקן אותם. מאמר זה עוסק בנתיב תיקון זה. זהו המלווה למאמר ה-preflight, המכסה זיהוי של הפרות PDF/A ו-PDF/UA: חלק זה מספר לך אילו מסמכים שבורים, וזה מתקן את הדרך הנפוצה ביותר שבה הם שבורים
מדוע PDF/A דורש להטמיע כל גופן?
תקן ISO 19005-1 §6.3.4 דורש שכל גופן המשמש מסמך תואם יישא את תוכנית הגופן שלו בתוך הקובץ, מכיוון שכל ההבטחה של PDF/A היא שחזוריות: המסמך חייב להתרנדר באופן זהה במכונה בעוד חמישים שנה מהיום שאינה חולקת גופנים עם המכונה שייצרה אותו. גופן שאינו מוטמע הוא הוראה ללכת לחפש את Arial איפשהו במערכת התצוגה, ועמדת התקן היא ש"איפשהו במערכת התצוגה" אינה ערובה לארכוב. כל הגליפים, המדדים והכיסוי שיש לגופן החלופי, זה מה שהקורא מקבל, וייתכן שזה לא מה שהמחבר ראה
האשם ההיסטורי הוא מוסכמת Standard 14. תקן PDF 1.0 הבטיח שכל מציג מסמכים מגיע עם Helvetica, Times, Courier, Symbol, ו-ZapfDingbats, ולכן מחוללי מסמכים למדו להפנות לגופנים אלה לפי שמם ולא להטמיע דבר, ושלושים שנה של כלים עדיין עושים בדיוק את זה. ספריית PDF של losLab לוקחת את הדרישה ברצינות רבה כל כך, שבמצב יצירת PDF/A הפונקציה AddStandardFont היא במכוון ללא פעולה (no-op): הספרייה אינה מספקת את תוכניות הגופנים של Standard 14, אינה יכולה להטמיע את מה שאין ברשותה, ומסרבת לכתוב הפניה שאינה מוטמעת למסמך הטוען לתאימות. היא מחזירה 0 מבלי לבחור גופן, ולכן מסמך PDF/A חייב להשתמש ב-AddTrueTypeFont עם הטמעה במקום זאת, וכל בקשת Embed=0 מקודמת בשקט ל-Embed=1 בזמן שמצב PDF/A פעיל. זהו צד הכותב. הבעיה הקשה יותר היא צד הקורא: מסמך שמישהו אחר כבר כתב, המלא במילוני גופנים שלא אתם יצרתם
כיצד EmbedMissingFonts מתקן מסמך נטען?
ספריית PDF של losLab מתקנת גופנים במקומם במקום לבנות אותם מחדש. כאשר מחולל PDF כותב גופן TrueType שאינו מוטמע, מילון ה-FontDescriptor שהוא מייצר כבר שלם: FontName, FontBBox, Flags, Ascent, Descent, StemV, כולם נוכחים. הדבר היחיד שמפריד בינו לבין גופן מוטמע הוא היעדרו של ערך אחד, ההפניה לזרם (stream) של /FontFile2 המכיל את תוכנית הגופן בפועל. לכן EmbedMissingFonts אינו נוגע במילון הגופן, בקידוד, במערך הרוחב, או בכל זרם תוכן המפנה לגופן בשם המשאב שלו. הוא קורא את תוכנית הגופן התואמת מהמערכת, דוחס אותה לאובייקט זרם חדש, ומצרף הפניה יחידה של /FontFile2 (או /FontFile3 עבור גופני CIDFontType0) ל-FontDescriptor שכבר נמצא שם. כל מה שדפי המסמך מצביעים עליו נשאר בדיוק במקומו, וזה מה שהופך את הפעולה לבטוחה להרצה על קבצים שאינם בשליטתכם
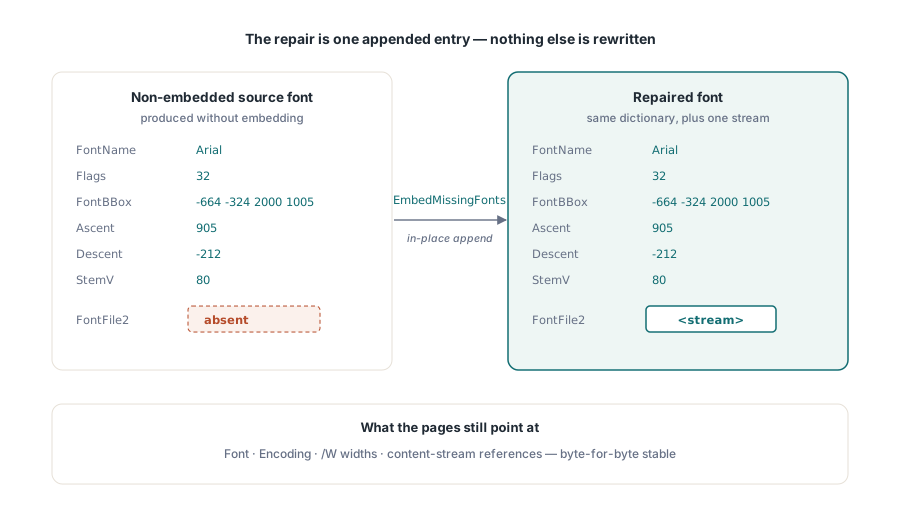
הכיסוי כולל את שתי ארכיטקטורות הגופנים שתפגשו בפועל: גופני TrueType פשוטים וגופני Type0/CID מורכבים, מהסוג המיוצר עבור טקסט CJK ופלט Unicode מודרני. המעבר מונה במכוון כל מילון גופנים (Font) בעץ האובייקטים של המסמך במקום להסתמך על מעבר משאבים דף אחר דף, כך שגם גופנים המופנים מהערות שוליים או המשותפים בין דפים נאספים. ה-API הוא קריאה יחידה במסמך הנטען
var
  PDF: TPDFlib;
  Repaired: Integer;
begin
  PDF := TPDFlib.Create;
  try
    if PDF.LoadFromFile('supplier-invoice.pdf', '') <> 1 then
      raise Exception.Create('Could not load PDF');

    // עובר על כל מילון גופן (Font); מחזיר כמה גופנים
    // קיבלו תוכנית גופן. גופנים שתוכניתם לא
    // נמצאה במערכת מדולגים, לא נכשלים.
    Repaired := PDF.EmbedMissingFonts;
    Writeln(Format('%d font program(s) embedded', [Repaired]));

    PDF.SaveToFile('supplier-invoice-repaired.pdf');
  finally
    PDF.Free;
  end;
end;
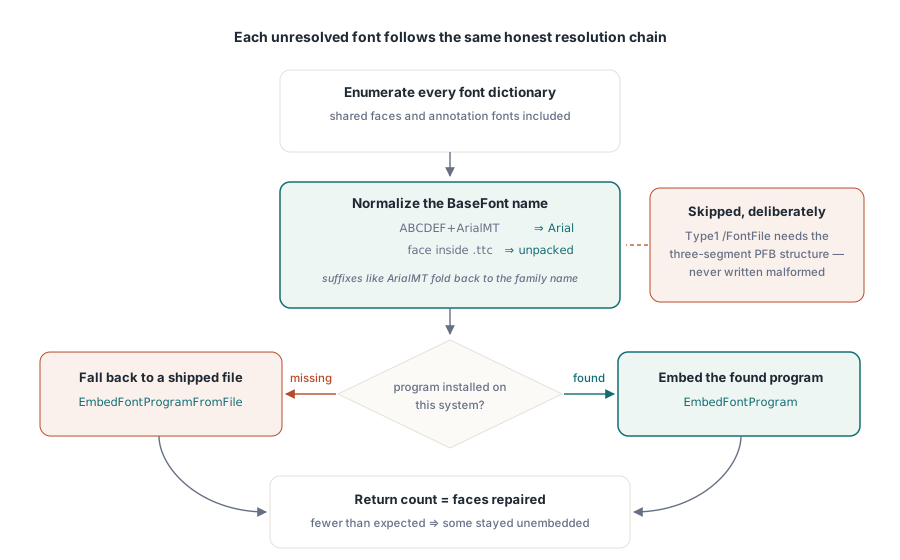
פרט אחד ראוי להכרה, משום שהוא מסביר מדוע התאמת השמות עובדת טוב יותר מהשוואת מחרוזות נאיבית: הספרייה מנרמלת שמות BaseFont לפני החיפוש. קידומות של תת-קבוצה (התבנית ABCDEF+ של שש אותיות גדולות וסימן פלוס) מוסרות, סיומות בסגנון PostScript כגון ArialMT נפתרות ל-Arial, וקובצי TrueType Collection מזוהים ונפרסים כך שגופן השוכן בתוך קובץ .ttc עדיין מוטמע כראוי
אימות התיקון באמצעות דוח preflight
CreatePreflightReport הוא שלב האימות, והלולאה נסגרת במכוון: אותו ביקורת שהרשיעה את הקובץ צריכה להיות זו שמנקה אותו. קוד שגיאה 00030 הוא ממצא ביקורת עומק של PDF/A שקורא "לפחות גופן אחד אינו מוטמע (FontFile/FontFile2/FontFile3 חסר)", והוא מדווח כנגד הקובץ כולו, כך שגופן בודד שנשמט משאיר את השגיאה פעילה. הרץ את הדוח על קובץ המקור, תקן, שמור והרץ אותו שוב על הפלט
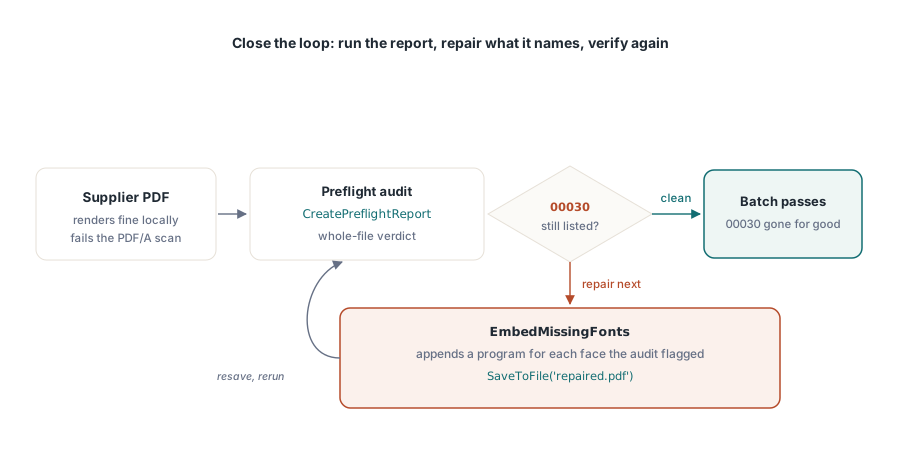
function HasFontEmbeddingViolation(PDF: TPDFlib;
  const FileName: string): Boolean;
var
  Report: string;
begin
  // ComplianceTests = 1 בוחר את בדיקות ה-PDF/A
  Report := PDF.CreatePreflightReport(FileName, '', 1, 0);
  Result := Pos('00030', Report) > 0;
end;
לתצוגה לפי גופן ולא פסק דין לפי קובץ, טען שוב את המסמך המתוקן ובצע פירוט: FindFonts ולאחריו SelectFont ו-GetFontIsEmbedded מדווחים על סטטוס ההטמעה גופן אחר גופן, שזהו הכלי הנכון כאשר משימת אצווה צריכה לתעד בדיוק איזה גופן באיזה קובץ לא ניתן היה לתקן. אותו דפוס פירוט מופיע במאמר על חילוץ טקסט, תמונות וגופנים מקובצי PDF טעונים, שם הוא מזין חילוץ במקום תיקון
מה קורה כאשר הגופן אינו מותקן במערכת?
EmbedMissingFonts מדלג על כל גופן שאינו מוצא את התוכנית שלו, ומדווח על הדילוג דרך ערך ההחזרה שלו: אם הספירה חוזרת נמוכה ממספר הגופנים הלא-מוטמעים שספרתם, ההפרש הוא גופנים שאינם קיימים במערכת. זהו מצב הכשל האמיתי, והוא טוב יותר מהחלופות, מכיוון שהמצאת תוכנית חלופית לגופן ששמו מופיע במסמך תשנה את הרינדור, וזה בדיוק מה שתיקון ארכיוני אסור שיעשה לעולם. במקרים אלה ספריית PDF של losLab מספקת את EmbedFontProgramFromFile, המטמיעה קובץ .ttf או .otf שסופק על ידי הקורא לתוך הגופן שצוין בשמו, כך שצינור עיבוד יכול לכלול את הגופנים הארגוניים שהוא מצפה להיתקל בהם ולסגת אליהם במכוון
var
  I, FontID: Integer;
begin
  PDF.FindFonts;
  for I := 1 to PDF.FontCount do
  begin
    FontID := PDF.GetFontID(I);
    if (FontID > 0) and (PDF.SelectFont(FontID) = 1) then
      if PDF.GetFontIsEmbedded = 0 then
        // נסה תחילה את גופן המערכת המותקן, ואם לא הצליח עבור
        // לקובץ גופן המצורף לצד האפליקציה
        if PDF.EmbedFontProgram(PDF.FontName) = 0 then
          PDF.EmbedFontProgramFromFile(PDF.FontName,
            'fonts\CorporateSans.ttf');
  end;
end;
שתי מגבלות ראויות לציון ברור. ראשית, גופני Type1 אינם מתוקנים במימוש הנוכחי: ערך ה-/FontFile שלהם דורש את מבנה ה-PFB תלת-המקטעים עם מפתחות אורך מפורשים, והספרייה מדלגת עליהם במקום לכתוב זרם פגום; הם נדירים במסמכים מודרניים אך מופיעים בארכיונים ישנים. שנית, הטמעת גופן היא פעולת רישוי. הרשאות ההטמעה של גופן TrueType שייכות ליוצריו, וצינור תיקון שדוחס תוכניות גופנים מורשות לתוך מסמכים היוצאים מהארגון צריך שמישהו יאשר שרישיונות הגופנים אכן מתירים זאת. הספרייה תעשה את מה שתבקשו; האם מותר לכם לבקש היא שאלה עבור המחלקה המשפטית שלכם, לא עבור המהדר שלכם
הטמעה היא הכרחית, אך לא מספיקה
תיקון גופנים מנקה את שגיאה 00030, ותו לא. מסמך שנכשל ב-PDF/A עקב הצפנה, מטא-נתוני XMP חסרים, מרחב צבע תלוי-מכשיר ללא OutputIntent, או היעדר מפות ToUnicode, עדיין ייכשל לאחר שכל גופן יוטמע, וזו הסיבה שהתיקון שייך לתוך לולאה מבוססת preflight ולא מחליף אותה. הרץ את הדוח המלא, תקן את מה שהוא מציין, ותן לדוח לומר לך מתי סיימת. ישנו גם מימד עלות: תוכנית גופן CJK מלאה מגיעה למגה-בייטים, ולכן הטמעת כמה מהם עלולה לנפח מסמך קטן בצורה דרמטית. משקל הנגד הוא תת-קבוצה (subsetting), המכוסה במאמר על אופטימיזציה של גודל קובץ PDF ותת-קבוצות של גופנים, המקצץ כל תוכנית מוטמעת רק לגליפים שהמסמך אכן מרנדר
מניעת נסיגה (regression) במסמכים חדשים
SetEmbedAllFonts הוא חצי המניעה של אותה תכונה: מנגנון הגנה בצד הכותב שמונע מהקוד שלכם לייצר את המסמכים שמאמר זה מתקן. כאשר SetEmbedAllFonts(1) פעיל, כל קריאת AddTrueTypeFont עוקבת המבקשת Embed=0 מקודמת להפניה מוטמעת, מה שמרחיב לכל מסמך את הערובה שמצב PDF/A כבר אכף. זה משפיע על גופנים שנוספו לאחר הקריאה, ולא על גופנים שכבר קיימים בקובץ טעון, כך שחלוקת העבודה ברורה: SetEmbedAllFonts עבור המסמכים שאתם יוצרים, ו-EmbedMissingFonts עבור המסמכים שאתם יורשים
PDF.NewDocument;
PDF.SetEmbedAllFonts(1);
// מכאן ואילך, AddTrueTypeFont(Name, 0) מתנהג
// כמו AddTrueTypeFont(Name, 1): שום הפניה שאינה
// מוטמעת לא יכולה להגיע לקובץ הפלט
שני החצאים, מנגנון ההגנה בצד הכותב ונתיב הטעינה-תיקון-שמירה, הם חלק מ-losLab PDF Library עבור דלפי, C# ו-VB.NET, לצד מנוע ה-preflight שמאמת את התוצאה; דף המוצר מכיל את רפרנס ה-API המלא לגופנים, כולל קריאות ההטמעה ותת-הקבוצות לכל גופן