Pour un manuel utilisateur de 40 pages dont le premier signet de premier niveau pointe la page 5, un découpeur qui coupe « de ce signet au suivant » écrit des fichiers de chapitres qui totalisent 36 pages. La couverture, la page de copyright et une table des matières de deux pages siègent devant chaque entrée de plan, donc elles n'atterrissent dans aucun fichier. Un plan ne marque que là où les sections commencent. Il ne couvre pas ce qui précède la première entrée, et rien dans le format n'exige que les entrées soient listées dans l'ordre des pages, donc un découpeur fiable collecte les pages de signets comme points de coupe, les trie et ajoute une plage explicite de pages liminaires
Une seule boucle derrière chaque mode de découpe
PDFium Component découpe un document avec les mêmes quatre étapes sur un second TPdf, quoi que décide des frontières : CreateDocument démarre un PDF vide en mémoire, ImportPages copie une plage de pages de la source vers lui, SaveAs écrit le fichier, et Active := False referme la sortie. Découpe page par page, tronçons de taille fixe et sections de signets ne diffèrent que par la chaîne de plage remise à ImportPages
Le reset en fin de chaque passe n'est pas optionnel. CreateDocument refuse de tourner sur un composant encore actif et lève un EPdfError dont le message commence par « Cannot perform this operation on an active », donc la seconde itération d'une boucle qui oublie Active := False s'arrête en exception après exactement un fichier écrit. Mettre le reset dans un bloc finally empêche un import ou une sauvegarde ratée de laisser la sortie ouverte pour la passe suivante. Une seule instance de TPdf sert toute l'exécution, et un seul document de sortie jamais tenu en mémoire
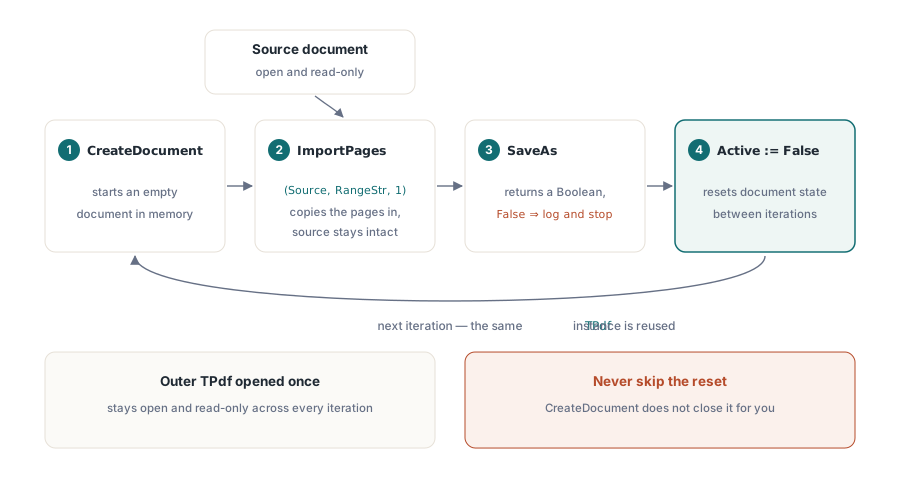
Ouvrir la source mérite son propre contrôle. Assigner Active := True ne lève jamais : quand le fichier manque, est abîmé ou réclame un mot de passe non fourni, TPdf attrape l'erreur de chargement et laisse Active à False. ImportPages tente aussi d'activer la source tout seul, ce qui signifie qu'une source non ouverte ne se manifeste que comme un retour False sur la première page et ne donne aucun indice sur la cause. L'ouvrir explicitement et tester Active transforme ça en une erreur qui nomme le fichier avant que toute sortie n'existe :
procedure SplitIntoPages(const SourceFile, OutputDir: string);
var
  Source, PdfOut: TPdf;
  I: Integer;
  OutFile: string;
begin
  Source := TPdf.Create(nil);
  PdfOut := TPdf.Create(nil);
  try
    Source.FileName := SourceFile;
    Source.Active := True;               // un échec de chargement laisse Active = False
    if not Source.Active then
      raise Exception.Create('Cannot open ' + SourceFile);

    for I := 1 to Source.PageCount do
    begin
      PdfOut.CreateDocument;             // lève tant que PdfOut est encore actif
      try
        // La plage est à base 1 ; la position 1 est le début du document vide
        if not PdfOut.ImportPages(Source, IntToStr(I), 1) then
          raise Exception.CreateFmt('Cannot import page %d', [I]);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('page_%.4d.pdf', [I]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;          // referme la sortie avant la passe suivante
      end;
    end;
  finally
    PdfOut.Free;
    Source.Free;
  end;
end;
Le troisième argument de ImportPages est la position à base 1 dans la destination où atterrit la première page importée. Dans un document vide 1 est la seule position qui existe. La syntaxe de plage elle-même (pages isolées, étendues fermées comme '5-10', listes à virgules) et les erreurs de position qui inversent un lot fusionné sont couvertes dans la fusion de plusieurs fichiers PDF en un document, qui est la même API pointée dans l'autre sens
Tronçons de taille fixe et plages fournies par l'appelant
Couper un document tous les N pages est un problème de comptage, et le seul cas qui demande du soin est la queue. Une numérisation de 230 pages coupée en parts de 25 pages donne neuf parts pleines et une dixième de cinq pages, donc la fin de chaque étendue est bornée à Source.PageCount :
procedure SplitEvery(Source: TPdf; ChunkSize: Integer; const OutputDir: string);
var
  PdfOut: TPdf;
  FirstPage, LastPage, Part: Integer;
  Range, OutFile: string;
begin
  if ChunkSize < 1 then
    raise Exception.Create('ChunkSize must be at least 1');
  PdfOut := TPdf.Create(nil);
  try
    Part := 0;
    FirstPage := 1;
    while FirstPage <= Source.PageCount do
    begin
      LastPage := FirstPage + ChunkSize - 1;
      if LastPage > Source.PageCount then
        LastPage := Source.PageCount;    // la dernière part est d'ordinaire plus courte
      if FirstPage = LastPage then
        Range := IntToStr(FirstPage)     // une queue d'une page en nombre simple
      else
        Range := Format('%d-%d', [FirstPage, LastPage]);
      Inc(Part);

      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source, Range, 1) then
          raise Exception.Create('Cannot import pages ' + Range);
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('part_%.3d.pdf', [Part]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
      FirstPage := LastPage + 1;
    end;
  finally
    PdfOut.Free;
  end;
end;
Les plages tapées par un utilisateur sont une autre affaire. ImportPages rapporte une mauvaise plage par sa valeur de retour : un numéro de page au-delà de Source.PageCount, un zéro, une étendue inversée ou du texte qui ne se parse pas fait rendre False à l'appel, et aucune page de cette chaîne n'est copiée. Dans une boucle, cet échec arrive sur la quatrième entrée alors que trois fichiers de sections existent déjà sur disque. Contrôler chaque entrée contre Source.PageCount avant le premier CreateDocument coûte quelques lignes de parseage et signifie qu'une coquille dans l'entrée quatre n'écrit rien du tout, ce qui est le comportement qu'attend une personne qui relance le travail
Quand la sélection vit déjà dans un tableau d'entiers, par exemple des pages choisies dans une vue de vignettes, ImportPagesByIndex(Source, PageIndices, InsertAt) saute l'étape chaîne. Les indices comme InsertAt y sont à base zéro, donc la même sélection qui se lit '1,3-5' en plage devient [0, 2, 3, 4]
Pourquoi les sections de signets sortent-elles courtes ou manquantes ?
Les sections de signets tournent mal quand le code fait confiance au plan pour être propre. TPdf.Bookmarks rend les entrées de premier niveau dans l'ordre où l'auteur les a arrangées, chacune comme enregistrement TBookmark avec un Title et un PageNumber à base 1. Quatre choses dans de vrais fichiers brisent la règle naïve « cette entrée à la suivante » :
- Un élément de plan peut porter sa cible comme entrée
/Destou comme action GoTo dans/A(ISO 32000-1 §12.3.3 et §12.6.4.2).PageNumberse remplit depuis/Dest; pour un élément à action il reste0et la page est dansActionPageNumberà la place - L'ordre du plan est l'ordre de lecture tel que l'auteur l'a vu. Une entrée « Index » placée en seconde, ou un annexe listée avant les chapitres, rend « signet suivant moins un » plus petit que le début courant, et cette section disparaît
- Deux entrées de premier niveau peuvent pointer la même page, typiquement un titre de partie et son premier chapitre
- Une entrée peut pointer au-delà de la dernière page quand des pages ont été supprimées par un outil qui a laissé le plan tranquille
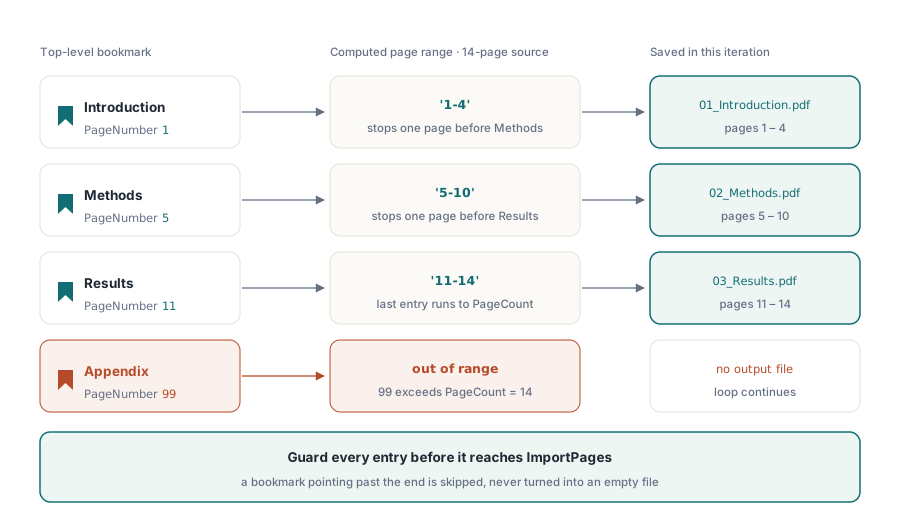
La version ci-dessous traite le plan comme une source de points de coupe. Elle résout la page de chaque entrée, jette les entrées qui ne pointent nulle part ou au-delà de la fin, garde le premier titre sur une page partagée, trie par numéro de page et ajoute une section « Pages liminaires » quand la première coupe est après la page 1. Les pages liminaires ont leur propre fichier ici au lieu d'être collées au chapitre 1, parce que la personne qui reçoit le chapitre 1 s'attend à ce qu'il s'ouvre sur la page que le signet nommait, pas sur une table des matières
procedure SplitByBookmarks(Source: TPdf; const OutputDir: string);
var
  Bm: TBookmarks;
  Starts: array of Integer;
  Titles: array of string;
  I, J, K, N, P, EndPage: Integer;
  Known: Boolean;
  PdfOut: TPdf;
  OutFile: string;
begin
  Bm := Source.Bookmarks;                // entrées de premier niveau seulement
  if Length(Bm) = 0 then
    Exit;                                // rien sur quoi couper
  SetLength(Starts, Length(Bm) + 1);     // +1 laisse la place aux pages liminaires
  SetLength(Titles, Length(Bm) + 1);
  N := 0;
  for I := 0 to High(Bm) do
  begin
    P := Bm[I].PageNumber;               // résolu depuis /Dest
    if P < 1 then
      P := Bm[I].ActionPageNumber;       // résolu depuis une action GoTo dans /A
    if (P < 1) or (P > Source.PageCount) then
      Continue;                          // non résolue, ou au-delà de la dernière page
    Known := False;
    for J := 0 to N - 1 do
      if Starts[J] = P then
        Known := True;                   // le premier titre sur une page gagne
    if Known then
      Continue;
    J := N;                              // tri par insertion selon le numéro de page
    while (J > 0) and (Starts[J - 1] > P) do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
      Dec(J);
    end;
    Starts[J] := P;
    Titles[J] := Bm[I].Title;
    Inc(N);
  end;
  if N = 0 then
    Exit;
  if Starts[0] > 1 then                  // couverture, table des matières et tout ce qui précède
  begin
    for J := N downto 1 do
    begin
      Starts[J] := Starts[J - 1];
      Titles[J] := Titles[J - 1];
    end;
    Starts[0] := 1;
    Titles[0] := 'Front matter';
    Inc(N);
  end;

  PdfOut := TPdf.Create(nil);
  try
    for K := 0 to N - 1 do
    begin
      if K < N - 1 then
        EndPage := Starts[K + 1] - 1
      else
        EndPage := Source.PageCount;
      PdfOut.CreateDocument;
      try
        if not PdfOut.ImportPages(Source,
          Format('%d-%d', [Starts[K], EndPage]), 1) then
          raise Exception.CreateFmt('Cannot import pages %d-%d',
            [Starts[K], EndPage]);
        // Déclarez SafeFileName (montré plus bas) avant cette routine
        OutFile := IncludeTrailingPathDelimiter(OutputDir) +
          Format('%.2d_%s.pdf', [K + 1, SafeFileName(Titles[K])]);
        if not PdfOut.SaveAs(OutFile) then
          raise Exception.Create('Cannot save ' + OutFile);
      finally
        PdfOut.Active := False;
      end;
    end;
  finally
    PdfOut.Free;
  end;
end;
Parce que les débuts sont strictement croissants après le tri, chaque étendue calculée est valide et le garde de ImportPages ne devrait jamais tirer sur une source lisible. Un document sans signets ne produit simplement aucun fichier dans ce mode ; l'appelant décide si ça retombe sur le découpage en tronçons. Pour couper un niveau plus profond, par exemple aux chapitres dans les parties, BookmarkChildren[Bm[I]] rend les enfants d'une entrée de premier niveau sous la même forme TBookmarks, et la même logique de points de coupe s'applique à la liste combinée
Ce que porte chaque fichier de sortie
Chaque fichier de sortie porte les pages elles-mêmes et tout ce que leurs dictionnaires de page référencent : flux de contenu, polices, images et la liste d'annotations de chaque page. Les widgets de formulaire viennent comme annotations, mais le nouveau fichier n'a pas d'AcroForm, donc ils ne sont plus des champs opérationnels. La source est seulement lue. ImportPages copie des objets dans le nouveau document et laisse la source ouverte intacte, donc la même instance Source alimente chaque itération
Le plan reste derrière. Les signets vivent dans le catalogue du document sous /Outlines (ISO 32000-1 §7.7.2), hors de toute page, donc un fichier bâti depuis des pages importées démarre sans aucun signet. Pour des fichiers de chapitres c'est souvent très bien. Quand chaque part a besoin de sa propre navigation, le plan doit se construire pour la nouvelle numérotation des pages, ce qui fait l'objet de l'édition d'un plan PDF et le remappage de ses pages. Les liens internes se comportent pareillement : un lien « voir chapitre 7 » sur la page 12 pointe une page partie dans un autre fichier, et dans ce fichier il n'a rien sur quoi atterrir
Les sources chiffrées réclament le mot de passe avant que la boucle ne démarre. Assignez Source.Password pendant que le composant est inactif, puis posez Active := True ; avec le mauvais mot de passe le composant reste inactif, ce que le contrôle dans SplitIntoPages transforme en erreur. La sortie écrite par SaveAs est un nouveau document sans dictionnaire de chiffrement. Cela convient à des fichiers découpés destinés à des destinataires différents, et quand chaque part doit être protégée à nouveau, SaveAsEncrypted(FileName, Options) prend un enregistrement TPdfEncryptOptions avec ses propres mots de passe utilisateur et propriétaire
Noms de fichiers, sauvegardes ratées et relances
Les titres de signets sont des chaînes de texte PDF et peuvent porter n'importe quoi, y compris des caractères que Windows rejette dans les noms de fichiers. Les règles viennent du système de fichiers, pas du PDF : < > : " / \ | ? * et les caractères de contrôle sont invalides, les espaces et points finaux sont rognés par les API de fichiers Win32, et des noms comme CON, PRN ou COM1 sont des périphériques réservés. Le préfixe numéroté de SplitByBookmarks se charge déjà des noms de périphériques, garde les fichiers dans l'ordre de lecture dans un listing de répertoire, et empêche deux chapitres tous deux titrés « Summary » de s'écraser l'un l'autre. Le reste est une petite fonction que vous écrivez vous-même :
// Assistant côté lecteur, hors de PDFium Component
function SafeFileName(const Title: string): string;
const
  Forbidden = '<>:"/\|?*';
var
  I: Integer;
begin
  Result := Title;
  if Length(Result) > 80 then
    SetLength(Result, 80);               // garde les chemins complets bien sous MAX_PATH
  for I := 1 to Length(Result) do
    if (Ord(Result[I]) < 32) or (Pos(Result[I], Forbidden) > 0) then
      Result[I] := '_';
  while (Result <> '') and
    ((Result[Length(Result)] = '.') or (Result[Length(Result)] = ' ')) do
    SetLength(Result, Length(Result) - 1);
  if Result = '' then
    Result := 'section';
end;
SaveAs avec un nom de fichier écrit dans un fichier temporaire du dossier cible et l'échange en place seulement après le succès de la sauvegarde. La cible est donc soit le fichier précédent, soit un nouveau complet, jamais à moitié écrit, donc relancer une découpe sur un dossier de sortie existant est sans danger. Les échecs reviennent par deux voies. SaveAs rend False quand le document ne peut pas se sérialiser, et le fichier temporaire est retiré. Les problèmes du système de fichiers, comme un dossier de sortie inexistant, un chemin que l'OS rejette ou une cible verrouillée par un visionneur, lèvent une exception depuis la couche fichiers
Comment un lot réagit à ces échecs est un choix, et pour la découpe ça diffère de la fusion. Un lot fusionné avec une part manquante est un document faux, donc s'arrêter est correct là. Les sorties découpées sont indépendantes les unes des autres : si section_147.pdf ne peut pas s'écrire parce qu'un collègue l'a ouvert, les autres sections restent bonnes. Pour les travaux de découpe, attrapez les exceptions par fichier dans la boucle, notez le nom de fichier et le message, continuez, et comparez le nombre de fichiers écrits au nombre de plages planifiées quand la boucle finit. Les exemples ci-dessus lèvent au premier échec seulement pour rester courts. Un journal qui dit que 199 fichiers sur 200 furent écrits et nomme celui qui était verrouillé se répare en une relance, tandis qu'une exécution avortée au fichier 147 laisse quelqu'un chercher quels 53 fichiers manquent
La boucle de découpe, les enregistrements de signets et la sauvegarde chiffrée employés ici voyagent tous avec PDFium Component, la bibliothèque PDF fondée sur PDFium pour Delphi et C++Builder