Un lot de numérisations peut n'être qu'un JPEG par page, sans polices, sans annotations ni signets, et échouer quand même comme PDF/raster. L'ISO 23504-1 demande plus au fichier que des pages raster seules : il doit s'identifier par un commentaire %PDF-raster-1.0 dans la zone du trailer, porter des métadonnées XMP et un /ID de trailer, et garder son catalogue et son dictionnaire Info dans de courtes listes permises. Contrôler un lot de capture demande donc deux lectures différentes, une sur les octets bruts et une sur ce que chaque page dessine réellement
Deux lectures du même fichier
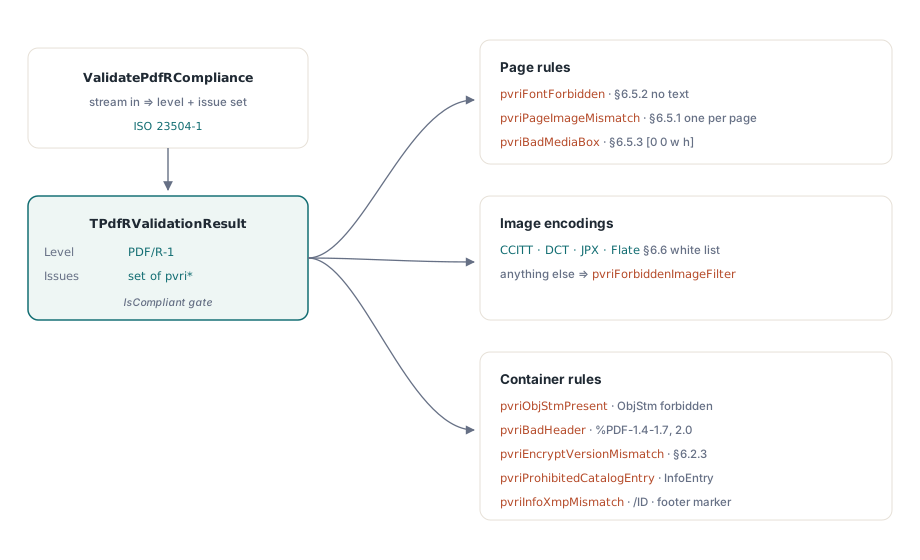
La validation PDF/R et SaveAsPdfR voyagent avec les éditions Small Business et Enterprise de PDFium Component, qui découpe la validation suivant cette ligne. ValidatePdfRCompliance dans l'unité FPdfPdfr lit un flux et contrôle les règles au niveau octets : version d'en-tête, marqueur raster, flux d'objets, entrées de catalogue et Info, XMP, /ID de trailer, origines de MediaBox, ressources de polices, noms de filtres interdits et si le nombre d'objets image égale le nombre de pages. ValidatePdfRPageFacts contrôle une page à la fois depuis un enregistrement TPdfRPageFacts : combien d'objets texte, de chemins, de formulaires et de shadings la page dessine, où siège l'image de bande unique, sa taille en pixels, sa profondeur de bits, son espace colorimétrique et sa chaîne de filtres
Les deux lectures rapportent par une seule énumération, TPdfRValidationIssue, et les points d'entrée combinés les fusionnent en un unique TPdfRValidationResult. Son champ Conformance ne devient prc1 que lorsque le marqueur raster est trouvé, et IsCompliant rend True seulement quand le niveau est prc1 et que le jeu de problèmes est vide. Un fichier parfait sous tout autre rapport mais privé du marqueur rapporte prcNone, ce qui surprend la première fois qu'on y passe une numérisation propre
La question est de savoir d'où viennent les faits de page. TPdf.ValidatePdfR les collecte depuis le document chargé, mais il sérialise d'abord ce document vers un stockage temporaire et fait tourner les contrôles d'octets sur la copie re-sauvegardée, donc les verdicts de marqueur et de catalogue décrivent une sauvegarde fraîche, qui peut différer du fichier sur disque. ValidatePdfRasterSource dans FPdfBusinessWorkflows prend un seul instantané du flux d'entrée et fait tourner les deux lectures contre lui. Pour un fichier sur le point d'entrer en archive, c'est l'appel qu'il faut : le verdict renvoie alors aux octets archivés
uses
  System.Classes, System.SysUtils, System.TypInfo,
  FPdfPdfr, FPdfReport, FPdfBusinessWorkflows;

procedure CheckDeliveredScan(const FileName: string; Log: TStrings);
var
  Src: TFileStream;
  Options: TPdfRasterSourceValidationOptions;
  Report: TPdfRasterSourceValidationReport;
  Issue: TPdfRValidationIssue;
  I: Integer;
begin
  Options := TPdfRasterSourceValidationOptions.Default;
  Options.MaxInputBytes := 512 * 1024 * 1024;     // le budget par défaut est de 64 Mio
  Options.Validation.MinimumResolutionDpi := 200; // notre contrat de capture
  Src := TFileStream.Create(FileName, fmOpenRead or fmShareDenyWrite);
  try
    if not ValidatePdfRasterSource(Src, Options, Report) then
    begin
      Log.Add(Format('Check stopped (%s): %s',
        [GetEnumName(TypeInfo(TPdfRasterSourceStatus), Ord(Report.Status)),
         Report.ErrorMessage]));
      Exit;
    end;
  finally
    Src.Free;
  end;

  if Report.IsCompliant then
    Log.Add('PDF/R-1 conformant')
  else
  begin
    // Validation.Issues porte les problèmes d'octets plus chaque problème de page
    for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
      if Issue in Report.Validation.Issues then
        Log.Add('File: ' + GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue)));
    // PageIssues dit quelles pages renumériser
    for I := 0 to Report.ProcessedPageCount - 1 do
      for Issue := Low(TPdfRValidationIssue) to High(TPdfRValidationIssue) do
        if Issue in Report.PageIssues[I] then
          Log.Add(Format('Page %d: %s', [Report.Pages[I].PageNumber,
            GetEnumName(TypeInfo(TPdfRValidationIssue), Ord(Issue))]));
  end;

  // Gardez le verdict lisible par machine à côté du fichier archivé
  Log.Add(Report.ToJson(TPdfReportLimits.Default));
end;
Deux défauts de TPdfRasterSourceValidationOptions comptent pour les lots de numérisations. MaxInputBytes vaut 64 Mio et MaxPages 1000 ; un long lot de numérisations couleur peut dépasser le budget d'octets, et le contrôle se termine alors avec le statut prssBudgetExceeded et Complete False. MemoryLimitBytes vaut 8 Mio, au-delà l'instantané déborde vers TemporaryDirectory et le rapport pose SnapshotSpilled. Report.IsCompliant exige aussi Complete, donc un contrôle arrêté à mi-chemin ne se lit jamais comme un passage
Pourquoi une couche de texte OCR rate-t-elle le PDF/R ?
Parce qu'une page raster dessine l'image numérisée et rien d'autre. Une couche OCR invisible est un ajout ordinaire dans un flux PDF/A, et elle met dans le fichier deux choses que le PDF/R exclut : une ressource de police, rapportée par la lecture d'octets comme pvriFontForbidden, et des objets de texte sur la page, rapportés par la lecture de page comme pvriNonRasterPageContent. Le même problème de page tire pour les chemins vectoriels, les shadings et les form XObjects, donc un numéro de page tamponné ou une bordure dessinée échouent pareillement qu'un texte caché
La relation page-vers-image est stricte aussi. Chaque page doit porter exactement une image de bande ; pvriPageImageMismatch tire sur une page sans image et sur une page dont la numérisation a été écrite en deux images côte à côte. Côté octets le compte est pris sur tout objet dont le /Subtype est /Image, donc tout objet image supplémentaire, un masque doux attaché à la bande par exemple, pousse le total au-delà du compte de pages
La géométrie reçoit deux contrôles. pvriBadMediaBox rapporte un MediaBox qui ne démarre pas à [0 0 ...] ; la lecture d'octets inspecte les tableaux numériques en ligne. La lecture de page compare ensuite les bornes dessinées de la bande avec le MediaBox et rapporte pvriStripGeometryInvalid quand un bord dévie de plus de GeometryTolerancePoints, 0,5 point par défaut. Un pilote de scanner qui laisse une marge blanche en mettant l'image à l'échelle de 98 % de la page échoue ici, même si la page paraît bien à l'écran. Poser RequireFullPageStrip à False éteint le test de couverture pour des fichiers internes où une marge est acceptable
Quels encodages d'images passent
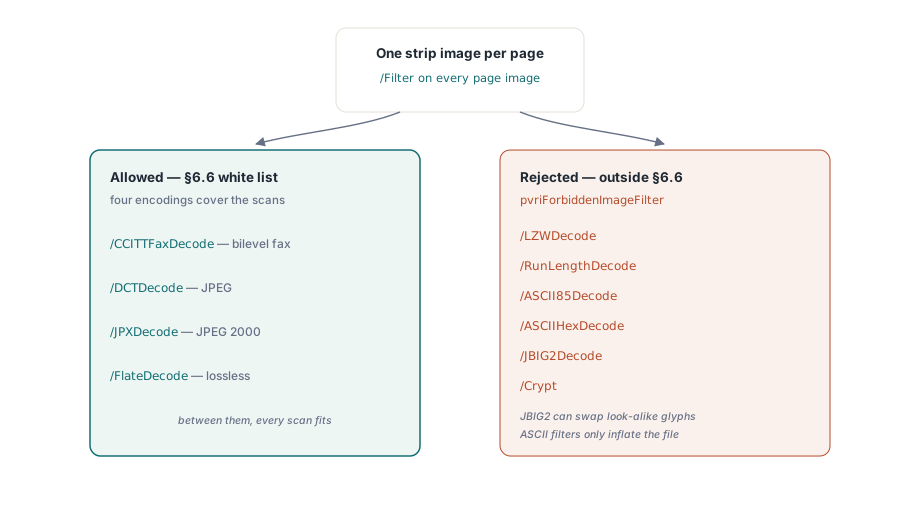
Le validateur accepte quatre filtres de bande : /CCITTFaxDecode, /DCTDecode, /JPXDecode et /FlateDecode. La lecture d'octets drape les autres filtres standard par leur nom comme pvriForbiddenImageFilter : /LZWDecode, /RunLengthDecode, /ASCII85Decode, /ASCIIHexDecode, /JBIG2Decode et /Crypt
JBIG2 est le rejet que les équipes de capture rencontrent en premier. Il est permis en PDF/A et compresse très bien les pages bilevel, donc un profil de capture bâti pour le PDF/A peut déjà l'émettre. Son mode d'appariement de motifs avec perte est aussi connu pour remplacer un glyphe numérisé par un ressemblant, un problème documenté avec des chiffres sur des formulaires numérisés, et une archive raster existe précisément pour que ce qui était sur le papier soit ce qui est dans le fichier. Réencoder ces pages en CCITT Group 4 les garde bilevel et sans perte
La lecture de page va un pas plus loin et regarde la chaîne de filtres avec la profondeur de bits et l'espace colorimétrique de l'image, rapportant les discordances comme pvriImageCompressionParametersInvalid :
- Une chaîne de plus d'un filtre est rejetée, donc une image Flate emballée en ASCII85 échoue deux fois, une fois côté octets et une fois ici
/CCITTFaxDecodedoit siéger sur une bande DeviceGray 1 bit/DCTDecodedoit siéger sur une bande 8 bits ou 24 bits en DeviceGray ou DeviceRGB/FlateDecodeest accepté sur des bandes 1 bits ; une page Flate 24 bits échoue à ce contrôle/JPXDecodeest accepté à 1, 8 ou 24 bits par pixel
Indépendamment du filtre, une bande dont l'espace colorimétrique n'est ni DeviceGray ni DeviceRGB reçoit pvriImageColorInvalid. Une numérisation basée sur ICC ou CMYK doit donc être convertie avant d'être emballée, et l'endroit le moins cher pour le faire est le profil du scanner, avant tout écrit de PDF
Comment la résolution de bande se calcule
Quand l'image porte sa propre résolution, la lecture de page l'emploie. Quand elle ne le porte pas, la résolution effective se déduit des pixels et de la taille de page : largeur en pixels fois 72 divisé par la largeur du MediaBox en points, et pareil pour la hauteur. Supposons un scanner qui écrit une bande de 2550 par 3300 pixels sur une page US Letter de 612 par 792 points. Cela donne exactement 300 dpi dans les deux directions. La même page à 600 par 776 pixels arrive à environ 70,6 dpi horizontalement, sous le minimum par défaut de 72, donc la page reçoit pvriImageResolutionInvalid
La plage par défaut dans TPdfRValidationOptions est de 72 à 2400 dpi. Ces bornes n'attrapent que les pages manifestement cassées. Un contrat de capture promet d'ordinaire un minimum précis, souvent 200 ou 300 dpi, et cette valeur a sa place dans MinimumResolutionDpi : une page à 150 dpi passe la plage par défaut, et c'est exactement la page que le contrat visait à exclure. Poser l'une des bornes à 0 éteint ce côté du contrôle
ValidatePdfRPageFacts est publique, donc les mêmes règles peuvent tourner avant qu'aucun PDF n'existe, directement depuis ce que le scanner rapporte sur chaque image :
uses
  FPdfPdfr;

// Construit les faits de page depuis la sortie du scanner ; cet assistant est à vous, hors de la bibliothèque
function ScannerStripFacts(PixelW, PixelH: Integer;
  PageWidthPt, PageHeightPt: Single; const Filter: string;
  BitsPerPixel: LongWord; ColorSpace: Integer): TPdfRPageFacts;
begin
  Result := Default(TPdfRPageFacts);
  Result.PageNumber := 1;
  Result.MediaWidth := PageWidthPt;
  Result.MediaHeight := PageHeightPt;
  Result.ImageCount := 1;
  Result.ImageRight := PageWidthPt;   // la bande couvre toute la page
  Result.ImageTop := PageHeightPt;
  Result.PixelWidth := PixelW;        // HorizontalDpi laissé à 0 : déduit
  Result.PixelHeight := PixelH;
  Result.BitsPerPixel := BitsPerPixel;
  Result.ColorSpace := ColorSpace;    // 1 = DeviceGray, 2 = DeviceRGB
  SetLength(Result.Filters, 1);
  Result.Filters[0] := Filter;
end;

var
  Opts: TPdfRValidationOptions;
  Issues: TPdfRValidationIssues;
begin
  Opts := TPdfRValidationOptions.Default;
  Opts.MinimumResolutionDpi := 300;

  // JPEG couleur 300 dpi sur Letter : ensemble vide
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'DCTDecode', 24, 2), Opts);

  // Même page compressée en Flate à 24 bits :
  // [pvriImageCompressionParametersInvalid]
  Issues := ValidatePdfRPageFacts(
    ScannerStripFacts(2550, 3300, 612, 792, 'FlateDecode', 24, 2), Opts);
end;
Catalogue, dictionnaire Info et XMP
En plus des /Type et /Pages requis, l'ISO 23504-1 ne permet dans le catalogue que Version, ViewerPreferences, PageLayout, PageMode, AcroForm et Metadata. Le validateur contrôle le catalogue contre les 21 clés standard hors de cet ensemble et lève pvriProhibitedCatalogEntry quand l'une d'elles apparaît, parmi elles Outlines, Names, PageLabels, OpenAction, StructTreeRoot, MarkInfo, Lang, OCProperties et OutputIntents. La dernière compte en pratique : un fichier PDF/A porte toujours une intention de sortie, donc un seul fichier ne peut satisfaire les deux profils
Le dictionnaire Info peut porter Creator, Producer, CreationDate et ModDate ; Title, Author, Subject, Keywords et Trapped lèvent pvriProhibitedInfoEntry. Un catalogue sans flux /Metadata reçoit pvriMissingXmpMetadata. Quand le flux est là mais que son XMP manque de l'une des xmp:CreateDate, xmp:ModifyDate et xmp:MetadataDate, la constatation est pvriMetadataInvalid à la place. pvriInfoXmpMismatch compare Producer avec pdf:Producer et Creator avec xmp:CreatorTool. Les dates sont laissées hors de cette comparaison parce que les deux encodages diffèrent légitimement, et les valeurs Info rangées en chaînes hexadécimales sont sautées. Un déclencheur typique est un outil ultérieur réécrivant le Producer de l'Info sans toucher au XMP
Les autres règles de conteneur sont courtes. L'en-tête doit être %PDF-1.4 à %PDF-1.7 ou %PDF-2.0 (pvriBadHeader), tout flux /Type /ObjStm lève pvriObjStmPresent, et un fichier chiffré doit employer un en-tête %PDF-2.0 (pvriEncryptVersionMismatch). Avec RequireEncryptedPdf20Profile laissé allumé, le dictionnaire de chiffrement doit aussi déclarer /V 5 ou 6 avec /R 5 ou plus, ou le fichier reçoit pvriEncryptedPdf20ProfileInvalid
Écrire les marqueurs
TPdfRSaveOptions porte Creator, Producer, CreationDate, ModDate, DocumentId et InstanceId, et n'a pas de champ pour Title, Author, Subject ou Keywords parce que le profil les interdit. StripInfoOptionalEntries et StripCatalogOptionalEntries valent tous deux True par défaut et retirent les entrées exclues de la source ; posez l'un à False et les entrées restent, au prix de la conformité. TPdf.SaveAsPdfR remplit les champs d'options vides depuis les métadonnées propres du document chargé et ses identifiants de fichier, retire la sécurité, puis écrit le marqueur, les dictionnaires rognés, le paquet XMP et le /ID de trailer
uses
  System.Classes, System.SysUtils, PDFium, FPdfPdfr;

procedure WrapScanAsPdfR(const InFile, OutFile: string; Log: TStrings);
var
  Pdf: TPdf;
  Opts: TPdfRSaveOptions;
  Written: TFileStream;
  Res: TPdfRValidationResult;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := InFile;
    Pdf.Active := True;
    Opts := TPdfRSaveOptions.Default;
    Opts.Creator := 'Capture Station 4';   // Producer, dates et IDs viennent de la source
    if not Pdf.SaveAsPdfR(OutFile, Opts) then
      raise Exception.Create('PDF/R save failed: ' + InFile);
  finally
    Pdf.Free;
  end;

  // Contrôlez les octets écrits, pas le document en mémoire
  Written := TFileStream.Create(OutFile, fmOpenRead or fmShareDenyWrite);
  try
    Res := ValidatePdfRCompliance(Written);
    if pvriPageImageMismatch in Res.Issues then
      Log.Add('A source page still has no single strip image');
    if pvriFontForbidden in Res.Issues then
      Log.Add('The source carries fonts; rescan or drop the text layer');
  finally
    Written.Free;
  end;
end;
L'emballage change les métadonnées et l'identification seulement. Une page source qui dessine du texte vectoriel, ou qui ne porte pas d'image de bande, sort de SaveAsPdfR avec le même contenu de page et échoue aux mêmes contrôles de page. Le contenu de page est laissé tranquille délibérément, car re-rendre une numérisation en silence changerait les pixels mêmes que l'archive est censée préserver. Lancer CheckDeliveredScan du premier listing sur OutFile donne le verdict complet, lectures de pages comprises
Où le PDF/R s'insère dans un pipeline de capture
Le PDF/R convient aux livrables où la numérisation elle-même est le registre et où la fidélité est tout le contrat : imagerie probante, capture de chèques et de virements, archives de dessins depuis un scanner grand format. Dès qu'un document réclame du texte cherchable, de l'étiquetage, des pièces jointes ou des signets, il appartient au PDF/A, car chacune de ces fonctionnalités atterrit sur les listes d'exclusion ci-dessus
Beaucoup d'équipes gardent les deux. Un original PDF/R s'écrit une fois et ne change jamais, et un dérivé PDF/A avec couche OCR sert la recherche. Les validateurs sont indépendants, donc un travail par lots peut contrôler chaque fichier contre le profil qu'il revendique. Le côté archivage est couvert dans la conformité d'archivage PDF/A et la validation de prévol PDF/A, et la sortie impression dans la validation de documents PDF/X prêts pour impression
Les contrôles PDF/R montrés ici font partie des éditions Small Business et Enterprise de PDFium Component pour Delphi, C++Builder et Lazarus, à côté des validateurs PDF/A, PDF/X, PDF/E et PDF/UA ; les éditions et les versions d'IDE soutenues sont sur la page produit de PDFium Component