Importez un FDF dans un formulaire et les valeurs de champs reviennent subtilement fausses : une puce arrive comme une obèle, une ellipse comme un tiret cadratin. PDFium Component a tracé toute cette famille de symptômes jusqu'à un seul rang de sa table PDFDocEncoding — le bloc de caractères spéciaux de l'annexe D.2 de l'ISO 32000-1 commence à $80, pas à $7F
Pourquoi un import FDF renvoie-t-il le caractère voisin ?
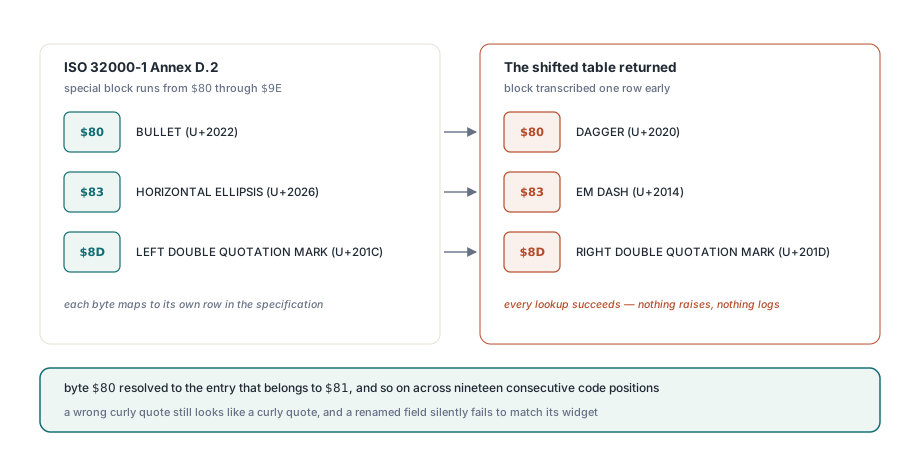
Parce qu'une table d'encodage décalée d'une position reste une table à l'air parfaitement valide, et chaque lookup dedans réussit. Le bloc que l'annexe D.2 assigne à $80 jusqu'à $9E avait été retranscrit un rang trop tôt, donc l'octet $80 résolvait vers l'entrée qui appartient à $81, l'octet $81 vers l'entrée de $82, et ainsi de suite sur dix-neuf positions de code consécutives. Rien ne levait, rien ne journalisait, et aucun champ n'était jamais rejeté — TPdf.ImportFDF rapportait le même nombre de champs que d'habitude
Les dégâts étaient uniformes et silencieux. Un octet portant $80, que l'annexe D.2 définit comme BULLET (U+2022), revenait comme DAGGER (U+2020). L'octet $83, HORIZONTAL ELLIPSIS (U+2026), revenait comme EM DASH (U+2014). L'octet $8D, LEFT DOUBLE QUOTATION MARK (U+201C), revenait comme RIGHT DOUBLE QUOTATION MARK (U+201D) — le cas que personne ne remarque, car un guillemet courbe faux ressemble toujours à un guillemet courbe dans un champ de formulaire. Les noms de champs subissaient le même sort que les valeurs de champs, ce qui est pire : un nom qui ne correspond plus au widget du document échoue silencieusement à s'appliquer
Les chaînes texte PDF portent deux encodages différents
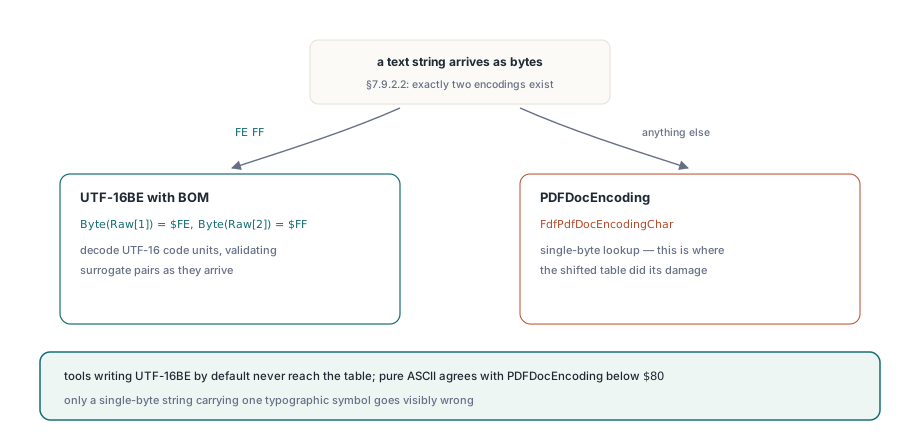
L'ISO 32000-1 §7.9.2.2 définit le type chaîne texte comme l'un de deux encodages exactement, choisi en inspectant les deux premiers octets plutôt qu'à partir d'une entrée de dictionnaire. Une chaîne qui s'ouvre sur le byte order mark FE FF est en UTF-16BE ; tout le reste est en PDFDocEncoding. Cette seule branche décide lequel de deux décodeurs complètement différents s'exécute, et PDFium Component l'applique dans le parseur FDF avant de toucher un seul caractère
// Chaîne texte FDF : UTF-16 quand le BOM est présent, PDFDocEncoding sinon
if (Length(Raw) >= 2) and
   (((Byte(Raw[1]) = $FE) and (Byte(Raw[2]) = $FF)) or
    ((Byte(Raw[1]) = $FF) and (Byte(Raw[2]) = $FE))) then
begin
  BigEndian := Byte(Raw[1]) = $FE;
  // ... décoder les unités de code UTF-16, en validant les paires de substituts
end
else
begin
  SetLength(Result, Length(Raw));
  for I := 1 to Length(Raw) do
    Result[I] := FdfPdfDocEncodingChar(Byte(Raw[I]));
end;
C'est pourquoi le bug s'est caché si longtemps dans les tests ordinaires. Tout FDF produit par un outil qui écrit en UTF-16BE par défaut n'atteint jamais FdfPdfDocEncodingChar, donc la table décalée reste dormante. Seules les chaînes mono-octets — ce que beaucoup de générateurs de FDF émettent pour les noms de champs latins simples, parce que c'est plus court — descendent dans la branche où la table compte. Les noms de champs purement ASCII se décodent alors correctement de toute façon, puisque sous $80 PDFDocEncoding et ASCII s'accordent. Il vous faut une chaîne mono-octet contenant un symbole typographique avant que quelque chose devienne visiblement faux
La table corrigée, et les deux ancres qui l'épingle
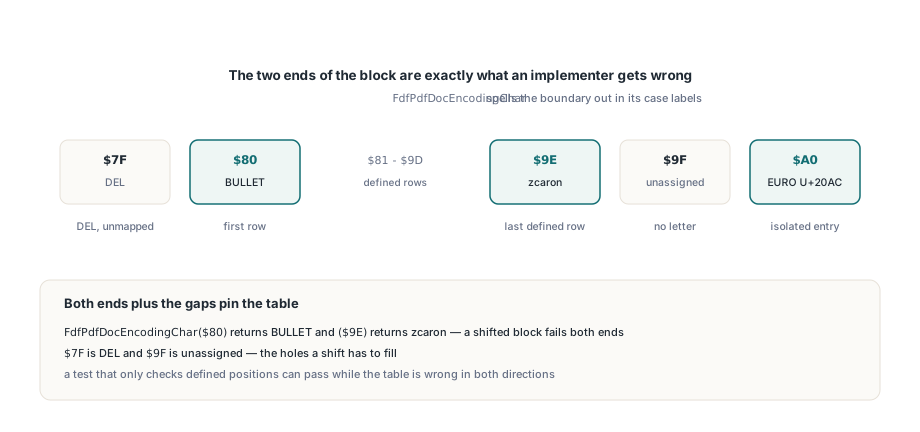
PDFium Component épelle maintenant la frontière dans FdfPdfDocEncodingChar lui-même, car les deux extrémités du bloc sont exactement ce qu'un implémenteur se trompe. $7F est DEL et n'a aucune signification PDFDocEncoding ; le bloc s'ouvre à $80 avec BULLET et court jusqu'à $9E avec zcaron ; $9F est non assigné ; et le signe euro est assis seul à $A0
function FdfPdfDocEncodingChar(Value: Byte): WideChar;
begin
  case Value of
    // ISO 32000-1 Annexe D.2. Le bloc court de $80, pas de $7F : $7F est DEL et
    // n'a aucune signification PDFDocEncoding, et l'euro est à $A0, que la
    // branche par défaut rendrait sinon comme une espace insécable
    $7F: Result := WideChar($FFFD);
    $80: Result := WideChar($2022);   // BULLET, première rangée du bloc
    $81: Result := WideChar($2020);   // DAGGER
    // ... $82 jusqu'à $9D
    $9E: Result := WideChar($017E);   // zcaron, dernière rangée définie
    $9F: Result := WideChar($FFFD);   // non assigné dans l'annexe D.2
    $A0: Result := WideChar($20AC);   // EURO SIGN
  else
    Result := WideChar(Value);
  end;
end;
Regardez ce que le décalage a fait à ces deux extrémités, car c'est là qu'un off-by-one cesse d'être cosmétique. zcaron se tenait à $9E dans la spécification mais à $9D dans la table décalée, donc un octet de document à $9E tombait au-delà de la dernière rangée que quelqu'un avait retranscrite et chutait droit dans le repli d'identité, retournant un caractère de contrôle C1 au lieu d'une lettre. Et $A0, l'euro, n'avait jamais été écrit dans la table en premier lieu — la branche d'identité le rendait comme U+00A0 NO-BREAK SPACE, un caractère qui survit à toutes les validations suivantes, ne s'imprime comme rien, et ne correspond jamais au nom de champ que vous cherchez
Comment tester une table d'encodage retranscrite ?
Testez la première rangée, la dernière rangée, et les trous — pas un échantillon du milieu. C'est la partie du correctif qui vaut la peine d'être portée à toute autre table que vous copiez hors d'une spécification, car un contrôle ponctuel au milieu du bloc est précisément le test qu'un décalage de tout le bloc survit. Vérifier que $8D donne un guillemet double gauche ne prouve rien quand $8C donne aussi quelque chose de plausible ; vérifier que $80 donne BULLET et $9E donne zcaron épingle les deux extrémités, et un bloc décalé ne peut pas satisfaire les deux à la fois
procedure CheckPdfDocEncodingAnchors;
begin
  // Les deux extrémités du bloc spécial de l'annexe D.2 : un décalage de tout le bloc les casse
  Assert(FdfPdfDocEncodingChar($80) = WideChar($2022), 'first row: BULLET');
  Assert(FdfPdfDocEncodingChar($9E) = WideChar($017E), 'last row: zcaron');
  // Les positions de code que la spécification laisse indéfinies ne doivent pas se décoder en lettre
  Assert(FdfPdfDocEncodingChar($7F) = WideChar($FFFD), '$7F is DEL, unmapped');
  Assert(FdfPdfDocEncodingChar($9F) = WideChar($FFFD), '$9F is unassigned');
  // L'entrée isolée au-dessus du bloc, facile à omettre entièrement
  Assert(FdfPdfDocEncodingChar($A0) = WideChar($20AC), 'EURO SIGN');
end;
Les positions indéfinies méritent leurs propres assertions plutôt que d'être sautées comme sans intérêt. Un off-by-one doit bien mettre quelque chose quelque part, et l'endroit où il le met est presque toujours une position de code que la spécification a laissée vide — $7F à l'avant, $9F à l'arrière. Un test qui ne vérifie que les positions définies peut passer pendant que la table est fausse dans les deux directions ; un test qui épingle les trous attrape le décalage dès la première exécution
Ce que ça coûte dans un workflow de formulaire en aller-retour
Un import FDF qui réécrit en silence un caractère par symbole est pire qu'un qui échoue, car l'échec remonte en aval et ressemble à autre chose. Les noms de champs sont le tranchant ici. TPdf.ImportFDF compare les noms entrants aux widgets du document ouvert, et un nom qui s'est décodé avec un caractère faux ne correspond simplement pas — le champ reste vide, la valeur de retour compte quand même le champ comme parsé, et le rapport qui sort du pipeline est court d'une valeur avec rien dans le log pour expliquer pourquoi. Quiconque construit une boucle d'export-réimport du genre décrit dans l'export et l'import de données de formulaire et d'annotations XFDF avec PDFium Component devrait faire un aller-retour sur un nom de champ contenant un symbole typographique, pas seulement de l'ASCII simple, avant de faire confiance à la boucle
Ça vaut aussi le coup d'être honnête sur les limites du correctif. La table correspond maintenant à l'annexe D.2 pour les 256 valeurs d'octets, ce qui fait que les chaînes FDF mono-octets se décodent correctement, mais PDFDocEncoding couvre un répertoire latin et rien de plus — tout ce qui est dehors doit arriver en UTF-16BE avec un BOM, ce qui est exactement ce que §7.9.2.2 veut. Et une chaîne UTF-16 a encore ses propres dangers séparés côté Delphi, puisqu'un point de code au-delà de U+FFFF a besoin d'une paire de substituts plutôt que d'un seul WideChar, le problème couvert dans pourquoi les emoji et les caractères CJK cassent WideChar en Delphi. Le point plus large se généralise au-delà des tables d'encodage : un parseur PDF peut rejeter quelque chose qu'il devrait accepter, ce que vous trouvez immédiatement, ou accepter quelque chose et se tromper en silence, ce que vous trouvez en production. Les pièges de name tokens décrits dans l'analyse sécurisée des dictionnaires PDF sont dans cette seconde catégorie, et une table décalée d'un rang aussi — le chemin de code réussit, la valeur de retour a l'air raisonnable, et seul un test écrit contre la spécification plutôt que contre l'implémentation dit le contraire
ImportFDF, ExportFDF et ImportXFDF sur TPdf, avec les parseurs FDF et XFDF derrière eux, font partie du PDFium Component standard pour Delphi et C++Builder