Un dictionnaire Info portant /ModDate (D:20260827093659+08'00') et un paquet XMP portant xmp:ModifyDate en 2026-08-27T01:36:59Z décrivent la même seconde, et un validateur PDF/A a toutes les raisons d'accepter cette paire. Copiez pourtant la chaîne Subject du document dans dc:subject, et le paquet échoue même quand le texte correspond caractère pour caractère. ISO 19005-1 §6.7.3 demande des valeurs équivalentes, placées dans des propriétés XMP spécifiques, dans des formes RDF spécifiques
Le rapport de bug qui ouvre d'ordinaire ce sujet a l'air inoffensif. Un système de gestion documentaire estampille un /ModDate neuf dans le dictionnaire Info à chaque sauvegarde incrémentale et laisse le paquet XMP tranquille. Des mois plus tard, un audit d'archives signale des milliers de fichiers. Les deux dates sont là ; elles ont cessé d'être d'accord à la première édition, et un contrôle qui ne cherche que l'existence de la propriété ne l'a jamais vu. Des éditions de Title passées par une API Info seule échouent de la même façon, et une chaîne Author comme Finance; Controlling que certains outils scindent en deux éléments dc:creator aussi
Ce que ISO 19005-1 exige d'Info et de XMP
Le Tableau 1 de ISO 19005-1 apparie huit clés Info à des propriétés XMP, et le §6.7.3 dit que dès qu'une clé Info est présente, la propriété XMP mappée doit porter une valeur équivalente. Une clé absente n'exige rien. PDF/A-2 et PDF/A-3 gardent la même exigence d'équivalence pour les mêmes huit clés. PDF/A-4 prend le chemin inverse et restreint le dictionnaire Info lui-même : il ne peut apparaître qu'en compagnie d'un /PieceInfo de catalog et ne porter alors rien d'autre que ModDate, ce que TPdf.ValidatePdfA signale via pvaiPdfA4InfoWithoutPieceInfo et pvaiPdfA4InfoInvalid
Dans PDFium Component, la comparaison vit dans ComparePdfAInfoAndXmp dans FPdfPdfa.pas. Elle recherche chaque propriété par URI de namespace, si bien qu'un paquet qui lie http://purl.org/dc/elements/1.1/ à un préfixe inhabituel se lit exactement comme un paquet utilisant dc. Les formes mappées sont :
- Title →
dc:titleet Subject →dc:description: une alternative de languerdf:Alt, comparée uniquement à son élémentx-default; l'étiquette de langue est appariée sans tenir compte de la casse, et un Alt sansx-defaultcompte comme absent - Author →
dc:creator: unrdf:Seqavec exactement un élément texte portant toute la chaîne Info, si bien qu'une liste d'auteurs séparés par des points-virgules reste une entrée unique - Keywords →
pdf:Keywordset Producer →pdf:Producer(namespacehttp://ns.adobe.com/pdf/1.3/) : propriétés texte simples - Creator →
xmp:CreatorTool, CreationDate →xmp:CreateDate, ModDate →xmp:ModifyDate(namespacehttp://ns.adobe.com/xap/1.0/) : propriétés texte simples
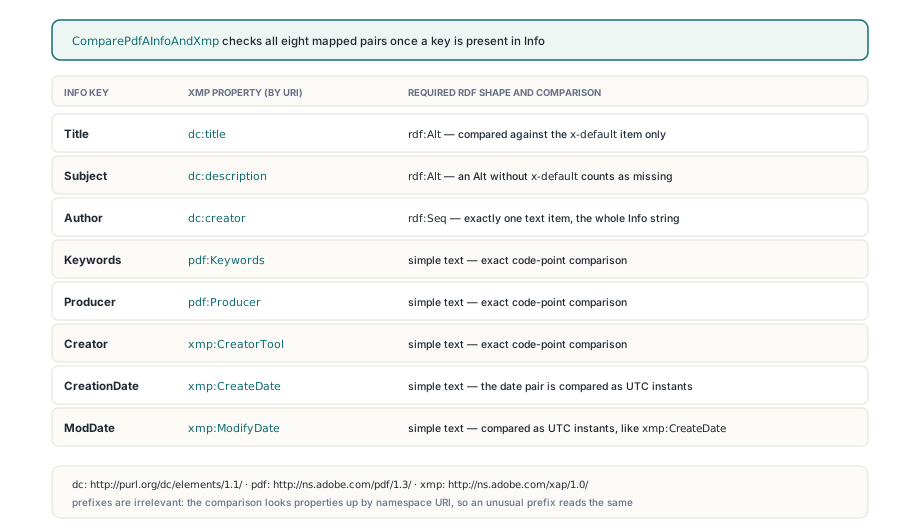
La ligne Subject est celle où les gabarits faits à la main se trompent le plus souvent. Le dc:subject de Dublin Core est un bag non ordonné de mots-clés, et le nom invite à y déposer le Subject du Info. La comparaison cherche dc:description, ne trouve rien, et rapporte Subject comme pamsXmpMissing pendant que le texte « bon » se trouve à une propriété de distance. Trois lignes dans les formes correctes ressemblent à ceci :
<dc:title><rdf:Alt><rdf:li xml:lang="x-default">Quarterly Report 2026</rdf:li></rdf:Alt></dc:title>
<dc:creator><rdf:Seq><rdf:li>Finance; Controlling</rdf:li></rdf:Seq></dc:creator>
<pdf:Producer>PDFium Component</pdf:Producer>
Pourquoi une chaîne correcte échoue-t-elle quand même à la comparaison ?
Une chaîne correcte échoue quand elle se trouve dans le mauvais conteneur ou diffère d'un seul point de code. Les valeurs texte sont comparées comme des séquences exactes de points de code Unicode, sans retrait d'espaces, sans mise en casse ni normalisation. Un espace final est une divergence. Un é précomposé d'un côté contre un e décomposé plus accent aigu combinatoire de l'autre aussi, même si les deux se rendent habituellement à l'identique à l'écran
Les erreurs de forme obtiennent leur propre état. Un dc:title écrit en texte simple, un dc:creator déclaré rdf:Bag, ou un Seq dc:creator à deux éléments produisent tous pamsXmpTypeMismatch plutôt que pamsValueMismatch, si bien qu'un rapport peut distinguer « l'outil a pris la mauvaise structure RDF » de « l'outil a écrit un texte différent ». Les deux problèmes viennent d'habitude d'endroits différents d'un pipeline, et réparer le mauvais coûte un après-midi
Le côté Info vient toujours du décodage maison de PDFium des chaînes PDFDocEncoding et UTF-16BE via FPDF_GetMetaText, le même chemin qu'utilise TPdf.GetMetadata, si bien qu'une chaîne avec une marque d'ordre d'octets ou une séquence octale échappée est lue comme le moteur la lit. Le côté XMP n'est propre que comme les octets qui l'ont produit. Un paquet assemblé avec le mauvais code page peut porter du mojibake qu'aucune comparaison ne pardonnera, voilà pourquoi les pièges de code page qui corrompent les métadonnées XMP sous Free Pascal appartiennent à la même liste de contrôle
Quand une date PDF et une date XMP sont-elles égales ?
Une date PDF et une date XMP sont égales quand elles décrivent le même instant à la seconde près avec la même connaissance de fuseau des deux côtés. Les deux analyseurs acceptent une précision réduite légale, donc D:2026 et 2026 signifient tous deux le 1er janvier 2026 à minuit. Quand les deux valeurs portent un fuseau, chacune est d'abord convertie en UTC : D:20260827093659+08'00' égale 2026-08-27T01:36:59Z. Quand aucune ne porte de fuseau, les composantes locales sont comparées telles qu'écrites
Quand un seul côté a un fuseau, le résultat est pamsValueMismatch. Inventer un décalage pour la valeur sans fuseau serait une supposition, et une supposition qui coïncide avec le fuseau du serveur passerait sur une machine et échouerait sur une autre. Une fraction de seconde non nulle telle que .250 en XMP force aussi une divergence, car une date PDF n'a aucun moyen de l'exprimer ; .000 est accepté. Les valeurs qui ne s'analysent pas du tout sont rapportées comme pamsInvalidInfoDate ou pamsInvalidXmpDate
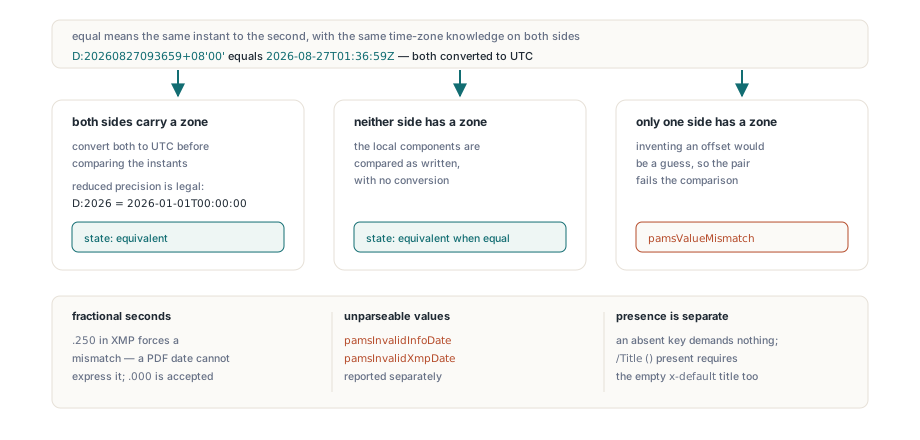
Les deux grammaires de date ne sont pas interchangeables, et les analyseurs tiennent chaque côté à la sienne. Côté PDF, les apostrophes autour des minutes de décalage sont optionnelles et Z est accepté. Côté XMP, le décalage a besoin d'un deux-points : 2026-08-27T09:36:59+08:00 s'analyse, tandis que +0800 vaut pamsInvalidXmpDate. Le temps XMP exige aussi au moins heures et minutes dès qu'un T apparaît, et les décalages au-delà de 14 heures sont rejetés des deux côtés. Les espaces autour sont retirés avant l'analyse d'une date, une politesse que les champs texte n'obtiennent pas
La présence a sa propre règle. TPdfAMetadataValues.Present est un ensemble rempli en parcourant le dictionnaire /Info du trailer actif, et il distingue une clé absente d'une clé présente avec une chaîne vide. Une clé absente donne pamsNotRequired. /Title () est présent, donc le paquet doit porter aussi un titre x-default vide
Lire le rapport par champ avant de toucher au fichier
TPdf.InspectPdfAMetadata renvoie un TPdfAMetadataReport avec un TPdfAMetadataComparison par champ. Chaque entrée porte la valeur Info, la valeur XMP et un TPdfAMetadataState, si bien qu'un échec peut être expliqué champ par champ. MismatchFields collecte l'ensemble en échec, HasXmpPacket dit si un paquet a été trouvé, et XmpParseError transporte le message de l'analyseur quand un paquet existe mais ne peut pas être lu. Dans ce dernier cas, chaque champ présent rapporte pamsXmpMissing, car rien n'a pu être lu du paquet
uses
  System.SysUtils, PDFium, FPdfPdfa;

const
  FieldNames: array[TPdfAMetadataField] of string = (
    'Title', 'Author', 'Subject', 'Keywords',
    'Creator', 'Producer', 'CreationDate', 'ModDate');
  StateNames: array[TPdfAMetadataState] of string = (
    'not required', 'equivalent', 'XMP missing', 'XMP type mismatch',
    'value mismatch', 'invalid Info date', 'invalid XMP date');

procedure ReportMetadata(Pdf: TPdf);
var
  Report: TPdfAMetadataReport;
  Item: TPdfAMetadataComparison;
begin
  Report := Pdf.InspectPdfAMetadata;
  if Report.XmpParseError <> '' then
    Writeln('XMP packet unreadable: ', Report.XmpParseError)
  else if not Report.HasXmpPacket then
    Writeln('No XMP packet at all');
  for Item in Report.Comparisons do
    if not Item.IsEquivalent then
      Writeln(Format('%-12s %-18s Info="%s" XMP="%s"',
        [FieldNames[Item.Field], StateNames[Item.State],
         Item.InfoValue, Item.XmpValue]));
end;
TPdf.ValidatePdfA intègre la même comparaison dans son ensemble d'anomalies. Le scan au niveau octet, décrit dans la validation preflight PDF/A avec PDFium Component, signale pvaiMissingXmpDates quand le paquet manque des deux propriétés de date et pvaiInfoXmpDateMismatch quand Info porte CreationDate ou ModDate mais que le paquet n'a aucune propriété de date correspondante. Par-dessus, ValidatePdfA exécute la comparaison complète des valeurs et ajoute pvaiInfoXmpValueMismatch dès qu'un paquet existe mais contredit Info, paquet illisible compris. Un document sans paquet du tout n'est signalé que comme pvaiMissingXmpMetadata, si bien qu'un défaut n'apparaît jamais deux fois. La fonction au niveau flux ValidatePdfACompliance effectue le scan au niveau octet seul
function MetadataGateOk(Pdf: TPdf): Boolean;
var
  Res: TPdfAValidationResult;
begin
  Res := Pdf.ValidatePdfA;
  if pvaiMissingXmpMetadata in Res.Issues then
    Writeln('No usable XMP packet: rebuild the file with SaveAsPdfA');
  if pvaiInfoXmpDateMismatch in Res.Issues then
    Writeln('Info has a date property the XMP packet lacks entirely');
  if pvaiInfoXmpValueMismatch in Res.Issues then
    Writeln('Mapped values disagree: run InspectPdfAMetadata for details');
  Result := Res.IsCompliant;
end;
Ce que NormalizePdfAMetadata réécrit, et où il s'arrête
TPdf.NormalizePdfAMetadata traite le dictionnaire Info comme source de vérité et ne réécrit que les propriétés XMP dont le champ a atterri dans MismatchFields. Title et Subject vont dans l'élément x-default tandis que les autres alternatives de langue restent intactes. Author devient un rdf:Seq à un élément. Une date Info avec fuseau est écrite comme date XMP UTC canonique avec suffixe Z, et une date sans fuseau garde ses composantes locales. Les namespaces inconnus, les propriétés sans rapport et les propriétés XMP des clés Info absentes ne sont pas touchés, et une liaison de préfixe existante est réutilisée quand une propriété est réécrite
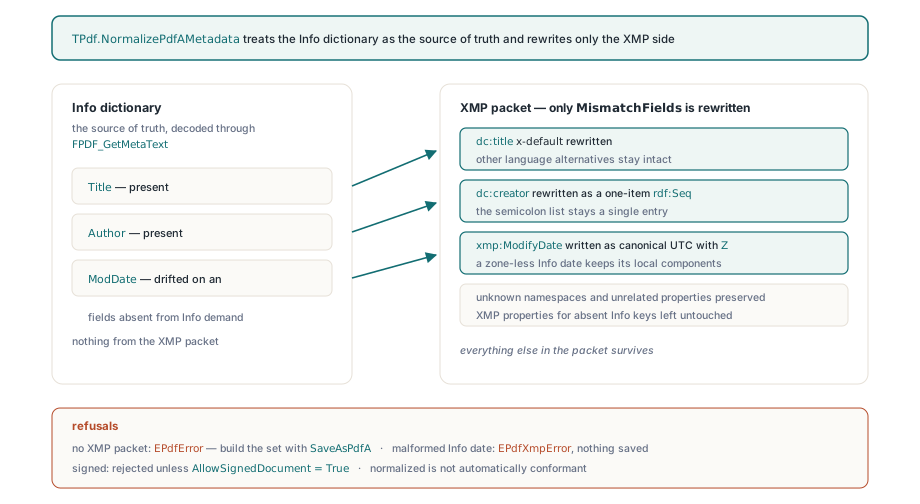
Faire d'Info l'autorité a un coût qui apparaît sur de vrais fichiers. Un Seq dc:creator listant « Finance » et « Controlling » comme deux personnes est remplacé par un élément unique portant Finance; Controlling, et un dc:title stocké dans le mauvais conteneur est reconstruit en un Alt neuf ne tenant que x-default, si bien que ce que l'ancien conteneur portait disparaît. Cette perte est acceptable ici. Le Tableau 1 n'autorise qu'un seul élément créateur, la chaîne Info porte déjà la liste complète en une pièce, et le paquet d'origine reste dans le fichier source si quelqu'un a besoin de la liste plus riche
Les refus sont délibérés. Sans paquet XMP, la méthode lève EPdfError : construire un jeu complet d'identification et de métadonnées PDF/A est le travail de SaveAsPdfA, couvert dans la création de fichiers d'archivage PDF/A avec PDFium Component. Un paquet illisible ou une date Info mal formée lève EPdfXmpError avant que quoi que ce soit soit écrit, car une date fausse d'apparence plausible en XMP est pire qu'aucune sortie. Les documents signés lèvent EPdfError sauf si l'appelant passe AllowSignedDocument = True ; la sortie est une sauvegarde complète avec les nouvelles métadonnées ajoutées en mise à jour incrémentale, si bien que les octets signés ne sont pas reportés tels quels
Ce chemin de sauvegarde a une conséquence de plus. NormalizePdfAMetadata écrit un nouveau fichier même quand chaque champ correspond déjà, puisque synchroniser rien finit quand même en sauvegarde. Appelez d'abord InspectPdfAMetadata et sautez les fichiers équivalents ; une tâche nocturne qui réécrit des milliers d'archives inchangées n'achète que de nouveaux horodatages. La surcharge par fichier écrit via un fichier temporaire et remplace la cible de façon atomique. Le fichier source reste ouvert tant que le document est chargé, donnez donc à la sortie un chemin différent
uses
  System.SysUtils, PDFium, FPdfPdfa, FPdfXmp;

procedure NormalizeArchive(const Source, Target: string);
var
  Pdf: TPdf;
  Report: TPdfAMetadataReport;
begin
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := Source;
    Pdf.Active := True;
    Report := Pdf.InspectPdfAMetadata;
    if Report.IsEquivalent then
      Exit;                      // déjà cohérent, laisser le fichier tranquille
    if not Report.HasXmpPacket then
      raise Exception.Create('No XMP packet: convert with SaveAsPdfA instead');
    try
      if not Pdf.NormalizePdfAMetadata(Target) then
        raise Exception.Create('Normalized save failed');
    except
      on E: EPdfXmpError do      // date Info mal formée ou paquet illisible
        raise Exception.CreateFmt('Cannot normalize %s: %s', [Source, E.Message]);
      on E: EPdfError do         // entrée signée sans AllowSignedDocument
        raise Exception.CreateFmt('Skipped %s: %s', [Source, E.Message]);
    end;
  finally
    Pdf.Free;
  end;
end;
L'équivalence est une clause de ISO 19005-1. Un fichier normalisé doit quand même passer polices, couleur, transparence et tous les autres contrôles PDF/A, si bien que ValidatePdfA reste le verrou avant qu'un document ne parte vers le stockage à long terme
Comparer un paquet sans document chargé
ComparePdfAInfoAndXmp et SynchronizePdfAInfoToXmp sont des fonctions ordinaires de FPdfPdfa qui travaillent sur un TPdfXmpPacket sans PDF ouvert, ce qui convient aux tests unitaires et aux pipelines qui remplissent du XMP depuis un gabarit avant que le document n'existe. SynchronizePdfAInfoToXmp renvoie l'ensemble des champs qu'elle a réécrits et lève EPdfXmpError si on lui passe un paquet nil
Le seul piège est Present. Un enregistrement initialisé avec Default(TPdfAMetadataValues) a un ensemble vide, chaque champ rapporte alors pamsNotRequired, et la comparaison passe quelles que soient les valeurs que vous avez remplies. Les champs chaîne de l'enregistrement portent des valeurs ; seul Present décide lesquels la norme exige réellement
uses
  System.SysUtils, System.IOUtils, FPdfPdfa, FPdfXmp;

procedure AlignTemplate(const TemplateFile: string);
var
  Info: TPdfAMetadataValues;
  Packet: TPdfXmpPacket;
  Changed: TPdfAMetadataFields;
begin
  Info := Default(TPdfAMetadataValues);
  Info.Title := 'Quarterly Report 2026';
  Info.Author := 'Finance; Controlling';
  Info.ModDate := 'D:20260827093659+08''00''';
  // Present décide quels champs sont obligatoires ; les valeurs seules sont ignorées
  Info.Present := [pamfTitle, pamfAuthor, pamfModDate];

  Packet := TPdfXmpPacket.Parse(TFile.ReadAllText(TemplateFile, TEncoding.UTF8));
  try
    Changed := SynchronizePdfAInfoToXmp(Info, Packet);
    // un xmp:ModifyDate en désaccord devient 2026-08-27T01:36:59Z,
    // un dc:creator en désaccord devient un rdf:Seq à un élément
    if Changed <> [] then
      TFile.WriteAllBytes(TemplateFile, Packet.ToUtf8);
  finally
    Packet.Free;
  end;
end;
Faire passer le même gabarit dans ComparePdfAInfoAndXmp ensuite devrait renvoyer un MismatchFields vide, ce qui fait une assertion bon marché pour une étape de build qui régénère des gabarits
Les archives que d'autres systèmes continuent d'éditer dérivent un champ à la fois, et le rapport par champ montre lequel a bougé. InspectPdfAMetadata, NormalizePdfAMetadata et le reste de l'outillage de validation et de conversion PDF/A font partie de PDFium Component pour Delphi et C++Builder