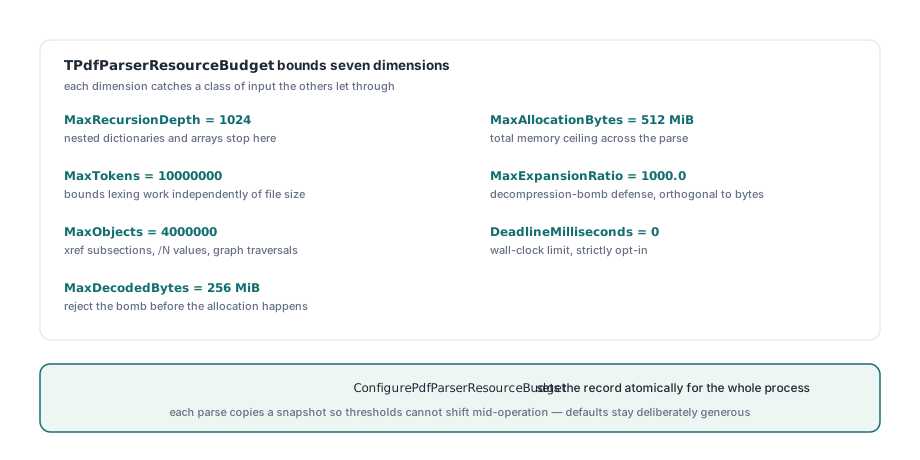
PDFium Component expose TPdfParserResourceBudget, un seul record qui borne la profondeur de récursion, le nombre de tokens, le nombre d'objets, les octets décodés, le ratio d'expansion, l'allocation et une deadline temps réel pour chaque parseur PDF de la bibliothèque. ConfigurePdfParserResourceBudget le définit atomiquement pour le processus, et chaque parse copie un snapshot pour que ses seuils ne puissent pas bouger en cours d'opération
Six parseurs, six plafonds privés
La situation qui a forcé ça était banale et sans doute familière. La traversée xref sparse avait son propre plafond d'objets. L'inspecteur de flux avait son propre plafond d'octets décodés. XMP en avait un, XFDF et FDF un autre, la normalisation de contenu un troisième, et les défauts de preflight un quatrième. Chacun de ces nombres était défendable isolément et aucun n'était atteignable de l'extérieur, donc un appelant qui voulait dire « ce chemin d'entrée gère des uploads anonymes, rien ici ne peut allouer plus de 64 MiB ni tourner plus de quatre secondes » n'avait nulle part où le dire. Le second problème était pire parce qu'il était silencieux : là où une limite vivait dans un global mutable, un parse commencé sous une politique pouvait finir sous une autre. Un thread appelle un setter pendant qu'un autre est à mi-chemin d'un object stream, et la première moitié de cette traversée est bornée par l'ancien plafond tandis que la seconde moitié est bornée par le nouveau. Rien ne plante, rien ne journalise, et après coup vous ne pouvez pas dire sous quelles limites l'opération a réellement tourné, ce qui est exactement la propriété pour laquelle vous vouliez ces limites
Que borne réellement TPdfParserResourceBudget ?
Sept dimensions, choisies parce que chacune attrape une classe d'entrées que les autres laissent passer. MaxRecursionDepth vaut 1024 par défaut et empêche les dictionnaires et tableaux imbriqués de transformer la syntaxe d'objet de l'ISO 32000-1 §7.3 en stack overflow. MaxTokens vaut 10 000 000 par défaut et borne le travail de lexing indépendamment de la taille du fichier. MaxObjects vaut 4 000 000 par défaut et couvre les comptes de sous-sections de cross-reference, les valeurs /N d'object stream et les traversées de graphes. MaxDecodedBytes vaut 256 MiB par défaut et MaxAllocationBytes 512 MiB, donc un fichier peut être rejeté avant l'allocation plutôt qu'après. MaxExpansionRatio vaut 1000.0 par défaut et c'est celle qu'on sous-estime : les filtres de flux de l'ISO 32000-1 §7.4 sont de la compression généraliste, quelques kilo-octets de données Flate peuvent légitimement s'expanser en centaines de méga-octets, et un plafond de ratio est la défense standard contre une bombe de décompression. C'est orthogonal au plafond d'octets absolu, car un flux de 200 KiB qui veut devenir 200 MiB est sous le plafond de 256 MiB et reste absurde. DeadlineMilliseconds vaut 0 par défaut, ce qui veut dire pas de deadline, donc cette dimension est strictement opt-in. Les défauts, pris ensemble, sont délibérément généreux, calibrés pour que les documents métier ordinaires ne déclenchent rien plutôt que pour être un profil durci ; si votre entrée arrive d'un formulaire d'upload public, vous voulez quelque chose de plus proche des nombres ci-dessous, avec les règles décrites dans le durcissement d'un volet de prévisualisation PDF en Delphi
uses
  FPdfPdfCommon;

procedure ApplyUntrustedIntakeBudget;
var
  Budget: TPdfParserResourceBudget;
begin
  Budget := TPdfParserResourceBudget.Default;
  // Défauts conservés : MaxRecursionDepth 1024, MaxTokens 10000000,
  // MaxObjects 4000000
  Budget.MaxDecodedBytes      := Int64(32) * 1024 * 1024;  // défaut 256 MiB
  Budget.MaxAllocationBytes   := Int64(64) * 1024 * 1024;  // défaut 512 MiB
  Budget.MaxExpansionRatio    := 50.0;                     // défaut 1000.0
  Budget.DeadlineMilliseconds := 4000;                     // défaut 0 = désactivé
  ConfigurePdfParserResourceBudget(Budget);
end;
Pourquoi prendre un snapshot plutôt que de lire le global ?
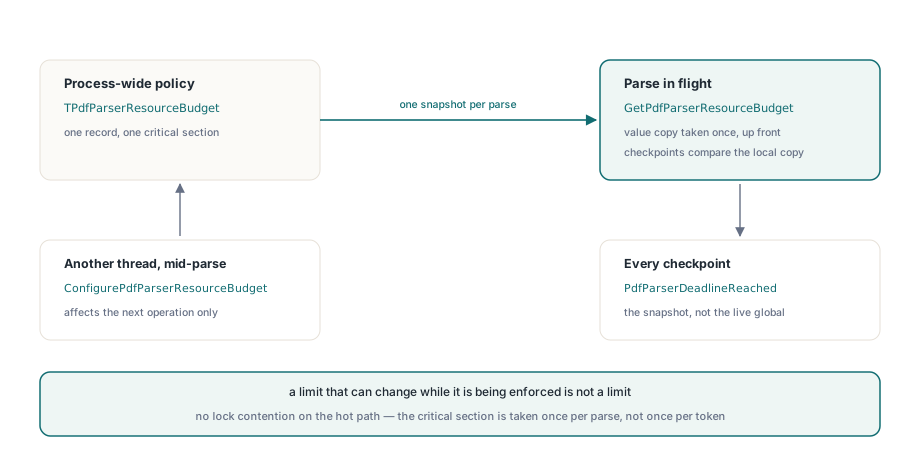
Parce qu'une limite qui peut changer pendant qu'elle est appliquée n'est pas une limite. C'est le point de conception central de toute la fonctionnalité, et c'est une ligne de discipline à chaque point d'entrée : lire la politique une fois au début de l'opération dans un TPdfParserResourceBudget local, puis faire comparer chaque checkpoint contre cette copie locale. GetPdfParserResourceBudget prend la section critique et rend une copie par valeur du record, et après ça le parse ne touche plus jamais l'état global mutable. Le résultat, c'est qu'un appel à ConfigurePdfParserResourceBudget depuis un autre thread affecte la prochaine opération, jamais celle en vol. Des parses concurrents tournent sous des politiques différentes sans interférer, une opération qui a échoué sur une limite de ressources a échoué contre un ensemble cohérent unique de seuils, et il n'y a pas de contention de lock sur le chemin chaud car le lock est pris une fois par parse plutôt qu'une fois par token
type
  TCustomScanState = record
    Budget: TPdfParserResourceBudget;
    StartTick: Cardinal;
    TokenCount: Int64;
    Depth: Integer;
  end;

procedure BeginScan(var S: TCustomScanState);
begin
  S.Budget := GetPdfParserResourceBudget;  // snapshot pris une fois, d'entrée de jeu
  S.StartTick := PdfParserStartTick;
  S.TokenCount := 0;
  S.Depth := 0;
end;

function ScanCheckpoint(var S: TCustomScanState): Boolean;
begin
  Result := False;
  if PdfParserDeadlineReached(S.StartTick, S.Budget) then
    Exit;
  Inc(S.TokenCount);
  if S.TokenCount > S.Budget.MaxTokens then
    Exit;
  if S.Depth > S.Budget.MaxRecursionDepth then
    Exit;
  Result := True;
end;
Si vous écrivez votre propre parseur par-dessus la bibliothèque, copiez cette forme plutôt que d'appeler GetPdfParserResourceBudget dans votre boucle de tokens. L'appeler par token est correct mais inutile : vous payez une section critique à chaque itération et vous réintroduisez la dérive en cours d'opération que le snapshot était là pour empêcher
Pourquoi un plafond d'octets n'arrête-t-il pas un fichier pathologique ?
Parce que la taille et le coût ne sont que vaguement liés en PDF. Un fichier de 400 KiB avec un flux de cross-reference de l'ISO 32000-1 §7.5.8 dont les tableaux /Index et /W décrivent un nombre d'entrées plausible mais hostile, une chaîne d'object streams qui revisite les mêmes offsets, ou un flux de contenu d'opérateurs qui coûtent chacun plus qu'ils n'en ont l'air, se tiendra confortablement sous tous les plafonds d'octets et d'objets que vous fixez et occupera quand même un thread de travail pendant des minutes. Les compteurs d'octets bornent la mémoire ; ils ne bornent pas le temps. C'est à ça que servent PdfParserStartTick et PdfParserDeadlineReached. PdfParserStartTick capture une valeur de tick au début de l'opération et PdfParserDeadlineReached compare le temps écoulé à DeadlineMilliseconds, retournant False chaque fois que la deadline est 0. La soustraction se fait en arithmétique non signée, donc un retour à zéro du compteur de ticks ne produit pas de timeout fantôme. L'analyse de cross-reference, le décodage d'object streams, la normalisation de tokens de contenu et les lecteurs FDF et XFDF la vérifient tous en tête de boucle, donc un parse au-dessus du budget s'arrête à un checkpoint au lieu d'être tué de l'extérieur
Deux mises en garde honnêtes. C'est du temps réel, pas du temps CPU, donc une machine qui swappe ou un serveur de build sous charge peut déclencher une deadline qu'une machine calme passerait, ce qui plaide pour la fixer bien au-dessus de votre pire cas observé plutôt que près de votre médiane. Et elle est désactivée par défaut, parce qu'une deadline qui se déclenche sur un document légitimement gros pendant un traitement batch de fin de mois est un échec pire que celui qu'elle empêche. Activez-la par chemin d'entrée plutôt que globalement, et associez-la aux vérifications structurelles de la validation des flux de cross-reference
Le budget est un plafond, pas un remplaçant des limites de format
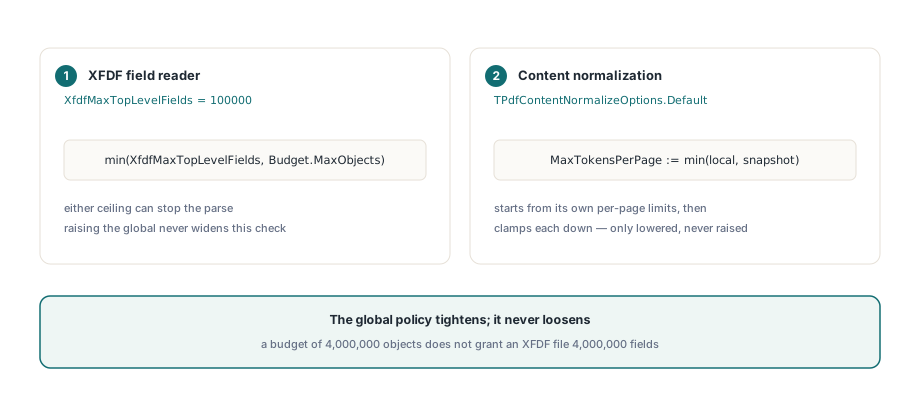
Chaque parseur garde ses propres constantes spécifiques au format et applique les deux. XFDF est l'exemple le plus clair : le lecteur de champs applique XfdfMaxTopLevelFields et une constante MaxFieldNodes de 100000 aux côtés de la valeur du snapshot, et l'un comme l'autre peut arrêter le parse
const
  XfdfMaxTopLevelFields = 100000;   // local au format, s'applique toujours
...
  // Les deux plafonds sont actifs ; le plus bas gagne
  if (FieldCount >= XfdfMaxTopLevelFields) or
     (FieldCount >= Budget.MaxObjects) then
    Exit(False);
C'est intentionnel et ça vaut le coup de l'intégrer avant de chercher un bouton qui n'existe pas. Un budget global de 4 000 000 d'objets n'accorde pas à un fichier XFDF 4 000 000 de champs, car 100000 champs est déjà très loin de tout ce qu'un vrai export d'annotations produit, et relever un plafond global ne devrait pas élargir en silence une vérification de cohérence spécifique au format. La normalisation de contenu fonctionne pareil dans l'autre sens : TPdfContentNormalizeOptions.Default part de ses propres limites par page puis les clampe chacune au snapshot, donc MaxTokensPerPage ne peut qu'être abaissé par le budget, jamais relevé. La politique globale resserre ; elle ne relâche jamais
Une mauvaise configuration échoue au moment où vous la configurez
ConfigurePdfParserResourceBudget valide avant d'assigner. Une valeur non positive dans l'une des six dimensions numériques lève immédiatement une exception, et un MaxDecodedBytes au-dessus de High(Integer) est rejeté comme dépassant les limites de plateforme plutôt que d'être tronqué en silence quelque part au fond d'un décodeur. Ça compte plus que ça n'en a l'air : un budget construit depuis un fichier de config avec une clé manquante vous donne des zéros, et un plafond d'objets à zéro accepté au démarrage se transforme en échec de parse mystifiant sur le premier document trois heures plus tard, au moment où personne ne suspecte la config. La même attention s'applique à tout code qui resserre le budget temporairement, y compris les tests. La politique est globale au processus, donc laisser une deadline de 4 secondes installée après la fin d'un fixture empoisonne tous les suivants ; sauvegardez et restaurez autour du changement
var
  Saved: TPdfParserResourceBudget;
begin
  Saved := GetPdfParserResourceBudget;
  try
    ApplyUntrustedIntakeBudget;
    ProcessInboundDocument(FileName);
  finally
    ConfigurePdfParserResourceBudget(Saved);
  end;
end;
ResetPdfParserResourceBudget est la version plus brutale, restaurant carrément TPdfParserResourceBudget.Default. Utilisez-la dans le teardown de test où vous voulez un état connu, et utilisez sauvegarde-et-restauration dans le code de production, où l'état auquel vous devez revenir est ce que l'application hôte a configuré au démarrage
Là où le budget cesse d'aider
C'est une politique unique globale au processus, et c'est sa principale limitation. Vous ne pouvez pas donner à un thread de travail un profil strict et à un autre un profil permissif, car il n'y a qu'un seul record derrière une seule section critique ; si vous avez vraiment besoin de limites par tenant, la forme qui marche est de sérialiser chaque classe de politique sur son propre processus, ou de borner le travail par sauvegarde-et-restauration en acceptant que la parenthèse ne soit sûre que quand rien d'autre ne parse en parallèle. Ça borne aussi le parsing, pas le rendu : la mémoire de rastérisation, la croissance du cache de polices et le décodage d'images se tiennent hors de ces sept dimensions et ont besoin de leurs propres contrôles. Et un budget vous dit qu'une opération était trop chère, jamais pourquoi. Le plafond qui a sauté est le symptôme, et le tableau /Index mal formé ou la chaîne de filtres incontrôlée derrière doit encore être diagnostiqué à la main, ce qui explique pourquoi le chemin de décodage décrit dans le décodage des object streams et des prédicteurs vaut le coup d'être compris avant de bouger des nombres. Traitez le budget comme la chose qui empêche un mauvais document d'emporter le processus avec lui, et gardez un logging assez bon pour découvrir ce que le document faisait
Toute la surface d'API du parseur, le record de budget et un build en code source pour Delphi, C++Builder et Lazarus sont sur la page produit : PDFium Component