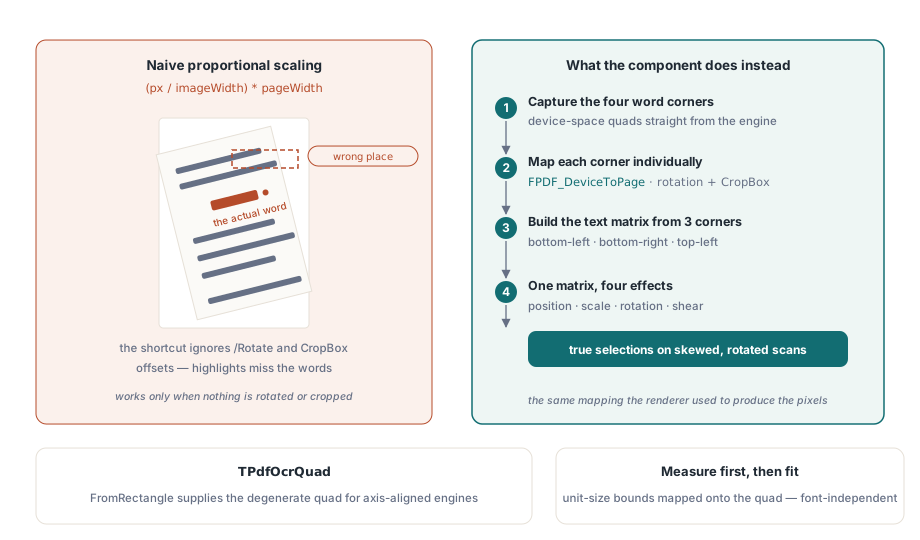
Une recherche de numéro de facture dans un PDF numérisé trouve bien le résultat, mais le surlignage se place un demi-pouce à gauche des chiffres imprimés et un demi-pouce en dessous. Un demi-pouce fait 36 points, et la page en question porte une CropBox de [36 36 576 756]. Celui qui a construit cette couche de texte a converti les positions pixels en positions page en divisant par la largeur du bitmap et en multipliant par la largeur de la page, ce qui suppose que la zone visible commence à l'origine. Sur une page qui porte /Rotate 90, la même formule fait pire : l'axe x du bitmap longe désormais l'axe y de la page, et les mots atterrissent dans une zone complètement erronée de la page
Ce qu'est réellement une couche de texte invisible
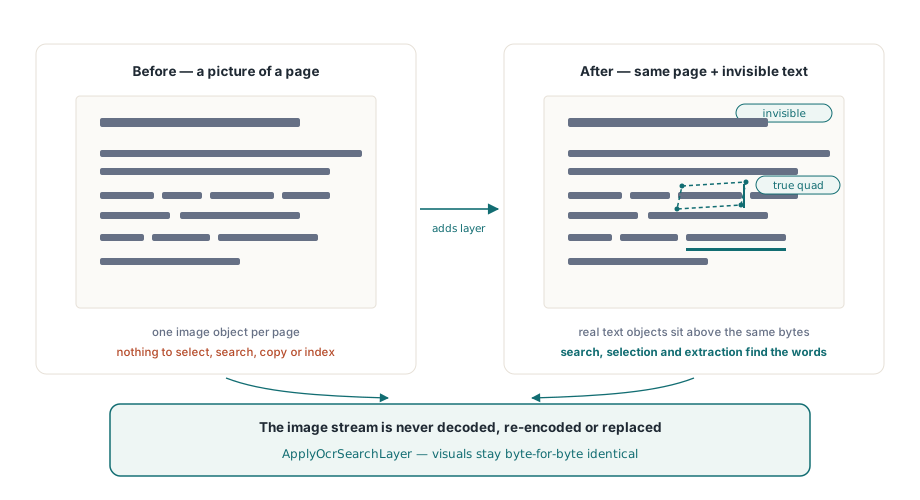
Une page numérisée est une seule grande image peinte par le flux de contenu. Rien à sélectionner, rechercher, copier ou indexer. Une couche de texte consultable ajoute des objets texte ordinaires par-dessus cette image et règle leur mode de rendu du texte sur 3, que ISO 32000-1 §9.3.6 (Table 106) définit comme ni remplissage ni contour : les glyphes existent pour la sélection, la recherche et l'extraction, et une visionneuse ne peint rien pour eux. Bien fait, le lecteur voit la numérisation d'origine et Ctrl+F trouve les mots exactement là où ils sont imprimés
Dans PDFium Component, tout le travail tient en un appel, TPdf.ApplyOcrSearchLayer. Il restitue chaque page sélectionnée, transmet les pixels à un fournisseur OCR, filtre les mots reconnus par confiance et réécrit les survivants sous forme d'objets texte invisibles. L'image de page reste telle quelle : la numérisation n'est ni décodée, ni réencodée, ni remplacée, donc une image JBIG2 ou CCITT G4 conserve exactement les octets compressés avec lesquels elle est arrivée. La méthode est livrée dans les éditions Small Business et Enterprise, le projet a donc besoin de Lib\SmallBusiness dans le chemin de recherche et de FPdfSmallBusiness dans une clause uses ; sans cette unité, l'appel lève EPdfSmallBusinessRequired
Écrire un IPdfOcrProvider
La reconnaissance elle-même se cache derrière une seule interface. IPdfOcrProvider.RecognizePage reçoit un TPdfOcrImage (numéro de page, largeur, hauteur, pas de ligne, DPI, format de pixel et un tampon TBytes de lignes BGRA à origine en haut), plus un jeton d'annulation, et renvoie un tableau d'enregistrements TPdfOcrWord : texte Unicode, une confiance entre 0 et 1, et un quadrilatère à quatre coins en pixels image. L'édition livre un fournisseur prêt à l'emploi, CreatePdfTesseractOcrProvider dans FPdfOcrTesseract, qui se lie à une bibliothèque Tesseract et à un répertoire traineddata que vous fournissez. Tout autre moteur, une API cloud ou un SDK commercial, se branche via une classe comme celle-ci :
uses
  System.SysUtils, PDFium, FPdfAsync, FPdfSmallBusiness;

type
  TMyOcrProvider = class(TInterfacedObject, IPdfOcrProvider)
  public
    function RecognizePage(const Image: TPdfOcrImage;
      const CancellationToken: IPdfCancellationToken;
      out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
  end;

function TMyOcrProvider.RecognizePage(const Image: TPdfOcrImage;
  const CancellationToken: IPdfCancellationToken;
  out Words: TPdfOcrWords; out ErrorMessage: string): Boolean;
var
  I, Count: Integer;
begin
  // Les routines Engine* ci-dessous représentent votre propre liaison au moteur OCR
  Count := EngineRecognize(Image.Pixels, Image.Width, Image.Height,
    Image.Stride, Image.Dpi);
  CancellationToken.ThrowIfCancelled;   // signaler une annulation comme une annulation

  SetLength(Words, Count);
  for I := 0 to Count - 1 do
  begin
    Words[I].Text := EngineWordText(I);
    // Bien des moteurs rapportent 0..100 ; la couche attend 0..1
    Words[I].Confidence := EngineWordConfidence(I) / 100;
    Words[I].Quad := TPdfOcrQuad.FromRectangle(
      EngineLeft(I), EngineTop(I), EngineRight(I), EngineBottom(I));
  end;
  ErrorMessage := '';
  Result := True;
end;
Un fournisseur qui laisse passer le 87.5 de Tesseract tel quel se fait rejeter chaque mot. Tesseract, entre autres, rapporte la confiance d'un mot en pourcentage, et l'adaptateur livré avec la divise avant de renvoyer ; un fournisseur maison doit faire pareil, car ApplyOcrSearchLayer traite une confiance supérieure à 1 comme une entrée invalide. Le symptôme ne se voit pas deux fois dès qu'on sait où regarder : Report.RejectedWordCount égale Report.DetectedWordCount et le fichier enregistré est dépourvu de tout texte
L'appel au jeton compte pour une autre raison. Si le fournisseur détecte l'annulation et se contente de renvoyer False, la page est enregistrée comme popsFailed avec le message que vous aurez mis. Appeler ThrowIfCancelled lève à la place EPdfOperationCancelled, que la couche intercepte et enregistre comme popsCancelled, avec Report.Cancelled positionné et la boucle arrêtée. Le jeton n'est jamais nil à l'intérieur d'un fournisseur ; quand l'appelant n'en passe pas, un jeton jamais annulé est fourni
Quadrilatères, et mots que la couche refuse
Les numérisations sont rarement carrées par rapport à la page, donc un mot sur une feuille légèrement inclinée occupe un parallélogramme. TPdfOcrQuad porte des points TopLeft, TopRight, BottomRight et BottomLeft précisément pour ce cas, et FromRectangle construit la version alignée sur les axes pour les moteurs qui ne rapportent que des boîtes. Un mot est écarté et compté dans RejectedWordCount quand son texte est vide ou plus long que MaxWordCharacters, quand sa confiance est NaN, inférieure à MinConfidence ou supérieure à 1, quand un coin tombe hors du bitmap, ou quand le quadrilatère se réduit à une baguette plus étroite que 0,01 pt après projection
Pourquoi le redimensionnement proportionnel déplace les mots OCR
Le redimensionnement proportionnel n'est correct que lorsque la page n'a pas d'entrée /Rotate et que sa CropBox commence à (0, 0). Bien des numérisations violent l'une de ces conditions : une feuille paysage est souvent stockée comme une page portrait avec /Rotate positionné, et les zones de recadrage se décalent quand quelqu'un rogne les marges dans un éditeur. L'exemple d'ouverture est l'échec bénin ; avec une rotation, l'erreur cesse d'être un décalage et devient un axe inversé
ApplyOcrSearchLayer fait passer chacun des quatre coins par FPDF_DeviceToPage, avec la même taille de bitmap et la même rotation que celles qui ont produit les pixels vus par le fournisseur. Rotation et décalages de CropBox sont donc pris en charge par la même transformation qu'a utilisée le moteur de rendu. Les coins sont arrondis au pixel entier en entrée, ce qui au DPI par défaut de 300 représente un pas de quantification de 0,24 pt, bien en dessous de tout ce qu'un surlignage de sélection peut montrer
À partir des points projetés, les coins bas-gauche, bas-droit et haut-gauche définissent une matrice affine. Trois points suffisent pour exprimer position, échelle, rotation et cisaillement, voilà pourquoi le quatrième coin n'est que validé, jamais utilisé pour l'ajustement. L'objet texte est créé avec une taille de police de 1, ses limites réelles sont mesurées, et la matrice projette ces limites mesurées sur le quadrilatère cible. Deviner une taille en points à partir de la hauteur du quadrilatère dériverait avec les ascendantes et descendantes de chaque police ; mesurer d'abord rend l'ajustement indépendant de la police que nomme Options.FontName
La police compte toujours pour l'extraction même si rien n'est dessiné. TPdfOcrOptions.Default la règle sur Arial. Si cette police ne peut pas être chargée, la couche retombe sur Helvetica standard, l'une des 14 polices standard, dont l'encodage intégré ne couvre que le texte latin. Pour une sortie en cyrillique, en grec ou en CJK, réglez FontName sur une police installée qui couvre l'écriture visée
Exécuter la couche et lire le rapport
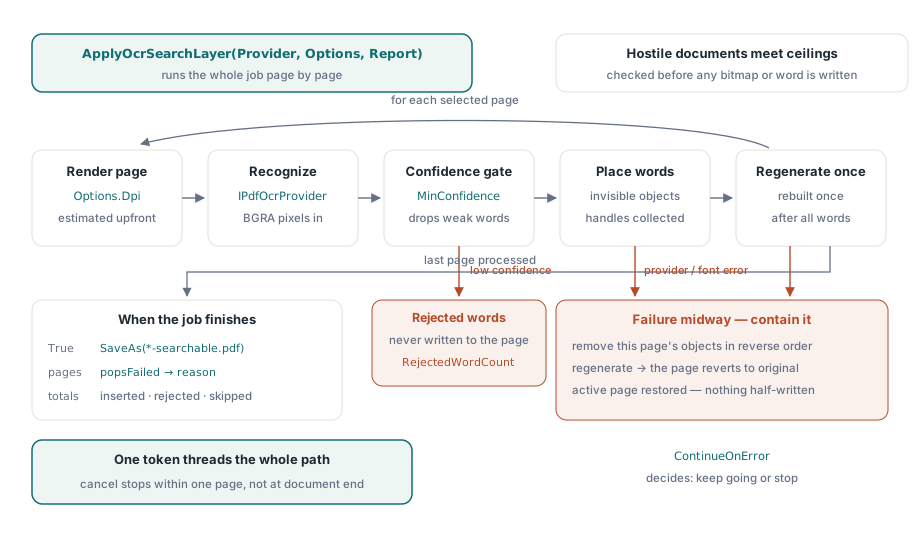
ApplyOcrSearchLayer ne renvoie True que si aucune page n'a échoué et si rien n'a été annulé. Cette valeur de retour est le mauvais critère pour décider d'enregistrer. Avec ContinueOnError laissé à sa valeur par défaut True, une tâche de 300 pages avec une page illisible renvoie False pendant que 299 pages portent une couche correcte, et la page en échec a déjà été remise en état. Basez plutôt l'enregistrement sur le rapport :
var
  Pdf: TPdf;
  Options: TPdfOcrOptions;
  Report: TPdfOcrReport;
  Cancel: IPdfCancellationTokenSource;
  I: Integer;
begin
  Cancel := TPdfCancellationTokenSource.New;  // gardez-le à portée d'un bouton Annuler
  Pdf := TPdf.Create(nil);
  try
    Pdf.FileName := 'scanned-contract.pdf';
    Pdf.LoadDocument;

    Options := TPdfOcrOptions.Default;      // 300 DPI, MinConfidence 0.5, Arial
    Options.MinConfidence := 0.6;
    Options.MaxTotalPixels := Int64(4000) * 1000 * 1000;

    Pdf.ApplyOcrSearchLayer(TMyOcrProvider.Create, Options, Report,
      Cancel.Token);

    for I := 0 to High(Report.Pages) do
      if Report.Pages[I].Status = popsFailed then
        Writeln(Format('page %d failed: %s',
          [Report.Pages[I].PageNumber, Report.Pages[I].ErrorMessage]));
    Writeln(Format('%d inserted, %d rejected, %d skipped, %d failed',
      [Report.InsertedWordCount, Report.RejectedWordCount,
       Report.SkippedPageCount, Report.FailedPageCount]));

    if not Report.Cancelled and (Report.InsertedWordCount > 0) then
      Pdf.SaveAs('scanned-contract-searchable.pdf');
  finally
    Pdf.Free;
  end;
end;
Ne pas enregistrer après une annulation est un choix de jugement, et c'est celui fait ici. Une tâche annulée laisse un fichier consultable sur la première partie et vide pour le reste, et rien dans le PDF n'indique au lecteur suivant où la couche s'arrête. Relancer tout le document plus tard coûte moins cher que d'expliquer une archive à moitié indexée
SkipPagesWithText vaut True par défaut et vérifie si la page produit déjà des caractères extractibles. Cela tient les pages nativement numériques à l'écart de l'OCR, évite une seconde couche sur les fichiers déjà traités, et rend un second passage sur la même sortie sans effet. La contrepartie, c'est qu'un seul vrai caractère suffit : une numérisation portant un numéro Bates tamponné en vrai texte est déclarée popsSkippedExistingText et ne reçoit pas de couche. Les archives construites ainsi ont besoin de SkipPagesWithText := False et d'une plage de pages choisie avec soin via FirstPage et LastPage, sinon les pages déjà traitées acquièrent une couche en doublon et l'extraction renvoie chaque mot deux fois
Budgets de pixels, annulation et rollback par page
Chaque quantité qu'un document malveillant ou simplement énorme peut gonfler a un plafond dans TPdfOcrOptions, et les vérifications de pixels s'exécutent avant toute allocation de bitmap. La taille de rendu vaut Ceil(PageWidth * Dpi / 72) par Ceil(PageHeight * Dpi / 72), donc on peut calculer les chiffres à l'avance :
| Page à 300 DPI | Bitmap | Pixels |
|---|---|---|
| Letter US, 612 × 792 pt | 2550 × 3300 | 8 415 000 |
| A4, 595 × 842 pt | 2480 × 3509 | 8 702 320 |
| A3, 842 × 1191 pt | 3509 × 4963 | 17 415 167 |
| A0, 2384 × 3370 pt | 9934 × 14042 | 139 493 228 |
Les défauts sont 100 millions de pixels par page et 1 milliard pour toute la tâche. Un plan A0 à 300 DPI dépasse donc MaxPixelsPerPage à lui seul. Le budget à l'échelle de la tâche s'épuise plus vite que celui par page : à 8 415 000 pixels par page Letter, 118 pages tiennent sous 1 milliard et la page 119 échoue avec un message nommant MaxTotalPixels, tout comme chaque page suivante. Pour de longues archives numérisées, montez MaxTotalPixels comme le fait l'exemple ci-dessus, ou découpez le travail en plages avec FirstPage et LastPage. Les pages écartées ne sont jamais restituées et ne comptent pas. L'adaptateur Tesseract livré avec ajoute sa propre limite, TPdfTesseractOptions.MaxPixels, à 16 777 216 par défaut ; une feuille A3 à 300 DPI dépasse juste cette valeur, donc les lots A3 exigent de monter la limite de l'adaptateur ou de baisser le DPI
Le DPI doit rester entre 36 et 1200. Le doubler de 300 à 600 quadruple le bitmap, et chaque pixel coûte 4 octets, donc une page Letter passe d'environ 34 MB de BGRA à environ 135 MB. Pour des numérisations de bureau ordinaires, 300 DPI équilibre qualité de reconnaissance et mémoire ; 600 se justifie pour les petits caractères et les notes de bas de page, pas pour des archives entières. Les compteurs de mots sont plafonnés par MaxWordsPerPage et MaxTotalWords, et un fournisseur qui renvoie plus de mots que la page n'en autorise fait échouer la page au lieu d'être tronqué
Le jeton d'annulation atteint le rendu progressif, l'appel au fournisseur et la boucle qui insère les mots. Annuler pendant la reconnaissance de la page 212 d'un fichier de 400 pages s'arrête à la page 212, à condition que le fournisseur honore le jeton qu'on lui a passé. L'adaptateur Tesseract va plus loin et enregistre un callback d'annulation auprès du moteur, avec un délai par page de 60 000 ms par défaut
Le confinement est par page. La couche garde le handle de chaque objet texte qu'elle insère et appelle FPDFPage_GenerateContent une seule fois, après placement du dernier mot de la page. Si quelque chose échoue entre-temps, une police qui refuse un caractère ou une annulation qui arrive en pleine boucle, les objets déjà insérés sur cette page sont retirés en ordre inverse et le contenu de la page est régénéré, si bien que la page ne porte plus que ce qu'elle avait avant. La boucle continue ou s'arrête ensuite selon ContinueOnError, et la page active avant l'appel est de nouveau active après
Vérifier le résultat
Deux vérifications couvrent l'essentiel de ce qui peut mal tourner. La première est visuelle : restituez une page du fichier d'origine et la même page du fichier traité à la même taille avec TPdf.RenderPage, puis comparez les bitmaps. Résultat attendu : identiques, car le mode 3 ne peint rien et le flux d'image n'a pas été touché ; toute différence de pixel signifie qu'autre chose que la couche de texte a modifié la page. La seconde vérifie que les mots existent et se tiennent là où la numérisation les montre :
procedure CheckOcrPage(Pdf: TPdf; PageNo: Integer; const Probe: WString);
const
  TEXT_MODE_INVISIBLE = 3;   // FPDF_TEXTRENDERMODE_INVISIBLE
var
  TextObjects: TPdfIntegerArray;
  I, Invisible, Hit: Integer;
  Box: TPdfRectangle;
begin
  Pdf.PageNumber := PageNo;
  TextObjects := Pdf.GetObjectsByType(otText);
  Invisible := 0;
  for I := 0 to High(TextObjects) do
    if Pdf.GetTextRenderMode(TextObjects[I]) = TEXT_MODE_INVISIBLE then
      Inc(Invisible);
  Writeln(Format('page %d: %d invisible text objects', [PageNo, Invisible]));

  Hit := Pdf.FindFirst(Probe);
  if Hit >= 0 then
  begin
    Box := Pdf.CharacterRectangle[Hit];
    Writeln(Format('"%s" starts at x=%.1f, y=%.1f pt',
      [Probe, Box.Left, Box.Bottom]));
  end;
end;
Choisissez un mot sonde que vous pouvez repérer à l'œil sur la numérisation, un titre ou un total, et comparez les coordonnées rapportées avec sa position dans une image restituée. Sur la page à CropBox de l'ouverture, la valeur x doit commencer à 36 ou plus, jamais près de zéro. L'extraction est approfondie dans l'extraction de texte à partir de documents PDF, la restitution de pages pour une superposition d'alignement dans la conversion de pages PDF en JPEG, et le schéma de jeton utilisé partout dans le rendu progressif annulable
La superposition OCR côtoie rendu, extraction de texte et édition de pages sur le même objet TPdf, en Delphi, C++Builder et Lazarus. Éditions et liste complète de l'API sont sur la page produit PDFium Component pour Delphi