Le même code source Object Pascal peut se comporter différemment sous Delphi et FPC/Lazarus de quatre manières qui affectent régulièrement le code du composant PDFium : FPC libère les enregistrements temporaires renvoyés par les fonctions avant qu'un test d'appartenance in n'ait fini de les lire, dcc32 est configuré par défaut sans vérification des limites de sorte que les index de tableaux hors limites lisent silencieusement des données erronées, seul Delphi 13 accepte l'affectation d'un array of Byte anonyme à un TBytes sans transtypage (cast), et la concaténation d'AnsiString sous Delphi peut altérer les octets égaux ou supérieurs à $80 en raison d'une conversion de page de codes masquée. Chacun de ces pièges produit des résultats de tests corrects sous un compilateur et incorrects — ou pire, silencieusement faux — sous l'autre
Si vous configurez un projet pour deux compilateurs pour la première fois, notre présentation du lecteur Lazarus et FPC décrit le cas idéal : les packages, les chemins de recherche et l'affichage d'une fenêtre de rendu. Cet article prend le contre-pied d'un tutoriel. Il liste les difficultés rencontrées après le succès des premières étapes, lorsque l'intégration continue (CI) passait sous FPC, passait sous Delphi, puis qu'une modification acceptée d'un côté provoquait un plantage de l'autre. Chaque piège ci-dessous provient d'un échec réel rencontré dans la suite de tests de PDFiumPas ou ses démonstrations, résumé ici avec une reproduction minimale, sa cause première et la correction standard adoptée
Pourquoi un ensemble est-il lu comme vide sous FPC mais pas sous Delphi ?
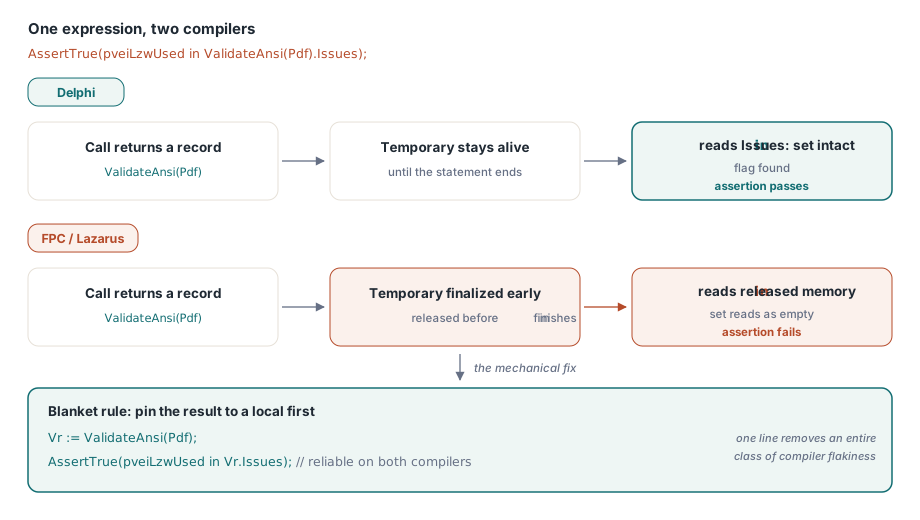
En résumé : FPC peut finaliser la variable temporaire contenant l'enregistrement renvoyé par une fonction avant la fin de l'expression qui lit un champ de ce résultat, de sorte que l'expression X in Func().Issues teste l'appartenance par rapport à un ensemble déjà libéré, tandis que l'expression équivalente sous Delphi fonctionne correctement. Nos tests de conformité PDF/E ont rencontré ce problème dès leur première version. Le validateur renvoie un enregistrement dont le champ Issues est un ensemble de drapeaux d'anomalies, et les assertions appelaient la fonction en ligne (inlined)
// Peu fiable sous FPC : l'enregistrement temporaire de résultat de fonction
// peut être libéré avant que le test 'in' ne lise Issues
AssertTrue(pveiLzwUsed in ValidateAnsi(Pdf).Issues);

// Fiable sur les deux compilateurs : épinglez d'abord le résultat dans une variable locale
var
  Vr: TPdfEValidationResult;
begin
  Vr := ValidateAnsi(Pdf);
  AssertTrue(pveiLzwUsed in Vr.Issues);
end;
La forme en ligne (inlined) lisait l'ensemble comme vide sous FPC, ce qui faisait échouer chaque assertion attendant un drapeau, tandis que la build Delphi identique passait avec succès. La cause première réside dans la manière dont les deux compilateurs gèrent la durée de vie des variables temporaires de résultats de fonctions au sein d'expressions plus larges : Delphi maintient la variable temporaire active jusqu'à la fin de l'instruction, tandis que FPC peut libérer l'enregistrement temporaire alors que l'opérateur d'appartenance à l'ensemble est encore en cours de lecture. Nous avions déjà documenté ce même comportement une fois auparavant dans un commentaire de la routine FlagPresent du module de test PDF/A, puis nous avons réintroduit le bogue en écrivant de nouveaux tests à partir de zéro, ce qui montre à quel point la forme incorrecte semble naturelle. La correction est systématique et mérite d'être généralisée : ne chaînez jamais un accès à un champ ou un test d'ensemble directement sur un appel de fonction qui renvoie un enregistrement ; affectez d'abord le résultat à une variable locale, puis lisez le champ. Cela ne coûte qu'une ligne de code et élimine toute une catégorie d'instabilités dépendantes du compilateur
Pourquoi Delphi accepte-t-il un index de tableau que FPC refuse de compiler ?
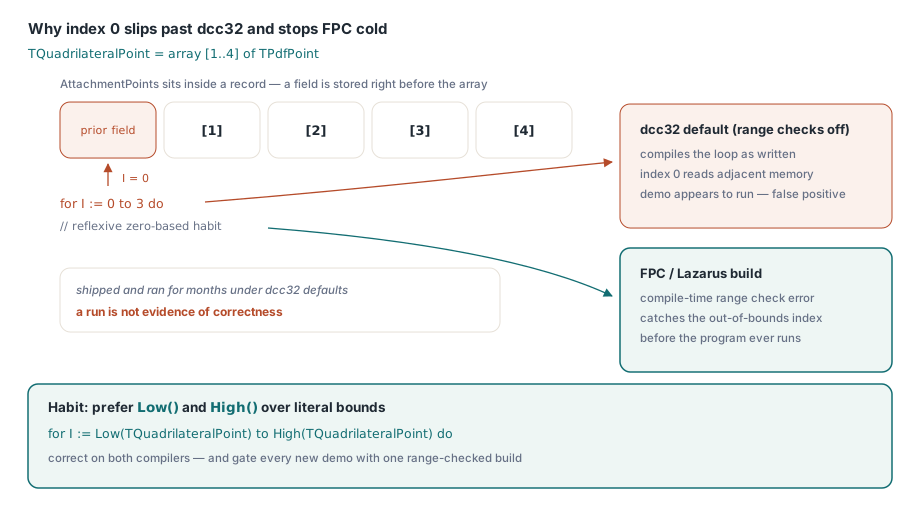
En résumé : dcc32 compile un index hors limites dans un tableau de taille fixe et, la vérification des limites étant désactivée par défaut, lit ou écrit silencieusement dans la mémoire adjacente à l'exécution, tandis que FPC rejette ce même index dès la compilation. Le composant PDFium déclare les points des quadrilatères sous forme d'un tableau indexé à partir de 1, TQuadrilateralPoint = array [1..4] of TPdfPoint, conformément à la numérotation habituelle des entrées QuadPoints des PDF. Une démonstration qui le remplissait via une boucle classique indexée à partir de 0 a fonctionné pendant des mois sous Delphi
var
  I: Integer;
begin
  for I := 0 to 3 do                       // erroné : le tableau est [1..4]
    Data.AttachmentPoints[I] := Corner[I]; // dcc32 par défaut : compile, index 0
                                           // touche silencieusement la mémoire adjacente
                                           // FPC : erreur de vérification de plage à la compilation
  for I := Low(TQuadrilateralPoint) to High(TQuadrilateralPoint) do
    Data.AttachmentPoints[I] := Corner[I - 1];  // correct sur les deux compilateurs
end;
La build Delphi fournissait un faux positif : la vérification des limites étant désactivée (la configuration dcc32 par défaut), l'index 0 ciblait le champ qui précède le tableau dans l'enregistrement, et la démonstration semblait fonctionner. Le portage de cette même démonstration vers Lazarus a immédiatement généré une erreur de vérification de limites à la compilation sous FPC. La correction de l'index a ensuite mis au jour un second bogue plus profond dans la logique d'annotation de la bibliothèque que ces lectures incorrectes masquaient, bogue analysé dans l'article sur les annotations par QuadPoints. Deux leçons se dégagent de cet incident. Premièrement, préférez Low() and High() aux limites littérales chaque fois que le type de tableau n'est pas indexé à partir de 0 par conception. Deuxièmement, considérez une compilation FPC, ou au minimum une build Delphi avec l'option {$R+} activée, comme une étape obligatoire avant de valider toute nouvelle démonstration ou test : les réglages par défaut de dcc32 ne vous signaleront pas ce genre de bogue, et un programme qui s'exécute sans planter ne prouve pas qu'il est correct
L'affectation de TBytes acceptée uniquement par Delphi 13
En résumé : affecter un champ déclaré sous la forme d'un array of Byte anonyme à une variable TBytes compile sous Delphi 13 (version de compilateur 37.0) mais échoue sous Delphi 12 Athens et toutes les versions antérieures avec le message E2010 Incompatible types: 'TArray<Byte>' and 'Dynamic array'. Il ne s'agit pas ici d'une divergence entre Delphi et FPC, mais plutôt d'une divergence entre Delphi et ses versions précédentes, qui affecte le code multi-compilateur de la même manière : le compilateur le plus récent accepte silencieusement une syntaxe que toutes les versions antérieures rejettent
type
  TValidator = class
  private
    FBuffer: array of Byte;   // type de tableau dynamique anonyme
  end;

var
  OrigBytes: TBytes;
begin
  OrigBytes := FBuffer;          // uniquement Delphi 13 ; E2010 sur Delphi 12
                                 // Athens et versions antérieures
  OrigBytes := TBytes(FBuffer);  // compile partout ; même disposition d'octets,
                                 // transtypage direct sûr
end;
Nous avions intégré cette affectation exacte dans une routine de validation développée et testée localement sous Delphi 13, où la conversion implicite était acceptée sans problème. Cependant, le programme d'installation contenant le code source est utilisé par de nombreux clients sous Delphi 12 et versions antérieures, pour lesquels l'unité ne compilait tout simplement pas. La correction structurelle consiste soit à utiliser le transtypage direct (hard cast) présenté ci-dessus (sûr puisque les array of Byte anonymes et les TBytes partagent la même structure de tableau dynamique), soit, de préférence, à déclarer le champ avec le type nommé TBytes dès le départ pour éviter toute conversion. La correction au niveau de la méthodologie est plus importante encore : une syntaxe qui compile sur votre chaîne d'outils la plus récente ne garantit en rien la compatibilité avec les compilateurs antérieurs qu'utilisent vos clients, et cette catégorie de régression reste invisible tant que vous ne compilez pas sur toutes les versions cibles. Nos scripts de publication compilent désormais la bibliothèque sur l'ensemble de la matrice de compilateurs précisément parce qu'une build 37.0 locale ne peut pas détecter les tolérances propres à la version 13
L'octet d'AnsiString qui disparaît sur une machine Windows chinoise
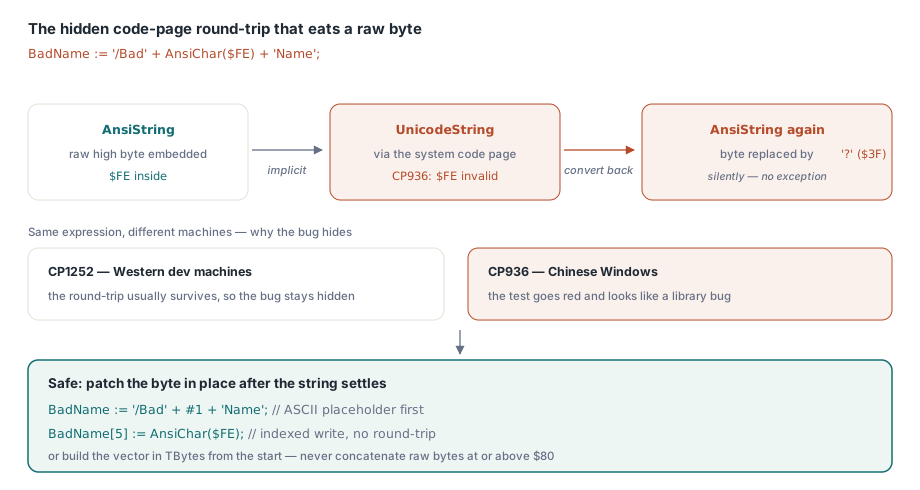
En résumé : concaténer un octet brut égal ou supérieur à $80 dans une chaîne AnsiString avec l'opérateur + peut silencieusement remplacer cet octet par le caractère ? ($3F) sous Delphi, car l'expression subit une conversion implicite d'AnsiString vers UnicodeString puis à nouveau vers AnsiString via la page de codes du système. Nous avons découvert cela lors d'un test PDF/A qui construisait un nom contenant un octet $FE isolé (qui n'est jamais un octet d'en-tête UTF-8 valide), afin de vérifier que le validateur signale bien les noms non conformes à l'UTF-8 selon la norme ISO 19005-2 clause 6.1.8
var
  BadName: AnsiString;
begin
  // Sous Delphi avec une page de codes système multi-octets (observé sur CP936),
  // la concaténation passe par UnicodeString et $FE, qui
  // n'étant pas une séquence CP936 valide, revient sous la forme '?' ($3F)
  BadName := '/Bad' + AnsiChar($FE) + 'Name';

  // Sûr : construisez avec un espace réservé ASCII, puis corrigez l'octet en place ;
  // une affectation indexée dans une AnsiString établie ne fait pas d'aller-retour
  BadName := '/Bad' + #1 + 'Name';
  BadName[5] := AnsiChar($FE);
end;
Sur un système Windows chinois configuré avec la page de codes 936, la chaîne concaténée ne contenait jamais l'octet $FE, de sorte que la bibliothèque ne signalait rien et le test échouait alors que le code de la bibliothèque était correct. Le problème ne venait pas de la bibliothèque : un test sous FPC injectant un fichier PDF contenant réellement l'octet $FE renvoyait bien l'anomalie attendue. La corruption se produisait au sein de l'exécutable de test sous Delphi lors de l'évaluation de la concaténation de chaînes, car le modèle de chaîne Unicode par défaut de Delphi convertit les expressions AnsiString mixtes via UnicodeString, et l'octet $FE n'étant pas valide dans la page CP936, la conversion le remplace. Soyons lucides sur les conditions de ce problème : sur une page de codes occidentale à un octet comme la CP1252, la concaténation survit généralement, ce qui explique pourquoi ce bogue reste invisible sur la plupart des postes de développement pour n'apparaître que sur des systèmes d'Asie de l'Est ou des agents d'intégration continue localisés. La règle que nous avons adoptée : ne construisez jamais de vecteurs de test binaires contenant des octets égaux ou supérieurs à $80 par concaténation d'AnsiString ; modifiez les octets directement après que la chaîne a été définie, comme ci-dessus, ou construisez le vecteur dans un tableau TBytes dès le départ
Ce qu'un flux de travail à double compilateur doit vérifier par défaut
Quatre pièges, un seul constat : chaque compilateur met en évidence une fraction différente de vos bogues. L'analyse des limites à la compilation de FPC a détecté un index hors limites que dcc32 laissait s'exécuter silencieusement depuis des mois, et le modèle de chaîne Unicode de dcc32 a révélé une dépendance à la page de codes qu'une build FPC purement orientée octets ne déclenchait pas. En pratique, cela signifie qu'aucun des deux pipelines au vert ne suffit à lui seul. La compilation croisée n'est pas une simple exigence de portabilité, c'est un second analyseur statique et un second modèle d'exécution appliqués au même code source, dans l'esprit des vérifications défensives décrites dans l'article sur le renforcement de l'ABI et de la sécurité de la mémoire
Les règles issues de ces incidents sont simples à retenir. Affectez les enregistrements de résultats de fonctions à une variable locale avant de lire leurs champs. Parcourez les tableaux de taille fixe à l'aide de Low() et High(), et validez le code par une build FPC ou une vérification des limites avant d'approuver une nouvelle démonstration. Transtypez explicitement les champs de tableaux dynamiques anonymes, ou déclarez-les avec des types nommés, et validez la matrice de compilation complète avant la publication. Enfin, bannissez les octets bruts élevés de toute concaténation d'AnsiString. Aucune de ces règles ne demande d'effort particulier une fois passée en habitude, et chacune élimine un mode d'échec qu'un projet utilisant un seul compilateur ne peut pas détecter
Ces quatre problèmes ont été identifiés et corrigés dans le cadre de la maintenance du composant PDFium Component, qui propose le même code source Object Pascal pour Delphi, C++Builder et FPC/Lazarus et exécute ses suites de tests de conformité et de régression sur chacun de ces outils, garantissant que ces pièges sont surveillés par des tests plutôt que par de simples consignes