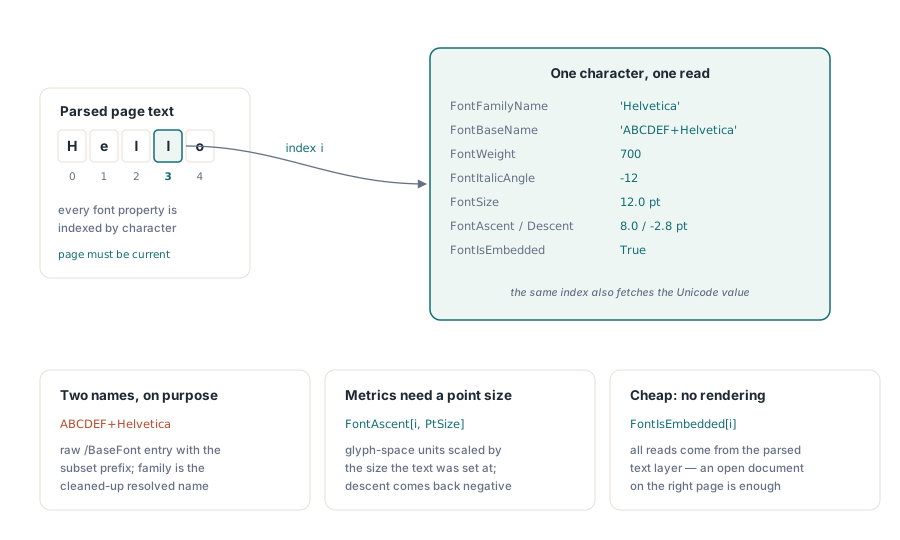
Chaque caractère visible dans un PDF porte une référence à la police qui l'a dessiné, et PDFium Component vous laisse remonter cette référence jusqu'à l'objet police pour lire ce qu'il sait. L'unité d'accès est le caractère, pas le document : vous choisissez un caractère par son index dans le texte de la page et vous demandez le nom de famille, le nom de base, la graisse, l'angle italique et si la fonte sous-jacente est réellement transportée dans le fichier. Cette dernière propriété est celle que visent vraiment la plupart des analyses, car une police incorporée voyage avec le document tandis qu'une police non incorporée est un pari sur le fait que la machine du lecteur possède justement la même typographie installée
Le composant les expose via les mêmes objets TPdf et TPdfView que vous utilisez pour le rendu et l'extraction de texte. Il n'y a pas d'objet « table des polices » distinct à ouvrir. Une fois le texte d'une page analysé, les propriétés de police pendent à l'index de caractère, et vous les lisez un glyphe à la fois. Cette conception colle à la façon dont le PDF stocke l'information à la base : une seule page peut changer de police des dizaines de fois, et la seule réponse honnête à « dans quelle police est ce document » reste « cela dépend du caractère dont vous parlez »
Lire la police derrière un caractère
La plus petite opération utile consiste à prendre un index de caractère et à déverser tout ce que PDFium peut vous dire de sa police. Chaque propriété de police sur TPdf et TPdfView est indexée par position de caractère, si bien que l'index traverse toutes ces propriétés. La page doit aussi être la page courante pour que l'index se résolve sur le bon texte, ce qui compte dès que vous dépassez la page une
procedure DescribeFontAt(Pdf: TPdf; CharIndex: Integer);
var
  Report: TStringList;
  PtSize: Single;
begin
  Report := TStringList.Create;
  try
    PtSize := Pdf.FontSize[CharIndex];

    Report.Add('Character : ' + Pdf.Character[CharIndex]);
    Report.Add('Family    : ' + Pdf.FontFamilyName[CharIndex]);
    Report.Add('Base name : ' + Pdf.FontBaseName[CharIndex]);
    Report.Add('Weight    : ' + IntToStr(Pdf.FontWeight[CharIndex]));
    Report.Add('Italic    : ' + IntToStr(Pdf.FontItalicAngle[CharIndex]) + ' deg');
    Report.Add('Size      : ' + FormatFloat('0.0', PtSize) + ' pt');
    Report.Add('Ascent    : ' + FormatFloat('0.0', Pdf.FontAscent[CharIndex, PtSize]));
    Report.Add('Descent   : ' + FormatFloat('0.0', Pdf.FontDescent[CharIndex, PtSize]));
    Report.Add('Embedded  : ' + BoolToStr(Pdf.FontIsEmbedded[CharIndex], True));

    ShowMessage(Report.Text);
  finally
    Report.Free;
  end;
end;
Deux des signatures surprennent ceux qui viennent d'autres bibliothèques. FontAscent et FontDescent prennent deux arguments, l'index de caractère et une taille en points, parce que PDFium rapporte ces métriques en unités d'espace de glyphe qui ne deviennent des pixels qu'une fois mises à l'échelle par la taille à laquelle le texte a été composé. Passez la valeur que vous avez déjà lue dans FontSize[CharIndex] et vous obtenez l'ascendante et la descendante dans les mêmes points que le reste de la mise en page. La descendante revient négative, puisqu'elle mesure sous la ligne de base. Le nom de famille et le nom de base sont deux chaînes distinctes à dessein : le nom de base est l'entrée /BaseFont brute du PDF, portant souvent un préfixe de sous-ensemble comme ABCDEF+, tandis que le nom de famille est le nom nettoyé auquel le moteur de rendu le résout
Transformer un clic en index de caractère
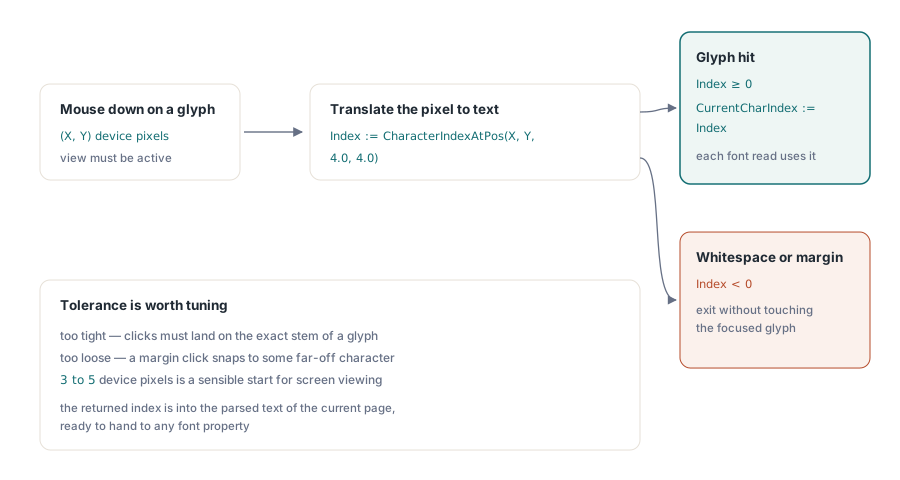
Dans un visualiseur, vous connaissez rarement l'index d'avance. L'utilisateur clique sur un glyphe et vous devez traduire la coordonnée en pixels vers le caractère qui se trouve dessous. CharacterIndexAtPos fait exactement cela : il prend la position de la souris et une tolérance, et renvoie l'index du caractère le plus proche, ou une valeur négative quand le clic est tombé sur du blanc ou sur une page vide
procedure TfrmMain.PdfViewMouseDown(Sender: TObject; Button: TMouseButton;
  Shift: TShiftState; X, Y: Integer);
var
  Index: Integer;
begin
  if not PdfView.Active then
    Exit;

  // 4 px de jeu dans chaque direction pour qu'un clic un peu à côté touche quand même le glyphe.
  Index := PdfView.CharacterIndexAtPos(X, Y, 4.0, 4.0);
  if Index < 0 then
    Exit;                      // clic entre deux glyphes ; laisser le panneau tranquille

  PdfView.CurrentCharIndex := Index;
  DescribeFontAt(PdfView.Pdf, Index);
end;
La tolérance mérite d'être réglée. Trop serrée, les utilisateurs ont l'impression de devoir viser le fût exact d'une lettre ; trop lâche, un clic dans une marge accroche un caractère lointain qui n'a rien à voir avec ce qu'ils visaient. Trois à cinq pixels d'écran forment un point de départ raisonnable pour la consultation à l'écran. L'index renvoyé porte sur le texte analysé de la page courante, le même espace d'index qu'attend chaque propriété de police : vous pouvez donc le passer directement à la routine ci-dessus. Le stocker dans CurrentCharIndex est facultatif mais commode : la vue le garde comme sa notion de glyphe actif, ce qui est pratique si d'autres parties de l'interface veulent lire la sélection sans la redériver
L'incorporation est la propriété qui compte
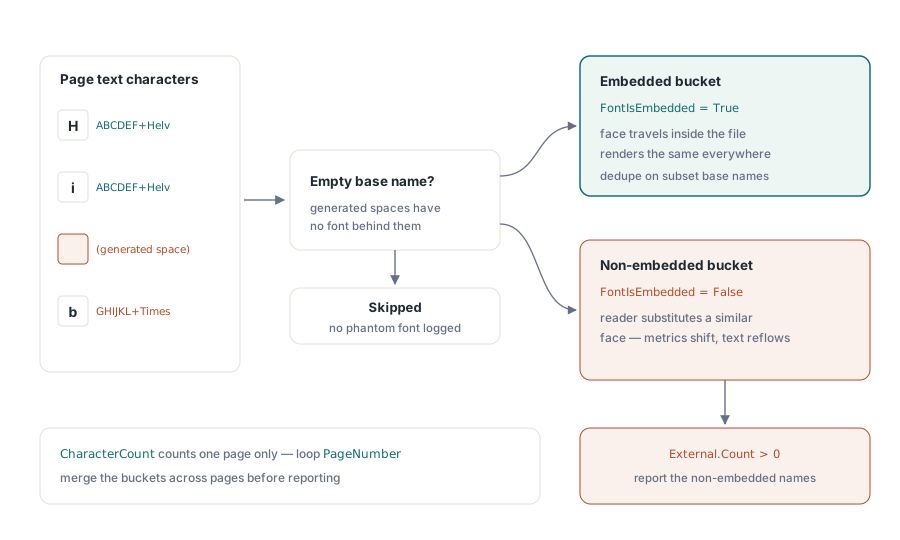
Pour la plupart des travaux réels, la seule question qui vaut d'être tranchée est de savoir si chaque police est incorporée. Un document dont toutes les polices voyagent à l'intérieur se rend de la même façon sur le RIP d'un imprimeur, sur le portable d'un collègue et sur un serveur dépourvu d'interface graphique. Un document qui s'appuie sur un Helvetica non incorporé parie que chacune de ces machines dispose d'une fonte correspondante, et quand le pari échoue, le lecteur substitue quelque chose d'approchant, les métriques bougent, et un formulaire soigneusement mis en page se réagence juste assez pour casser. Parcourir le texte de la page et ranger les polices par statut d'incorporation vous donne cette réponse à peu de frais
procedure ReportNonEmbeddedFonts(Pdf: TPdf);
var
  Embedded, External: TStringList;
  I: Integer;
  Name: string;
begin
  Embedded := TStringList.Create;
  External := TStringList.Create;
  try
    Embedded.Sorted := True;
    Embedded.Duplicates := dupIgnore;
    External.Sorted := True;
    External.Duplicates := dupIgnore;

    for I := 0 to Pdf.CharacterCount - 1 do
    begin
      Name := Pdf.FontBaseName[I];
      if Name = '' then
        Continue;              // les espaces générés et assimilés n'ont pas de police
      if Pdf.FontIsEmbedded[I] then
        Embedded.Add(Name)
      else
        External.Add(Name);
    end;

    if External.Count > 0 then
      ShowMessage(IntToStr(External.Count) +
        ' non-embedded font(s):' + sLineBreak + External.Text)
    else
      ShowMessage('All ' + IntToStr(Embedded.Count) +
        ' font(s) on this page are embedded.');
  finally
    Embedded.Free;
    External.Free;
  end;
end;
Deux détails gardent cela honnête. D'abord, CharacterCount vaut par page : un audit de tout le document suppose donc de positionner Pdf.PageNumber sur chaque page à tour de rôle et de relancer la boucle, puis de fusionner les résultats. Ensuite, la couche de texte contient des caractères générés, comme les espaces qu'un lecteur infère entre les mots, et ceux-ci n'ont aucun objet police derrière eux ; le contrôle du nom de base vide les saute au lieu de consigner un fantôme. Le nom de base est ici la bonne clé de déduplication, car le préfixe de sous-ensemble qu'il porte distingue deux sous-ensembles différents d'une même famille, ce qui est en général ce que vous voulez savoir
Extraire la fonte incorporée
Quand une police est incorporée, vous pouvez lire ses octets directement. FontData renvoie le programme de police brut, les mêmes données TrueType ou CFF que le PDF transporte, ce qui suffit à écrire un fichier de police autonome ou à établir une empreinte de la fonte face à une bibliothèque connue. Il renvoie un tableau vide quand la police n'est pas incorporée, si bien que le contrôle d'incorporation et le contrôle de longueur protègent ensemble l'écriture
procedure SaveEmbeddedFont(Pdf: TPdf; CharIndex: Integer;
  const OutputFile: string);
var
  Data: TBytes;
  Stream: TFileStream;
begin
  if not Pdf.FontIsEmbedded[CharIndex] then
  begin
    ShowMessage('That glyph''s font is not embedded; nothing to extract.');
    Exit;
  end;

  Data := Pdf.FontData[CharIndex];
  if Length(Data) = 0 then
    Exit;

  Stream := TFileStream.Create(OutputFile, fmCreate);
  try
    Stream.WriteBuffer(Data[0], Length(Data));
  finally
    Stream.Free;
  end;
  ShowMessage('Wrote ' + IntToStr(Length(Data)) + ' bytes.');
end;
Les octets sont le sous-ensemble incorporé, pas la police commerciale d'origine : ce que vous récupérez ne couvre donc en général que les glyphes que le document a réellement utilisés. C'est exactement ce qu'il faut pour l'expertise et la vérification, et cela convient mal à la réutilisation ; un sous-ensemble de Times New Roman contenant trente glyphes n'est pas une police que vous pouvez installer et utiliser pour saisir du texte. Traitez l'extraction comme un moyen d'inspecter ce qui a été livré, pas comme un outil de récupération de polices. S'il vous faut le nom de base correspondant pour étiqueter la sortie, lisez FontBaseName[CharIndex] à côté des données, et retirez la balise de sous-ensemble en tête si vous voulez la famille nue
Donner du sens au nombre de graisse
FontWeight renvoie la classe de graisse numérique, la même échelle de 100 à 900 que celle employée par CSS, où 400 est le romain et 700 le gras. PDFium rapporte ce que la police déclare, ce qui n'est pas toujours une centaine ronde : une fonte peut annoncer 350 ou 650, et traiter tout ce qui vaut 600 ou plus comme « assez gras pour compter » tient mieux la route que tester exactement 700. L'angle italique est un signal compagnon : une valeur non nulle, en général négative, signifie que la fonte est un dessin oblique ou un vrai italique, et zéro signifie droit. Ensemble, ils permettent de distinguer une plage en gras italique d'une plage normale sans rien rendre, ce qui est le genre de contrôle qu'une passe de préflight ou un audit d'accessibilité veut mener en masse
Aucune de ces lectures ne demande une image rendue. Elles viennent de la couche de texte analysée : un document ouvert sur la bonne page est donc tout le montage nécessaire, ce qui rend l'inspection des polices bon marché à exécuter sur toute une archive. Si vous associez cela à l'extraction de texte, les mêmes index de caractères correspondent au texte que vous sortez, si bien que la police d'un glyphe et sa valeur Unicode sont deux lectures sur un même index. L'article compagnon sur l'extraction de texte des documents PDF avec PDFium Component couvre ce côté de la couche de texte plus en profondeur
Les propriétés de police présentées ici font partie du composant VCL PDFium pour Delphi