Le dictionnaire Catalog d'un PDF n'a exactement qu'une seule clé de navigation obligatoire : /Pages. Cette clé doit pointer vers un objet indirect de type /Pages, qui à son tour contient le tableau /Kids et le /Count total de pages. Retirez ce pointeur et aucun lecteur conforme ne peut localiser la moindre page dans le fichier. L'ISO 32000-1 §7.7.2 est formelle sur ce point : le Catalog doit avoir une entrée /Pages, et l'objet référencé doit être de type /Pages. Les fichiers qui violent cette exigence ne se contentent pas d'être non conformes ; ils sont structurellement cassés d'une manière que la plupart des analyseurs gèrent mal
Ce que stipule réellement la spécification
Un PDF conforme minimal compte au moins trois objets. L'objet 1 est le Catalog, l'objet 2 est la racine Pages, et à partir de l'objet 3 viennent les dictionnaires Page individuels. Le Catalog pointe vers la racine Pages ; la racine Pages liste ses enfants dans /Kids ; chaque Page porte une référence inverse /Parent. Toute la chaîne est bidirectionnelle par conception, si bien qu'un analyseur peut partir de l'un ou l'autre bout et atteindre n'importe quelle page en O(log n) pour les arbres équilibrés
% Structure conforme minimale (ISO 32000-1 §7.7.2)
1 0 obj
<< /Type /Catalog /Pages 2 0 R >>
endobj

2 0 obj
<< /Type /Pages /Kids [3 0 R 4 0 R] /Count 2 >>
endobj

3 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 5 0 R /Resources << >> >>
endobj

4 0 obj
<< /Type /Page /Parent 2 0 R /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
L'arbre des pages peut être imbriqué. Un document contenant des milliers de pages regroupe généralement ses pages dans des objets nœuds intermédiaires, qui portent également le type /Pages, chacun possédant son propre tableau /Kids et un /Count reflétant son sous-arbre. Le /Count du nœud racine est toujours égal au nombre total de pages du document. Ce total est la valeur que le lecteur affiche dans la barre de numéro de page avant même d'analyser la moindre page, car lire un entier depuis l'objet 2 est bien plus rapide que de parcourir tout l'arbre
À quoi ressemble un fichier sans dictionnaire Pages
Les fichiers dépourvus du dictionnaire Pages proviennent typiquement de générateurs PDF qui écrivent les objets Page directement sans les assembler en arbre, ou d'une corruption qui retire le nœud racine en laissant intacts les objets Page feuilles. Dans un tel fichier, le Catalog n'a soit pas du tout de clé /Pages, soit une référence vers un objet qui n'existe plus dans la table des références croisées
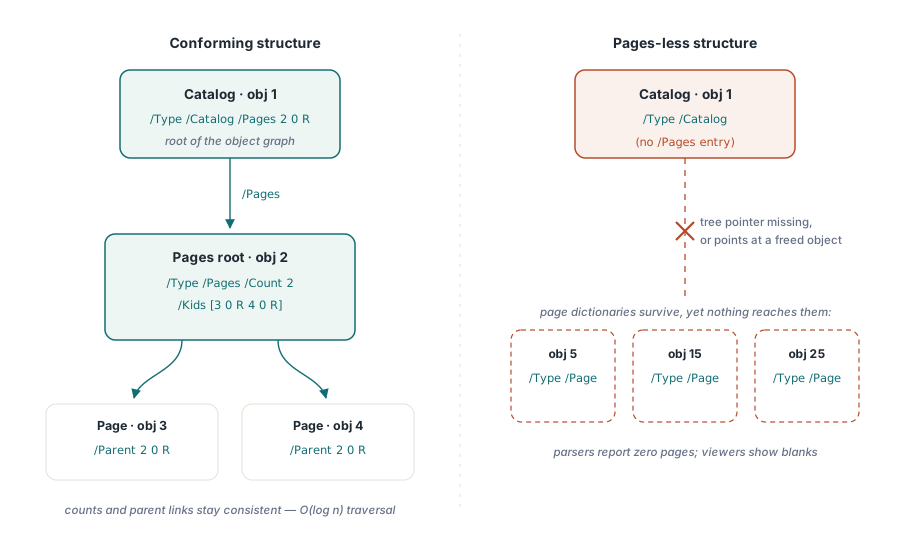
/Pages, tandis qu'un fichier sans Pages abandonne des objets de pages intacts sans entrée navigable depuis le Catalog% Non conforme : Catalog sans référence /Pages
1 0 obj
<< /Type /Catalog >>
endobj
% Les objets Page existent mais sont inatteignables depuis le Catalog
5 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 6 0 R /Resources << >> >>
endobj
15 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 16 0 R /Resources << >> >>
endobj
25 0 obj
<< /Type /Page /MediaBox [0 0 612 792] /Contents 26 0 R /Resources << >> >>
endobjUn analyseur conforme à la spécification lit le catalogue, tente de résoudre /Pages, constate qu'il pointe vers le vide (ou une référence morte), puis lève une erreur ou signale zéro page. Ce qu'il ne peut pas faire, c'est continuer à prétendre que le fichier contient des pages et "réussir" silencieusement — ce qui produirait un résultat vide, apparaissant normal pour les outils automatisés mais révélant un problème pour quiconque tente de l'ouvrir
Pourquoi l'analyseur plante
La plupart des analyseurs PDF allouent des tables de pages internes lors du chargement sur la base de la valeur /Count du nœud racine Pages. Lorsque le nœud racine est absent, l'analyseur lit soit zéro et n'alloue rien, puis déréférence un pointeur nul la première fois que le code demande la page 1, soit lit des données corrompues et alloue un tampon d'une taille complètement incorrecte. Aucun de ces résultats n'est un traitement élégant. La violation d'accès à l'adresse 0x008E5D78 apparaissant dans les journaux de crash lors du traitement de tels fichiers est précisément due à cela : un déréférencement de pointeur nul dans le chemin d'accès aux pages, déclenché par l'absence d'une structure que l'analyseur suppose toujours présente
Cette hypothèse de conception sous-jacente est en soi raisonnable. La grande majorité des PDF existants possèdent un dictionnaire Pages. Un analyseur qui omet la vérification d'existence pour économiser quelques instructions n'est pas imprudent, mais optimise pour le cas le plus courant. Les fichiers qui déclenchent cette anomalie sont si rares que le code de production peut ne jamais en rencontrer — jusqu'au jour où cela arrive, rendant le plantage à la fois reproductible et déroutant, à moins que l'ingénieur n'ait préalablement lu la section §7.7.2
Récupération sans arbre Pages
Si l'analyseur doit traiter ces fichiers plutôt que de les rejeter, le chemin de récupération est prévisible : parcourir chaque objet indirect dans la table des références croisées, collecter tous les objets avec /Type /Page, et les trier par numéro d'objet. Bien que la spécification ne garantisse pas que l'ordre des numéros d'objet soit identique à l'ordre de lecture, dans la pratique, les générateurs omettant l'arbre des Pages écrivent généralement les pages séquentiellement, de sorte que l'ordre des numéros d'objet est généralement correct
Cette vérification est peu coûteuse en soi. Avant de parcourir le pointeur /Pages du catalogue, confirmez que le pointeur existe, qu'il pointe vers un objet réel, et que le /Type de l'objet résolu est bien /Pages. Si l'une de ces trois conditions n'est pas remplie, basculez sur un balayage linéaire. Pour les grands documents, le balayage linéaire est plus lent que le parcours d'arbre car il doit lire chaque en-tête d'objet plutôt que de suivre un chemin équilibré ; mais il fonctionne, et pour un fichier corrompu, la correction prime sur la vitesse
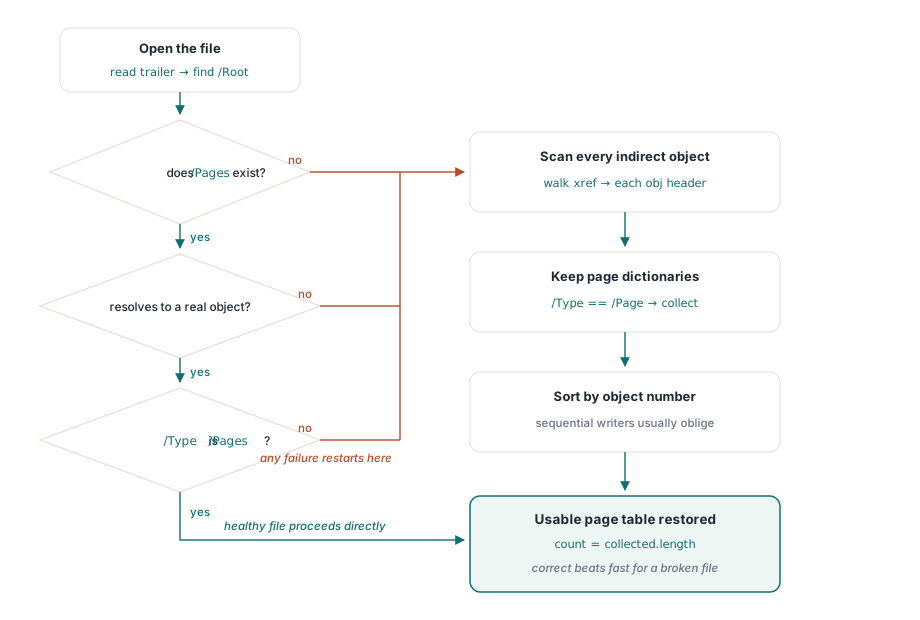
/Pages, et tout échec aiguille l'analyseur vers un balayage linéaire qui reconstruit la table des pages par numéro d'objetUn cas limite que le balayage linéaire ne résout pas automatiquement : l'ordre des pages. Sans tableau /Kids pour définir la séquence, l'ordre « correct » n'est pas défini par la spécification. L'ordre des numéros d'objet est le choix par défaut pragmatique ; si le fichier est assez important pour mériter un traitement soigné, vérifier si les objets Page portent un /StructParents explicite ou des références d'annotations qui impliquent un ordre de lecture vaut le travail supplémentaire
Implications pour les générateurs PDF
Pour ceux qui écrivent des générateurs PDF plutôt que des analyseurs, la conclusion est simple : écrivez toujours le nœud racine Pages avant de fermer le fichier. Un catalogue sans entrée /Pages n'est un PDF valide sous aucune version de la spécification. Les générateurs qui construisent dynamiquement des objets de page pendant le traitement et assemblent l'arbre des pages lors de la phase finale (ce que font la plupart des moteurs d'écriture en flux) ne posent aucun problème tant que l'étape de finalisation est effectivement exécutée. Le mode d'échec classique est une exception ou un retour prématuré interrompant le processus d'écriture avant que la fin du fichier ne soit écrite, laissant un fichier qui s'ouvre dans certains lecteurs (avec des heuristiques de récupération) mais échoue dans d'autres (sans elles)
PDF/A et PDF/UA imposent des contraintes supplémentaires sur l'arbre des pages au-delà de ce qu'exige la spécification de base, mais aucun des deux n'assouplit l'exigence /Pages. Un validateur qui contrôle la conformité à l'ISO 19005 ou à l'ISO 14289 signale un dictionnaire Pages manquant comme violation de la spécification de base avant même d'atteindre les règles propres au profil