Deux minutes pour copier trois pages d’un PDF de 40 pages n’est pas un problème de réglage de performances. C’est le signe que le mauvais chemin d’API est utilisé. La première fois que j’ai vu ce chronométrage sur du code de copie de pages bâti sur le HotPDF Delphi Component, mon réflexe a été d’examiner d’abord la structure du document et le code ensuite. Cet ordre s’est révélé être le mauvais
Qu'est-ce qui est réellement lent ?
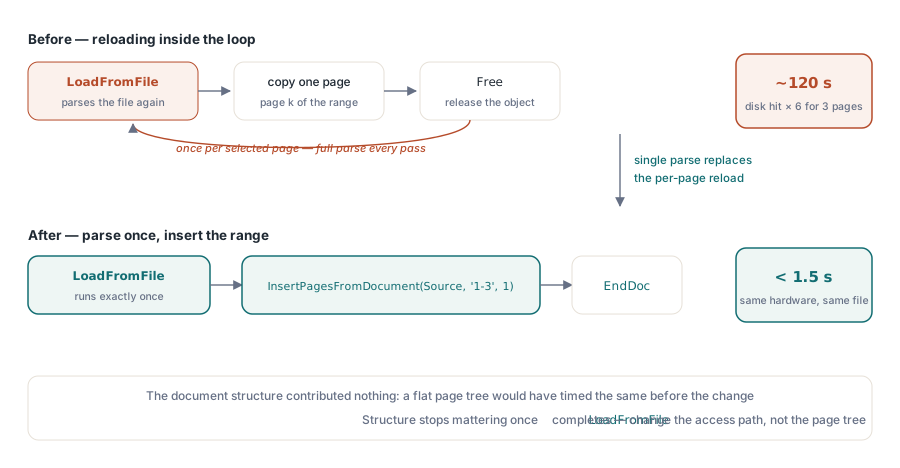
Le PDF en question était un document de référence de 40 pages doté d’un arbre de pages non trivial : plusieurs nœuds intermédiaires /Pages plutôt qu’un unique tableau plat. Le code en question appelait LoadFromFile, puis construisait un nouveau document avec BeginDoc, bouclait sur les numéros de pages sélectionnés et rechargeait à chaque itération le document source depuis le disque pour en tirer une page. Cela représente le coût complet de l’analyse multiplié par autant de pages que vous en voulez. Un fichier de 12 Mo sollicitait le disque six fois pour une extraction de trois pages, parce que personne n’avait vérifié si le fichier devait rester ouvert d’une itération à l’autre
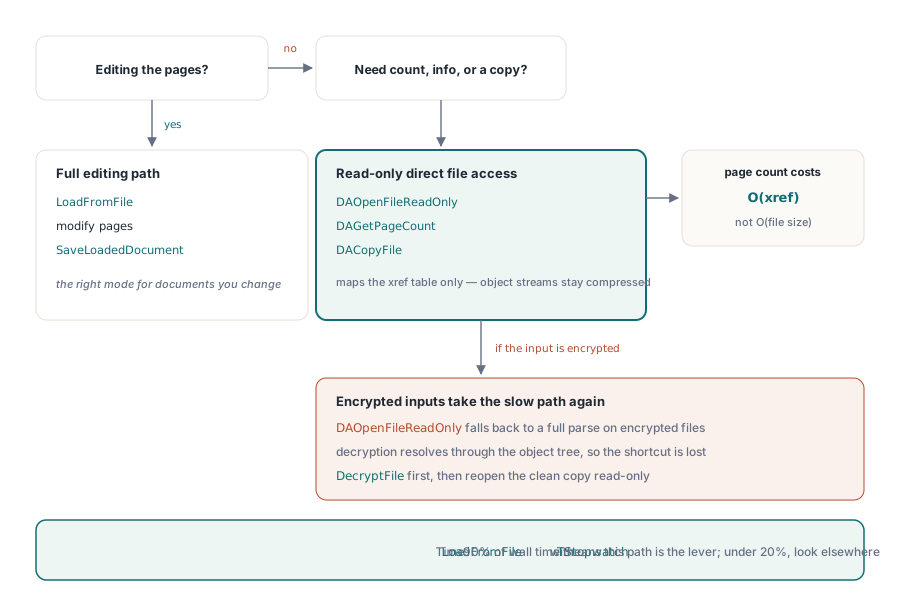
Le second facteur était invisible dans le code : le LoadFromFile de HotPDF construit le modèle d’objets en mémoire sur lequel l’API d’édition travaille. C’est le bon comportement pour un document que vous vous apprêtez à modifier, mais c’est plus de travail que nécessaire si vous ne voulez que le nombre de pages et une sous-partie des pages. Pour un accès en lecture seule à la structure, DAOpenFileReadOnly évite de désérialiser l’arbre d’objets complet, ce qui compte sur les fichiers compressés porteurs de grandes ressources d’images
Dans les deux cas, le fond du problème est le même : prendre l’API conçue pour un travail donné et l’employer pour un autre
Extraction de pages avec ExtractPagesToFile
Le bon chemin pour copier une plage de pages d’un document HotPDF chargé vers un nouveau fichier est ExtractPagesToFile, appelé après LoadFromFile sur la source. Vous chargez la source une seule fois, et l’appel construit le document de destination, y copie les pages sélectionnées et l’écrit sur le disque, le tout depuis la copie déjà en mémoire :
procedure ExtractPages(const SourceFile, DestFile: string;
  const PageRange: string);
var
  Source: THotPDF;
begin
  Source := THotPDF.Create(nil);
  try
    // Charge la source une seule fois : l’analyse complète se produit ici et nulle part ailleurs
    if Source.LoadFromFile(SourceFile) <= 0 then
      raise Exception.Create('Source PDF has no pages');

    // Écrit la plage demandée ('1-3', '1,5,7-9') directement dans un nouveau fichier
    Source.ExtractPagesToFile(DestFile, PageRange);
  finally
    Source.Free;
  end;
end;
Le paramètre PageRange accepte le même format que l’exemple en ligne de commande : une liste séparée par des virgules de numéros de pages ou de plages, comme '1-3' ou '1,5,7-9'. Les pages sont en base 1. ExtractPagesToFile copie chaque page sélectionnée avec les flux de contenu et les ressources qu’elle référence, si bien que pour une extraction de trois pages depuis un document de 40 pages, l’ensemble de travail reste réduit
Chronométrage sur le même fichier de 12 Mo qui prenait auparavant deux minutes : environ 1,3 seconde avec ce modèle. L’essentiel de ce temps est le seul appel LoadFromFile. Une fois la table d’objets résolue pour la première fois, la structure du document importe peu
Lorsque LoadFromFile est trop lourd : l'API de fichier direct
Si vous avez seulement besoin de compter les pages, de vérifier les informations du document ou de copier un fichier sans toucher à son contenu, l'API de fichier direct évite complètement une analyse complète. DAOpenFileReadOnly mappe la table des références croisées sans décompresser les flux d'objets, ainsi le comptage des pages est en O(taille de xref) plutôt qu'en O(taille du fichier) :
procedure InspectPDF(const FileName: string);
var
  Pdf: THotPDF;
  Handle, PageCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    Handle := Pdf.DAOpenFileReadOnly(FileName, '');
    if Handle <= 0 then
      Exit;
    try
      PageCount := Pdf.DAGetPageCount(Handle);
      Writeln('Pages: ', PageCount);

      // DACopyFile est une copie préservant les octets, sans resérialisation
      Pdf.DACopyFile(FileName, 'archive-copy.pdf');
    finally
      Pdf.DACloseFile(Handle);
    end;
  finally
    Pdf.Free;
  end;
end;
Un point à noter : DAOpenFileReadOnly accepte un paramètre de mot de passe, mais revient à une analyse complète pour les entrées chiffrées, car le déchiffrement nécessite l'arbre des objets pour analyser le dictionnaire de chiffrement. Si votre fichier source est chiffré, déchiffrez-le d'abord en une copie non chiffrée avec DecryptFile, puis ouvrez cette copie avec l'API de fichier direct. La fonction DecryptFile au niveau du fichier utilise un chemin de réécriture direct AES-256 pour les fichiers chiffrés standard, ce qui est plus rapide pour les grands fichiers que l'enchaînement "LoadFromFile suivi de SaveLoadedDocument" car elle ne construit pas le modèle d'objet complet en mémoire
Mémoire lors du traitement de gros volumes
Dans les traitements par lots manipulant des dizaines de fichiers dans une boucle, il existe un modèle qui semble correct mais accumule la mémoire : créer THotPDF dans la boucle, appeler LoadFromFile, travailler, puis appeler Free. C'est correct sur le plan structurel. Le problème survient lorsque le travail interne alloue des objets temporaires, capture des exceptions et laisse ces objets temporaires actifs sur le chemin d'erreur. Le gestionnaire de mémoire de Delphi ne fait pas de compactage, donc une centaine de fuites sur le chemin d'erreur dans un traitement par lots suffit à augmenter la mémoire au point de ralentir tout le reste
La méthode de correction n'est pas mystérieuse. Chaque THotPDF, ainsi que chaque TStream ou TBitmap intermédiaire participant au travail PDF, doit être placé dans un bloc try/finally, Free étant la dernière instruction. Configurez les pointeurs locaux sur nil avant try, de sorte que si l'initialisation échoue à mi-chemin, la branche finally puisse utiliser en toute sécurité if Assigned(x) then x.Free. C'est la discipline de propriété Delphi standard, et c'est tout ce que concerne ce type de problème
Une dernière chose à savoir dans les contextes par lots : AddImage enregistre chaque image auprès du document en cours de construction, et HotPDF libère ces enregistrements quand EndDoc termine ce fichier. Le registre suit le cycle BeginDoc/EndDoc, pas LoadFromFile, si bien que le modèle propre pour un lot est une instance de THotPDF par document : créez-la, faites le travail, enregistrez, libérez-la
Mesurez avant d'effectuer des modifications
Mesurez avant d'utiliser l'un de ces modes. TStopwatch de System.Diagnostics de Delphi enveloppe QueryPerformanceCounter, offrant une précision suffisante pour l'analyse du temps d'exécution des E/S de fichiers. Enveloppez simplement LoadFromFile pour voir combien de temps il prend. S'il représente 90 % du temps total, la solution consiste à utiliser l'API de fichier direct ou à réduire le nombre d'analyses sur le même fichier. S'il est inférieur à 20 %, le goulot d'étranglement est ailleurs et vous vous trompez de cible
L’extraction de deux minutes qui a motivé cet article s’est révélée être entièrement le modèle de chargements répétés. La structure du document n’y jouait aucun rôle ; un arbre de pages plat se serait comporté de la même manière. Passer à un unique LoadFromFile suivi d’un seul appel à ExtractPagesToFile a fait tomber le temps à environ 1,3 seconde sur le même matériel sans toucher à rien d’autre
L'API de manipulation de pages présentée ici appartient au composant HotPDF Delphi Component pour Delphi et C++Builder