Un chargeur Delphi qui parse un paquet XLSX de huit feuilles sur huit threads de travail peut afficher une courbe CPU qui dépasse à peine un cœur, et faire varier le nombre de threads de deux à huit laisse le chronomètre presque là où il était. Avec deux threads, le chargement peut même sortir plus lent qu'une simple boucle sérielle. Le code de parsing ne prend aucun verrou de son côté et les feuilles ne partagent aucune donnée, donc l'attente se produit quelque part que le source ne mentionne jamais : dans le gestionnaire mémoire, que chacun de ces workers appelle pour chaque nom d'élément, chaque valeur d'attribut et chaque cellule
Le nombre de threads est le bouton que tout le monde tourne en premier. Pour du code limité par les allocations, il ne bouge presque rien. Ce qui fait bouger la courbe, c'est le nombre d'allocations sur le tas que coûte chaque cellule
Comment HotXLS découpe Open en trois phases
HotXLS parse par défaut les feuilles de calcul d'un paquet XLSX multi-feuilles sur des threads de travail. TXLSXWorkbook.ParallelParse démarre à True, et ParallelParseThreads démarre à 0, ce qui signifie un worker par processeur logique rapporté par le système d'exploitation, jamais plus de workers que de feuilles à parser. Une seule des trois phases de Open tourne sur ces workers. La phase A est sérielle : elle lit la partie workbook, les chaînes partagées et les styles, crée chaque feuille avec son nom et sa visibilité, et parse le fichier de relations de chaque feuille pour que les cibles des liens hypertextes et des tableaux soient déjà résolues. Au moment où un worker démarre, chaque table de correspondance qu'il consulte est complète et n'est plus jamais que lue
La phase B confie chaque feuille de calcul à un worker. Les workers réclament des index de feuilles depuis un compteur partagé avec un incrément interlocked, si bien qu'un classeur avec une grande feuille et sept petites s'équilibre tout seul sans ordonnanceur : celui qui finit une petite feuille prend simplement l'index suivant. Le conteneur ZIP est la partie qui ne peut pas être partagée naïvement, parce qu'un flux deflate transporte un état d'un bloc au suivant et que deux threads ne peuvent pas faire avancer le même décompresseur. Chaque worker ouvre donc son propre décompresseur sur sa propre entrée de feuille et streame le XML directement dans son propre lecteur. Le handle de fichier est la seule ressource partagée, et le verrou qui l'entoure couvre un seul seek-and-read d'octets compressés à la fois. Décompression et parsing tournent tous deux en parallèle, et le XML d'une feuille n'est jamais tenu entièrement décompressé en mémoire. Quand le parsing se termine, le worker lit son entrée jusqu'au bout pour que les contrôles de taille et de CRC du ZIP s'exécutent quand même
La phase C revient sur un seul thread pour les parties accrochées à chaque feuille : commentaires et commentaires threadés, dessins et graphiques, tableaux et paramètres d'impression. Dans la plupart des classeurs, c'est petit à côté du XML des cellules
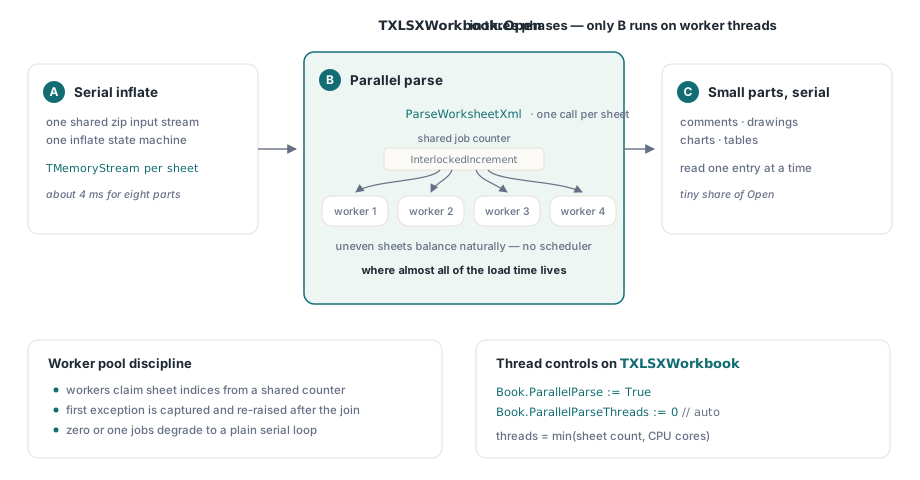
Les erreurs reviennent sur le thread appelant. Quand une feuille lève une exception pendant le parsing, le pool cesse de distribuer de nouveaux index, attend les workers encore en cours, puis relève depuis Open l'exception de la feuille en échec au plus petit numéro, de sorte que le rapport suit l'ordre des feuilles et que l'appelant n'a jamais à gérer une exception qui s'échappe d'un thread de travail. Avec RecoveryMode à True, une feuille qui ne parse pas est sautée à la place, un avertissement atterrit dans Diagnostics, et les feuilles restantes se chargent normalement. Mettre ParallelParse à False fait tourner le même parseur sur les feuilles une par une et produit des résultats identiques
var
  Book: TXLSXWorkbook;
begin
  Book := TXLSXWorkbook.Create;
  try
    // Les deux valeurs sont les défauts ; les écrire garde le choix
    // visible en revue de code
    Book.ParallelParse := True;
    Book.ParallelParseThreads := 0;  // 0 = un worker par CPU logique, plafonné au nombre de feuilles
    Book.RecoveryMode := False;      // une feuille qui ne parse pas lève depuis Open
    if Book.Open('quarterly-ledger.xlsx') <> 1 then
      raise Exception.Create('open failed');
    // chaque feuille est entièrement chargée ici ; lisez les cellules comme d'habitude
  finally
    Book.Free;
  end;
end;
Pourquoi des threads en plus ralentissent-ils un parseur gourmand en allocations ?
Le parsing de feuilles, ce sont surtout de petites allocations, et le gestionnaire mémoire par défaut de Delphi fait passer les threads à tour de rôle dessus. Un lecteur XML naïf produit une chaîne pour chaque nom d'élément, une autre pour chaque nom et valeur d'attribut, un Variant pour la cellule et une chaîne pour son texte. Le gestionnaire mémoire par défaut garde les petits blocs dans des pools groupés par taille et protège chaque pool par un verrou. Un thread qui trouve le verrou pris recule et dort avant de réessayer. Quand huit workers demandent tous la même poignée de tailles minuscules, ils n'arrêtent pas de se percuter sur les mêmes pools, et des threads qui paraissent indépendants dans le source finissent par tourner l'un après l'autre
Cela explique les deux symptômes de l'introduction. Le temps CPU reste proche du temps horloge parce qu'un thread endormi ne brûle pas de CPU, et le balayage de threads reste plat parce que ce sont les verrous des pools, pas les cœurs, qui donnent le rythme. Deux threads peuvent perdre net contre un seul : chaque allocation paie maintenant le va-et-vient d'un verrou entre cœurs, alors que la boucle sérielle n'est jamais en concurrence
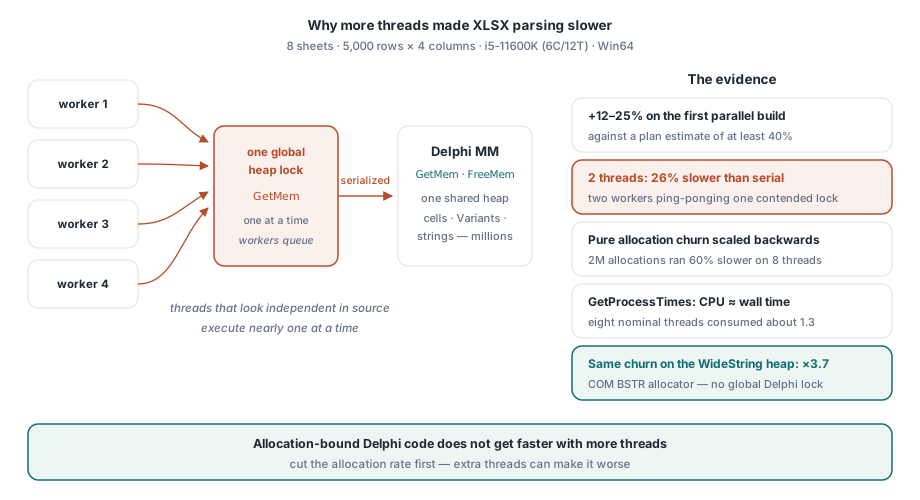
Un type de chaîne échappe à cela sous Windows. Un WideString est un BSTR COM, alloué par l'allocateur de chaînes OLE du système plutôt que par le gestionnaire mémoire Delphi, donc le trafic WideString ne fait jamais la queue sur les pools Delphi. HotXLS stocke le texte des cellules en WideString, ce qui compte davantage pour le chargement parallèle que cela n'a jamais compté pour le chemin sériel
Mesurer la contention sur vos propres classeurs
Deux nombres vous disent si un chargement est limité par les allocations : comment le temps horloge évolue quand le nombre de workers monte, et combien de CPU le processus a consommé sur le même intervalle. Si le temps CPU divisé par le temps horloge reste proche de 1,0 alors que huit workers sont nominalement occupés, ils font la queue au lieu de parser. Le balayage ci-dessous ouvre le même fichier avec un à huit workers et imprime les deux chiffres. C'est un harnais de mesure pour votre propre projet de test ; seuls les membres de TXLSXWorkbook viennent de HotXLS
uses
  Winapi.Windows, System.SysUtils, System.Math, System.Diagnostics;

// Votre propre helper : temps CPU user + kernel de ce processus, en millisecondes
function ProcessCpuMs: Int64;
var
  Created, Exited, Kernel, User: TFileTime;
begin
  GetProcessTimes(GetCurrentProcess, Created, Exited, Kernel, User);
  Result := (Int64(Kernel) + Int64(User)) div 10000;  // ticks de 100 ns vers ms
end;

procedure SweepThreads(const FileName: string);
var
  N: Integer;
  Book: TXLSXWorkbook;
  SW: TStopwatch;
  Cpu0, Cpu: Int64;
begin
  for N := 1 to 8 do
  begin
    Book := TXLSXWorkbook.Create;
    try
      Book.ParallelParseThreads := N;  // 1 fait tourner la simple boucle sérielle
      Cpu0 := ProcessCpuMs;
      SW := TStopwatch.StartNew;
      if Book.Open(FileName) <> 1 then
        raise Exception.CreateFmt('open failed: %s', [FileName]);
      SW.Stop;
      Cpu := ProcessCpuMs - Cpu0;
      Writeln(Format('%d workers: %d ms wall, CPU/wall %.2f',
        [N, SW.ElapsedMilliseconds, Cpu / Max(Int64(1), SW.ElapsedMilliseconds)]));
    finally
      Book.Free;
    end;
  end;
end;
Lancez le balayage plusieurs fois et gardez le meilleur chiffre pour chaque nombre de workers, puisque le premier passage paie aussi un cache disque froid. Une courbe de temps horloge plate avec CPU/horloge proche de 1 signifie que le gestionnaire mémoire est le plafond. Si le temps horloge continue de baisser pendant que CPU/horloge grimpe vers le nombre de workers, le fichier est limité par le parsing et les workers supplémentaires méritent leur place
Une courbe plate mène à la question suivante : quelles allocations en sont responsables ? Un wrapper de gestionnaire mémoire qui compte les appels par taille y répond en quelques minutes sans aucun profileur. La version ci-dessous ne compte que GetMem et laisse FreeMem et ReallocMem pointer vers le gestionnaire d'origine, ce qui suffit pour voir d'où vient le trafic
// Diagnostic à ajouter à votre propre harnais de test ; ne fait pas partie de HotXLS
var
  OldMM, NewMM: TMemoryManagerEx;
  AllocCount, TinyCount: Int64;

function CountingGetMem(Size: NativeInt): Pointer;
begin
  AtomicIncrement(AllocCount);
  if Size <= 32 then
    AtomicIncrement(TinyCount);  // l'usure de petits blocs à surveiller
  Result := OldMM.GetMem(Size);
end;

procedure InstallCounter;
begin
  GetMemoryManager(OldMM);
  NewMM := OldMM;
  NewMM.GetMem := CountingGetMem;
  SetMemoryManager(NewMM);
end;

procedure RemoveCounter;
begin
  SetMemoryManager(OldMM);
end;
Installez le compteur juste avant Open, retirez-le juste après, et divisez AllocCount par le nombre de cellules du fichier. Ce chiffre par cellule est celui à suivre de build en build, et la part des blocs de 32 octets ou moins montre si les chaînes courtes dominent. Vérifiez-le avant d'écrire un pool d'objets cellule : chaque objet cellule est une allocation, et les chaînes éphémères créées pendant le parsing de cette cellule peuvent facilement la dépasser plusieurs fois
Où se cachent les allocations dans le XML des feuilles
Une cellule comme <c r="B7" s="3" t="s"><v>42</v></c> paraît minuscule sur le disque. Un lecteur direct en fait quand même une série de chaînes fraîches : les noms d'éléments c et v, trois noms d'attributs, trois valeurs d'attributs et le contenu textuel. Convertir chaque token UTF-8 via la RTL ajoute un UnicodeString intermédiaire avant que le WideString final existe. Aucune de ces chaînes ne survit à la cellule, et chacune est un passage par le gestionnaire mémoire
Le lecteur XML de HotXLS s'attaque aux deux plus grosses sources. Les noms d'éléments du XML de feuille viennent d'un vocabulaire très réduit (row, c, v, f, is), donc le lecteur garde un petit cache des noms déjà rencontrés, compare les octets bruts de chaque nouveau nom à ce cache, et renvoie la chaîne en cache en cas de correspondance. Les copies en cache sont délibérément des AnsiString. AnsiString est compté par références, donc distribuer une instance en cache coûte un incrément de compteur et aucune allocation. Un cache de noms WideString n'apporterait rien : WideString n'a pas de compteur de références, et chaque affectation fait une nouvelle allocation système
Les noms d'attributs, les valeurs d'attributs et le texte des cellules prennent l'autre route. Le lecteur décode l'UTF-8 directement depuis son tampon de scan en deux passes : la première compte les unités de code UTF-16, la seconde remplit un WideString alloué une seule fois à exactement cette longueur. Cela fait une allocation par token, et elle atterrit sur l'allocateur de chaînes du système plutôt que sur les pools Delphi. Les références de caractères comme A et les entités prédéfinies sont résolues par le scanner avant le début du décodage, si bien que le décodeur ne voit jamais que de l'UTF-8 brut. Pour les séquences d'octets qui ne sont pas de l'UTF-8 valide, le décodeur recopie les octets fautifs un par un là où la conversion RTL les abandonnerait ou les remplacerait, donc un fichier abîmé donne encore de l'ASCII lisible autour de l'endroit défectueux. Une entrée valide se décode vers le même texte dans les deux cas
Les deux astuces se transposent à votre propre code de parsing Delphi. Mettre des chaînes en cache n'économise des allocations que si le type de chaîne est compté par références, et décoder directement dans le type de destination supprime le temporaire que les fonctions de conversion pratiques de la RTL créent à chaque appel
Quels classeurs y gagnent, et quels réglages choisir
Le parsing parallèle travaille à la granularité de la feuille, donc la forme du classeur décide de l'essentiel du résultat. Plusieurs feuilles de taille comparable sont le meilleur cas, y compris les fichiers obtenus en dupliquant une feuille modèle une fois par région ou par mois. Un classeur qui n'est qu'une feuille géante parse sur un seul worker quoi qu'en dise ParallelParseThreads ; pour cette forme, le lecteur direct en streaming convient mieux, parce qu'il ne construit jamais tout le classeur en mémoire. Le temps passé sur les commentaires, graphiques et dessins reste dans la phase C sérielle. Un fichier avec zéro ou une feuille à parser saute le pool et fait tourner la simple boucle sérielle
Quand seules certaines feuilles comptent, listez leurs noms dans SelectedSheets avant d'appeler Open. Les autres feuilles sont toujours créées avec leur nom et leur visibilité mais sans cellules, les workers passent dessus, et LoadSheet en remplit une plus tard si l'utilisateur l'ouvre
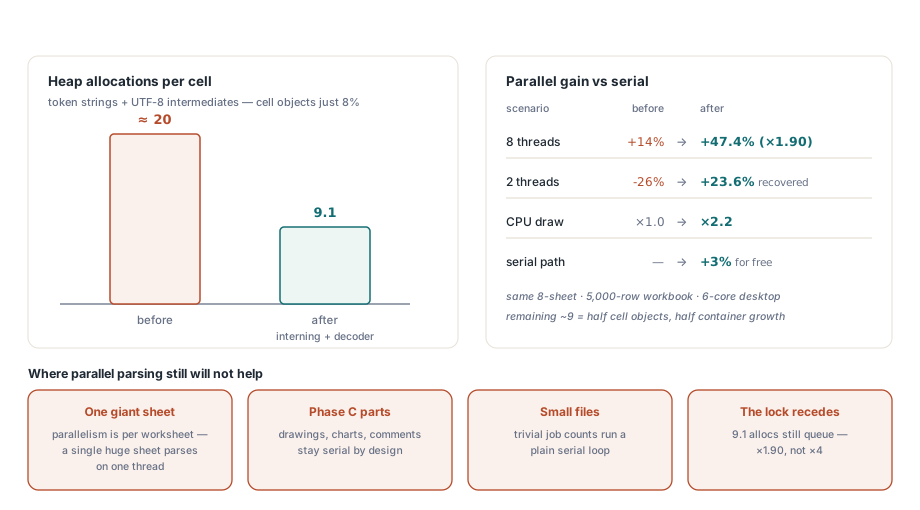
Laissez ParallelParse activé pour les outils de bureau et les jobs par lots qui ouvrent un classeur à la fois. Ce défaut est le plus sûr : les résultats correspondent au chemin sériel, et une propriété le désactive si une question de threading se pose un jour. Un serveur qui ouvre déjà plusieurs classeurs en même temps, c'est différent. Chaque thread de requête alloue lui aussi, donc chaque worker de parsing supplémentaire ajoute un concurrent de plus pour les mêmes pools du gestionnaire mémoire ; mettez-y ParallelParseThreads à 2, et ne l'augmentez qu'après que le balayage ci-dessus, lancé sur ce serveur sous sa charge normale, montre que les workers supplémentaires se paient. Moins d'allocations par cellule relèvent le plafond sans le supprimer. Les objets cellule et la croissance des conteneurs passent toujours par les pools Delphi, ce qui explique que le gain de huit workers reste bien en dessous de huit fois. Pour le reste de la boîte à outils de chargement et de sauvegarde, de la réutilisation des styles aux callbacks de lignes en masse, voyez le guide sur la performance des gros classeurs en Delphi
Le pool de workers, les interrupteurs ParallelParse et ParallelParseThreads et le lecteur XML économe en allocations sont tous livrés dans le HotXLS Delphi Excel Component, qui lit et écrit XLS, XLSX et ODS directement depuis du code Delphi et C++Builder sans Excel installé sur la machine