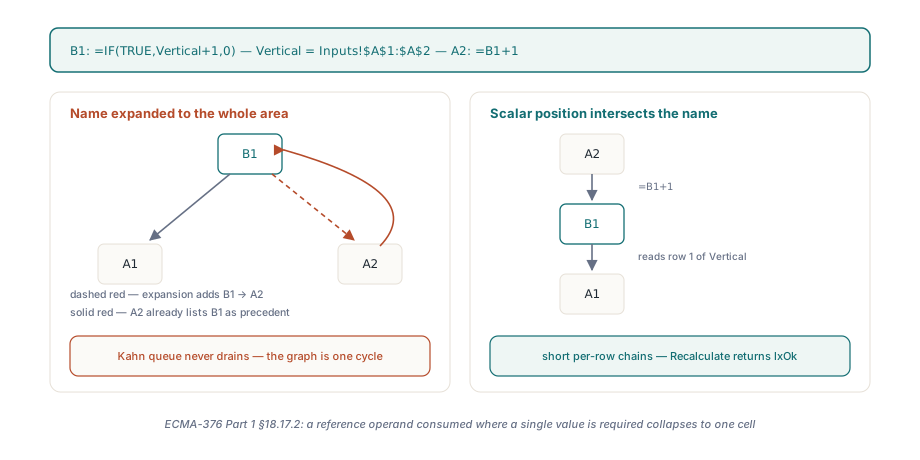
Un nom défini qui renvoie à une colonne entière est lu par Excel comme une seule cellule dès qu'il apparaît dans une position scalaire : =Vertical+1 en ligne 7 signifie « la cellule de la ligne 7 de Vertical », pas toute la plage. Le HotXLS Delphi Component applique cette intersection implicite en v2.382.4 à deux niveaux, pendant l'évaluation et pendant l'extraction des dépendances, parce qu'un modèle de prêt à 4805 formules a montré que bien calculer la valeur ne suffit pas. Quand le parcours de dépendances étend le nom à toute sa plage, une formule en aval qui alimente n'importe quelle cellule de cette plage referme un cycle qui n'existe pas, et TXLSXWorkbook.Recalculate refuse le classeur entier
Le modèle en question est un classeur d'amortissement de prêt classique. Avec toutes les valeurs en cache empoisonnées à 777 et une exécution complète de Recalculate, les deux architectures de moteur renvoyaient 23, soit lxErrorRef, le code de référence circulaire. 3842 des 4805 formules ne correspondaient pas à l'attente indépendante, B18 contenait #VALUE!, E18 valait encore 777, et le nombre de paiements en J7 avait lu les valeurs de remplissage d'une colonne de solde inachevée. Trois défauts distincts se cachaient derrière un seul code de retour, et cet article les parcourt un par un avec le code source qui les a corrigés
Pourquoi une référence scalaire à un nom de colonne crée-t-elle un faux cycle ?
Parce qu'un graphe de dépendances ne connaît que des arêtes, et qu'une arête allant d'une formule à une plage de 480 lignes représente 480 arêtes, dont l'une repart vers une cellule qui dépend de la formule. Prenez =IF(TRUE,Vertical+1,0) en B1 avec Vertical défini comme Inputs!$A$1:$A$2, et =B1+1 en A2. Excel évalue B1 comme A1+1 et A2 comme B1+1, une simple chaîne. Un parcours qui enregistre B1 comme dépendant de A1:A2 fait de A2 un précédent de B1, alors que A2 liste déjà B1 comme précédent, et la file de Kahn qui pilote le recalcul incrémental dans HotXLS ne voit jamais ni l'un ni l'autre nœud atteindre un degré entrant nul. C'est le motif dont sont faits les modèles de prêt : chaque ligne de période référence des colonnes nommées pour le solde, le taux et le nombre de paiements, chaque nom couvre tout l'échéancier, et chaque ligne écrit aussi dans ces colonnes. Étendez les noms et le graphe devient une seule grande composante fortement connexe. Évaluez-les avec intersection implicite et le graphe redevient un ensemble de chaînes courtes, une par ligne, ce que décrit ECMA-376 Partie 1 §18.17.2 pour un opérande de référence consommé là où une valeur unique est requise
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Position scalaire : Vertical se réduit à A1 car la formule est en ligne 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Un nom défini par un autre nom s'intersecte quand même, donc ici c'est A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Argument de classe référence : toute la plage est sommée, pas intersection
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // La ligne 6 est hors de A1:A2, intersection vide et IFERROR l'attrape
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Avant v2.382.4 cette branche était inatteignable : B1 -> A2 -> B1 était un cycle
    end;
  finally
    Book.Free;
  end;
end;
Comment HotXLS décide-t-il qu'un argument est scalaire ?
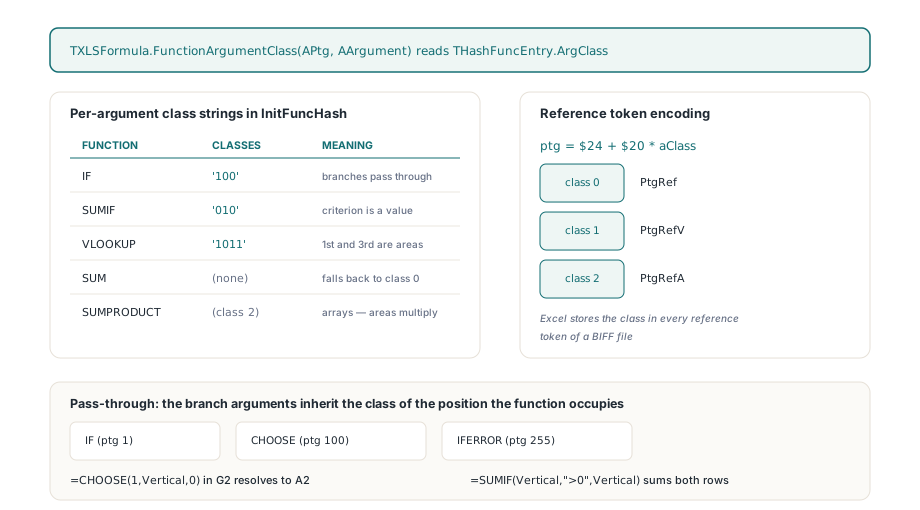
HotXLS lit la réponse dans la table des fonctions plutôt que dans la forme de l'argument. Chaque entrée de TXLSFormula.InitFuncHash est enregistrée via THashFunc.SetValue avec une chaîne de classes par argument facultative : 'IF' porte '100', 'SUMIF' porte '010', 'VLOOKUP' porte '1011', et 'SUM' n'en porte aucune, donc tous ses arguments retombent sur la classe 0 au niveau de la fonction. Le nouveau TXLSFormula.FunctionArgumentClass(APtg, AArgument) expose cet octet via THashFuncEntry.ArgClass, et un résultat de 1 signifie classe valeur. Ce sont les trois mêmes classes que [MS-XLS] §2.2.2 attribue aux jetons d'opérande, et l'encodeur en dépendait déjà : quand il écrit une référence, il calcule le ptg comme $24 + $20 * aClass, ce qui donne PtgRef pour la classe 0, PtgRefV pour la classe 1 et PtgRefA pour la classe 2. Un fichier BIFF écrit par Excel stocke cette classe dans chaque jeton de référence, donc un moteur dont la table correspond à la spécification peut répondre « cet argument est-il scalaire » sans regarder les données. L'argument du milieu de SUMIF est le critère, une valeur ; le premier et le troisième sont des zones, des références. SUMPRODUCT est enregistré avec la classe 2 au niveau de la fonction, tableau, et c'est pourquoi =SUMPRODUCT(Vertical,Vertical) multiplie encore toute la plage
Trois fonctions ne consultent pas leur propre entrée de table au-delà du premier argument. IF (ptg 1), CHOOSE (ptg 100) et IFERROR (ptg 255) transmettent ce qu'elles sélectionnent, si bien que leurs arguments de branche héritent de la classe de la position qu'occupe la fonction elle-même. C'est cette règle unique qui permet à =CHOOSE(1,Vertical,0) en G2 de se résoudre en A2 alors que =SUMIF(Vertical,">0",Vertical) juste à côté additionne encore les deux lignes, et c'est la règle qu'un échéancier d'amortissement sollicite le plus, parce que ses cellules de période s'appuient sur IF pour tester si le prêt est toujours ouvert
Propager la classe à travers le parcours de dépendances
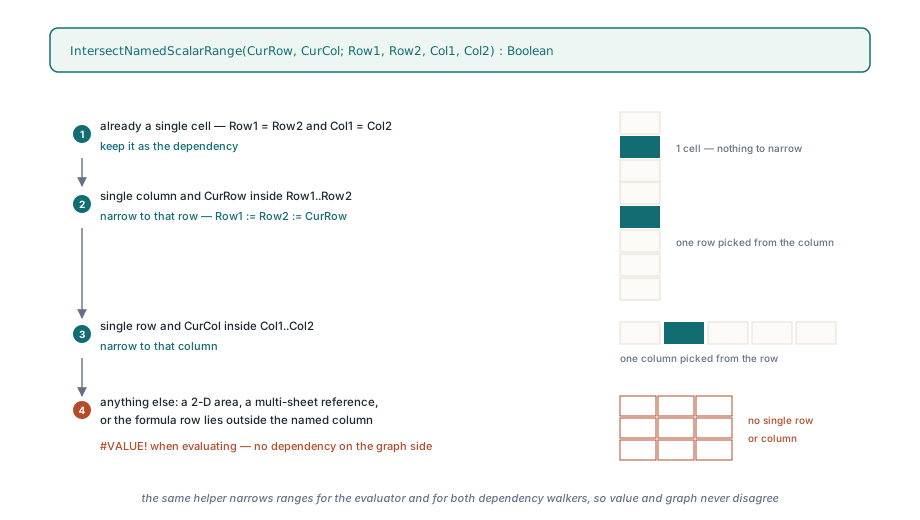
L'extracteur de dépendances dans lxCalc.pas est un Walk récursif sur l'arbre syntaxique compilé, et il existe en double, une fois dans TXLSCalculator.ExtractDependencies pour le graphe par classeur et une fois dans ExtractWorkspaceDependencies pour le graphe inter-classeurs. La v2.382.4 donne aux deux parcours deux paramètres supplémentaires. AScalar démarre à True à la racine d'une formule, est recalculé pour chaque enfant de fonction à partir de FunctionArgumentClass, et est transmis tel quel pour les arguments de branche des ptg 1, 100 et 255. ANameRoot ne passe à True que lorsque le parcours descend dans la définition compilée d'un nom, et il ne survit qu'à travers les nœuds SA_GROUP, les parenthèses, pour qu'un nom défini comme =A1:A2+1 ne soit pas pris pour une simple plage. Quand les deux drapeaux sont à True sur un nœud SA_RANGE, AddResolvedRange réduit la plage avec le même utilitaire que l'évaluateur avant d'enregistrer la dépendance. Cet utilitaire est assez court pour être cité en entier
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // déjà une cellule
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // colonne unique : prendre cette ligne
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // ligne unique : prendre cette colonne
    Result := True;
  end;
end;
Tout ce que l'utilitaire rejette — une zone bidimensionnelle, une référence multi-feuilles ou une formule dont la ligne tombe hors de la colonne nommée — produit #VALUE! côté évaluation et aucune dépendance du tout côté graphe, ce qui est le comportement d'Excel pour une intersection vide. Le côté évaluation vit dans TXLSCalculator.GetValueItemName : il retire les enveloppes SA_GROUP de la définition compilée, et si la racine est un SA_RANGE, il appelle GetRangeInfo, intersecte, et récupère l'unique cellule via FGetValue au lieu d'évaluer toute la définition. Les références externes restent sur l'ancien chemin, parce qu'il n'y a pas de ligne locale contre laquelle intersecter. L'origine du stockage et de la portée d'un nom est traitée dans l'article sur les noms définis et les formules inter-feuilles ; ce qui compte ici, c'est seulement ce que fait le moteur une fois le nom résolu
Pourquoi MATCH sur une colonne à moitié calculée lisait-il 777 ?
Parce que l'argument de matrice de recherche de MATCH est une référence de balayage, et que les références de balayage étaient délibérément exclues de l'ordre d'évaluation. L'article sur le balayage de recherche a introduit TXLSDepRange.LookupScan et se terminait par une section intitulée « Ce à quoi vous renoncez en excluant les arêtes de balayage de l'ordonnancement » : une formule de recherche peut s'exécuter avant que toutes les cellules de sa plage aient été recalculées et lire des valeurs périmées. En session interactive, cela converge à la passe suivante. Dans un recalcul par lots d'un modèle empoisonné, non, et PaymentCount, défini comme =MATCH(0.01,Balances,-1)+1, lisait les 777 de remplissage encore présents dans la colonne de solde et renvoyait un nombre de périodes qui ne pouvait pas être juste
TXLSDepGraph.TopoOrder traite désormais les arêtes de balayage comme des arêtes d'ordonnancement souples. À côté du degré entrant dur, il tient un tableau ScanInDeg, qui compte les précédents de balayage sales par nœud et le décrémente à mesure que ces précédents sont émis, en s'appuyant sur les listes ScanPrecedents, ScanDependents et ScanPrecedentCount que le changement précédent stockait déjà. À chaque itération, la file de Kahn parcourt sa fenêtre de nœuds prêts pour trouver le premier dont ScanInDeg est nul et l'échange en tête ; si tous les nœuds prêts attendent encore un précédent de balayage, la tête est extraite dans son ordre stable. Les arêtes de balayage n'entrent jamais dans le degré entrant dur, donc un VLOOKUP autoréférent sur sa propre colonne reste légal, mais une recherche qui pourrait attendre un précédent capable de se terminer le fait maintenant. La régression qui verrouille ce comportement, LookupScan_WaitsForDirtyFormulaValues, empoisonne trois cellules de solde à 777 et attend que PaymentCount revienne à 3, puis bascule l'entrée à zéro et attend que =IFERROR(PaymentCount,99) voie le #N/A et renvoie 99
D'où venait la troncature à quatre décimales ?
De l'arithmétique Variant de Delphi, et uniquement dans les positions imbriquées. Les opérateurs binaires de TXLSCalculator.GetValueItem recopiaient déjà un + ou un - de premier niveau dans deux locales Double, donc =B1-A1 allait bien. Dans =IF(TRUE,B1-A1,0), la même soustraction s'exécutait comme Value := Value - SubValue sur deux Variants, et quand un opérande était une valeur de cellule Int64 et l'autre un Double, le résultat que nous observions était un Currency, un type à virgule fixe à quatre décimales : 1066.1854641400994 moins 120 revenait donc tronqué à quatre décimales. Sur un échéancier où chaque paiement se compose à partir de la ligne précédente, cette erreur traverse des centaines de périodes avant d'atteindre les totaux
// TXLSCalculator.GetValueItem, branche arithmétique binaire (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// L'arithmétique Variant mixte Int64/Double peut promouvoir en Currency.
// L'arithmétique de tableur doit conserver la précision flottante.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Le garde-fou s'exécute avant SA_ADD, SA_SUB, SA_MUL et SA_DIV de la même façon, et la régression Arithmetic_MixedInt64AndDoubleKeepsPrecision stocke Int64(120) en A1 et 1066.1854641400994 en B1, puis vérifie la différence et la somme imbriquées à 1E-10 et le produit et le quotient à 1E-8 et 1E-12. HotXLS ne prétend pas connaître toutes les règles de promotion que la RTL applique aux types Variant mixtes selon les versions du compilateur ; il affirme que l'arithmétique de tableur est du double IEEE, et il convertit désormais les deux opérandes en double avant que l'opérateur ne les voie, ce qui supprime la question
Ce que le correctif garantit, et ce qu'il ne garantit pas
Après la v2.382.4, les deux architectures de moteur renvoient lxOk pour le modèle empoisonné, les 4805 valeurs en cache correspondent à l'attente indépendante ligne par ligne à 1E-7 près, et les assertions vérifiant que les caches étaient bien empoisonnés, que le hash source est inchangé et que chaque formule est toujours présente tiennent toutes. Aucune itération n'a été activée et aucun code d'erreur n'a été masqué pour y arriver. Un vrai cycle passant par un nom — =B1 en A1 avec B1 qui lit encore Vertical — renvoie toujours une erreur, et le test NamedScalarRanges_IntersectWithoutFalseCycles se termine en affirmant exactement cela
Les limites méritent d'être énoncées clairement. L'intersection implicite ne s'applique qu'à un nom dont la définition compilée, une fois les parenthèses retirées, est une plage d'une seule colonne ou d'une seule ligne sur une seule feuille ; un nom bidimensionnel en position scalaire donne #VALUE!, comme dans Excel, et une fonction que la table ne connaît pas reçoit la classe 0 de FunctionArgumentClass, donc ses arguments de nom restent étendus en entier. L'ordonnancement souple est une préférence, pas une garantie : un cycle uniquement de balayage s'évalue encore dans l'ordre stable et lit ce qui est en cache, ce que l'article sur le balayage de recherche acceptait à dessein. Et le résultat sur le modèle entier est vérifié contre un script d'attente indépendant, pas contre un autre moteur de tableur, parce que la suite bureautique de référence n'a pas fini de recalculer le modèle d'origine dans un budget de 60 secondes. HotXLS est un composant tableur natif Delphi et C++Builder qui lit, recalcule et écrit XLS, XLSX, ODS et CSV sans Excel installé ; l'intersection des noms, la table de classes d'arguments et l'ordonnancement souple des balayages s'appliquent à tous les formats parce que le moteur de calcul est partagé, et la couverture actuelle des fonctions est listée sur la page produit du HotXLS Delphi Component