Un encodeur Reed-Solomon qui range le terme constant de son polynôme générateur en premier puis divise par le terme de tête en premier ne calcule aucune correction d'erreur. HotPDF a livré exactement cela dans quatre encodeurs de codes 2D, QR, Data Matrix, PDF417 et Aztec, et chaque symbole produit portait un bloc de contrôle qu'aucun scanner conforme ne pouvait utiliser
La partie intéressante n'est pas l'erreur d'arithmétique, c'est la propagation. Un encodeur a été écrit en premier, sa boucle de division a été copiée dans les trois suivants, et chaque nouveau format a hérité d'un défaut jamais validé contre un seul vecteur de test publié. Les symboles se rendaient quand même, les motifs de détection étaient au bon endroit, les tailles étaient correctes. Seuls les octets qui permettent à un code 2D de survivre à une tache étaient de la poubelle
Un polynôme inversé, copié dans quatre encodeurs
La cause racine est une incohérence d'ordre de stockage dans la boucle de division synthétique. Les quatre encodeurs de HotPDF construisent le polynôme générateur avec des coefficients du bas vers le haut, donc Gen[0] contient le terme constant et Gen[High(Gen)] le coefficient dominant monique. La boucle de division indexait Gen[J] vers l'avant en parcourant le message, ce qui est arithmétiquement identique à diviser par le polynôme inversé. Il y avait une deuxième conséquence qui masquait la première : comme le coefficient dominant n'atterrissait jamais à la position I, Work[I] n'était jamais remis à zéro, donc la division ne réduisait en réalité jamais rien. La boucle se terminait quand même et remplissait quand même la queue avec un tableau de la longueur exactement correcte
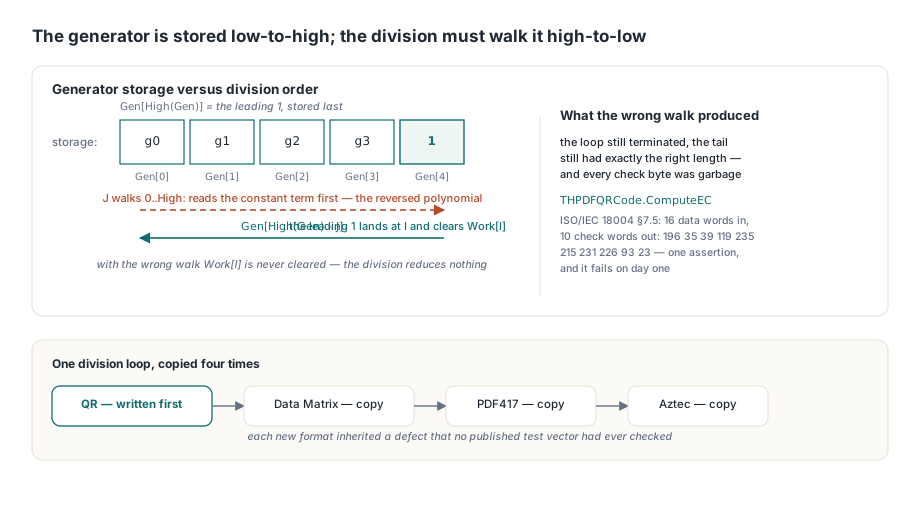
// THPDFQRCode.ComputeEC dans HPDFQRCode.pas
Gen := GeneratorPoly(ECCount);            // Gen[0] est le terme constant
SetLength(Work, Length(Data) + ECCount);
for I := 0 to High(Data) do
  Work[I] := Data[I];
for I := Length(Data) to High(Work) do
  Work[I] := 0;
for I := 0 to High(Data) do
begin
  Factor := Work[I];
  if Factor = 0 then
    Continue;
  // Gen[High(Gen)] est le 1 dominant qui remet Work[I] à zéro ; parcourir
  // Gen vers l'avant divise par le polynôme inversé à la place
  for J := 0 to High(Gen) do
    Work[I + J] := Work[I + J] xor GFMul(Gen[High(Gen) - J], Factor);
end;
Le correctif tient en une seule expression d'index, Gen[High(Gen) - J]. Après elle, THPDFQRCode.ComputeEC reproduit l'exemple travaillé d'ISO/IEC 18004 §7.5 : le bloc en mode octets version 1-M 32 91 11 120 209 114 220 77 67 64 236 17 236 17 236 17 produit les dix mots de contrôle 196 35 39 119 235 215 231 226 93 23. C'est une seule assertion, et elle aurait échoué dès le premier jour
Pourquoi le symbole Aztec perdait-il aussi sa charge utile ?
Aztec portait une version plus lourde du même bug parce que TAztecGF.Encode divise en place. La routine reçoit Words contenant le message suivi d'emplacements de mots de contrôle à zéro, et l'appelant émet ce tableau entier dans le symbole. La division polynomiale détruit le dividende en le réduisant, donc une fois la boucle corrigée pour réduire vraiment, les mots du message étaient écrasés en cours de route. Charge utile et message de mode ressortaient tous deux corrompus, un échec que la version cassée avait accidentellement évité en ne réduisant jamais rien
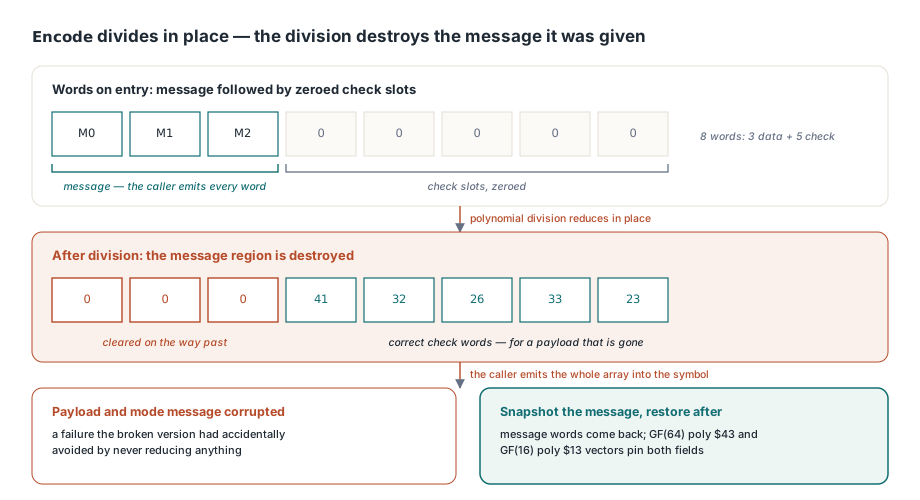
// TAztecGF.Encode dans HPDFAztec.pas
SetLength(Message, DataCount);
for I := 0 to DataCount - 1 do
  Message[I] := Words[I];
for I := 0 to DataCount - 1 do
begin
  Factor := Words[I];
  if Factor = 0 then
    Continue;
  for J := 0 to ECCount do
    Words[I + J] := Words[I + J] xor Multiply(Gen[ECCount - J], Factor);
end;
// La division efface la zone du message, mais l'appelant émet le tableau
// entier dans le symbole, donc les mots de données doivent revenir
for I := 0 to DataCount - 1 do
  Words[I] := Message[I];
Aztec utilise deux corps différents, et le fixture de régression les exerce tous les deux. Dans GF(64), le corps d'un symbole à six bits construit à partir du polynôme primitif $43, les mots 12 45 3 avec cinq mots de contrôle produisent 41 32 26 33 23 tandis que les trois premiers restent intacts. Dans GF(16), le corps du message de mode avec le polynôme primitif $13, les mots 5 9 produisent 11 15 6 8. Les deux passent par le hook HPDFAztecTestEncode contre ISO/IEC 24778
Pourquoi Data Matrix exige-t-il deux correctifs au lieu d'un ?
THPDFDataMatrix.ComputeEC empilait une seconde erreur indépendante par-dessus l'erreur partagée : il construisait le polynôme générateur avec des racines partant de α^0, alors qu'ISO/IEC 16022 Annexe E spécifie des racines depuis α^1. Corriger seulement l'index de division donne les mots de contrôle 146 107 90 179 128 pour l'exemple standard, qui ont l'air tout aussi plausibles que les bons et restent illisibles. Les deux défauts devaient disparaître avant que les nombres ne correspondent
// THPDFDataMatrix.ComputeEC dans HPDFDataMatrix.pas
Gen[0] := 1;
for I := 0 to ECCount - 1 do
begin
  // DMExp[I + 1] : les racines vont de alpha^1 à alpha^ECCount, pas depuis alpha^0
  for J := ECCount downto 1 do
    Gen[J] := GFMul(Gen[J], DMExp[I + 1]) xor Gen[J - 1];
  Gen[0] := GFMul(Gen[0], DMExp[I + 1]);
end;
Le point de référence est assez petit pour tenir dans un commentaire. La chaîne '123456' s'encode en mots de code ASCII 142 164 186, un symbole 10x10 porte cinq mots de contrôle, et le bloc correct est 114 25 5 88 102. HPDFDataMatrixTestComputeEC expose la fonction de classe derrière la porte {$IFDEF HPDF_TESTING}, donc le fixture asserte ces cinq valeurs sans instancier d'encodeur ni rendre de page. Le corps de Galois lui-même, construit par InitDMTables sur le polynôme primitif $12D dans les tables DMExp et DMLog, était correct depuis le début, et c'est exactement pourquoi le bug se cachait si bien
PDF417 divise sur un corps premier, où les signes comptent
PDF417 exigeait quatre changements plutôt qu'un, parce que GF(929) est un corps premier et pas un corps d'extension binaire : l'addition n'est pas un xor, la soustraction n'est pas une addition, et le signe de chaque facteur du générateur est de la vraie arithmétique plutôt que de la notation. Chaque facteur doit être (x - 3^i), ce qui en code signifie multiplier par 929 - GF929Pow(3, I) ; l'étape de réduction doit soustraire ; les racines vont depuis 3^1 selon ISO/IEC 15438 §5.5 ; et Factor doit être recopié dans une variable locale avant que la boucle interne ne s'exécute, parce que le passage J = 0 écrit Work[I] et changerait sinon le multiplicateur sous ses pieds. HPDFPDF417TestComputeEC épingle le résultat corrigé : les mots de code 5 453 178 121 239 avec quatre mots de correction d'erreurs donnent 452 327 657 619
// THPDFPDF417.ComputeEC dans HPDFPDF417.pas
for I := 1 to ECCount do
begin
  Root := (929 - GF929Pow(3, I)) mod 929;   // le facteur est (x - 3^i)
  for J := ECCount downto 1 do
    Gen[J] := (GF929Mul(Gen[J], Root) + Gen[J - 1]) mod 929;
  Gen[0] := GF929Mul(Gen[0], Root);
end;
// ...
Factor := Work[I];                          // à verrouiller : J = 0 réécrit Work[I]
if Factor = 0 then
  Continue;
for J := 0 to ECCount do
  Work[I + J] := (Work[I + J] + 929 - GF929Mul(Gen[ECCount - J], Factor)) mod 929;
Le motif de détection de Data Matrix était installé à l'envers
Des mots de contrôle corrects ne sauvent pas un symbole dont le motif de détection est en miroir, et la même version a dû corriger cela aussi. Le code de placement dessinait une colonne gauche pleine, une colonne droite pleine et des modules alternés le long des rangées du haut et du bas, alors qu'ISO/IEC 16022 §5.2 demande une colonne gauche pleine plus une rangée du bas pleine, le finder en forme de L, avec la piste d'horloge alternée le long de la rangée du haut et de la colonne de droite. Ce qui rend ce défaut facile à prendre à l'envers, c'est la convention de coordonnées : HotPDF rend les rangées de modules à Y + I * ModuleSize, ce qui est la sémantique d'origine en haut à gauche, donc Modules[Size - 1, *] est la rangée du bas du symbole imprimé. Quiconque raisonne dans l'espace utilisateur PDF, où Y croît vers le haut, met la jambe pleine du mauvais côté et ne voit rien de suspect à l'écran
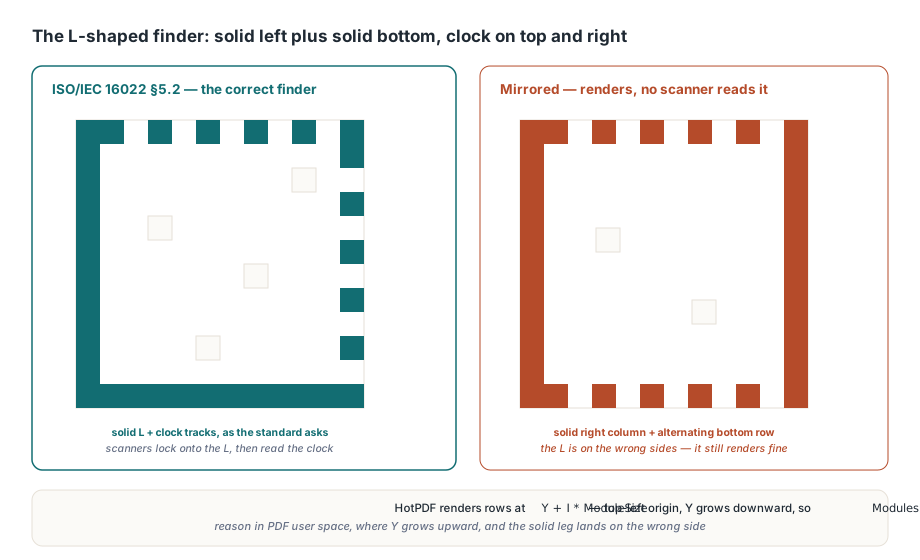
Pourquoi quatre encodeurs cassés ont-ils passé les tests pendant des années ?
Parce que les tests assertaient la structure et que les défauts étaient dans l'arithmétique. Les cas QR, Data Matrix et Aztec existants vérifiaient les modules de détection, les patterns de timing et les dimensions des symboles, qui étaient tous réellement corrects ; aucun test n'avait jamais comparé un mot de contrôle à un vecteur publié. La seconde raison se généralise plus loin. HotPDF embarque un décodeur QR intégré, et l'utiliser pour valider l'encodeur ressemble à un aller-retour évident, sauf que ce décodeur lit les mots de code de données sans faire aucune correction Reed-Solomon, donc il relisait exactement ce que l'encodeur avait écrit et rapportait un succès. Quand un encodeur et un décodeur partagent une hypothèse, un test d'aller-retour prouve qu'ils sont d'accord, pas que l'un des deux a raison. Un code correcteur d'erreurs doit être validé contre des vecteurs imprimés dans la norme, jamais contre votre propre décodeur. Le fixture THPDFBarcodeECCTests contient maintenant un test par format, chacun nommé d'après ce qu'il épingle, et chacun atteignant l'arithmétique par un hook compilé seulement sous {$IFDEF HPDF_TESTING} :
QRCheckWordsMatchISO18004Exampleasserte les dix mots de contrôle de l'exemple en mode octets version 1-MDataMatrixCheckWordsMatchISO16022Exampleasserte 114 25 5 88 102 pour les mots de code 142 164 186PDF417CheckWordsMatchGF929Referenceasserte 452 327 657 619 sur GF(929) avec les racines de 3^1 à 3^4AztecCheckWordsKeepMessageAndMatchReferenceasserte les mots de contrôle et le fait que les mots du message survivent à la division en place
Quatre questions attrapent l'essentiel de cette famille dans n'importe quel encodeur que vous maintenez. Votre ordre de stockage du générateur correspond-il à votre ordre d'index de division, et pouvez-vous pointer la ligne qui le prouve ? Les racines partent-elles là où la norme le dit, α^1 pour Data Matrix et 3^1 pour PDF417 ? Une division en place restaure-t-elle la zone du message ensuite ? Au moins un test compare-t-il des mots de contrôle, plutôt que des comptages de modules, à un nombre imprimé dans une spécification ? Le périmètre compte aussi quand vous décidez quoi faire des artefacts existants. Les symboles générés avant v2.748.0 se rendent et se scannent souvent dans des conditions idéales, parce qu'une image propre n'a besoin d'aucune correction pour être lue ; ce qu'ils ont perdu, c'est la tolérance aux dégâts, la raison même de choisir ces formats. Les étiquettes durables et les documents archivés portant des symboles affectés méritent d'être régénérés plutôt que contrôlés au hasard avec l'appareil photo d'un téléphone. Les encodeurs vivent dans le support des codes-barres de HotPDF, aux côtés du chemin de décodage QR et de sa gestion des orientations et de la couche de sortie de rapports qui place les symboles sur une page ; la référence complète de l'API des codes-barres est livrée avec le HotPDF Delphi Component pour Delphi et C++Builder