Un PDF qui s'ouvre instantanément depuis un disque local peut mettre plusieurs secondes à montrer sa première page quand les mêmes octets viennent d'un serveur HTTP qui répond à des requêtes de plages, alors même que le fichier ne fait que quelques mégaoctets et que la liaison est rapide. La bande passante n'est pas le problème. C'est le compte de requêtes, et le remède consiste à transformer des centaines de minuscules lectures dispersées en quelques dizaines de blocs en cache, puis à ne lire en anticipé que tant que le motif d'accès reste séquentiel
Pourquoi le même PDF se charge-t-il instantanément depuis le disque et rampe-t-il sur HTTP ?
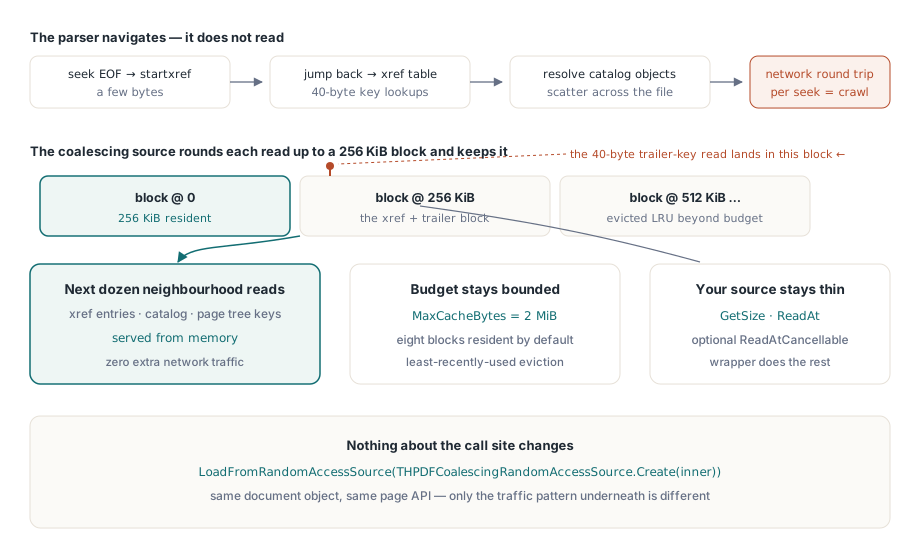
Un analyseur PDF ne lit pas un fichier de haut en bas. Il s'y déplace. La structure d'ISO 32000-1 §7.5 place le point d'entrée à la fin : le parseur saute au dernier kilooctet pour startxref, rebondit vers la table des références croisées, résout le dictionnaire trailer, suit une référence vers le Catalog, puis vers la racine de l'arbre de pages, puis vers un nœud de page, puis vers le dictionnaire de ressources de cette page. Chaque saut lit des dizaines d'octets à un décalage différent, et un fichier à mises à jour incrémentales refait la promenade une fois par révision à travers la chaîne /Prev
Sur un fichier local, ce motif coûte presque rien, car le système d'exploitation tient déjà la page de 4 Kio environnante dans son cache fichier et la seconde lecture coûte une copie mémoire. Un transport réseau n'a pas cette localité. Chaque lecture devient une requête avec sa propre latence, et l'arithmétique est brutale : à 40 ms par aller-retour, 300 petites lectures s'accumulent en douze secondes d'attente pendant que le fil reste surtout inactif. Lire moins n'est pas une option, puisque le parseur exige exactement les octets qu'il demande. Ce qui peut changer, c'est la quantité que chaque requête physique rapporte
Enrober votre transport dans THPDFCoalescingRandomAccessSource
HotPDF charge les documents depuis toute classe descendant de THPDFRandomAccessSource, et THPDFCoalescingRandomAccessSource s'intercale entre cette classe et le parseur. Chaque lecture est arrondie à un bloc aligné et le bloc est gardé en mémoire. BlockSize vaut 262 144 octets par défaut et MaxCacheBytes 2 097 152, donc huit blocs restent résidents et le moins récemment utilisé part quand le budget est plein. La recherche de 40 octets d'une clé de trailer du parseur tire dans les 256 Kio alentour, et la douzaine de lectures suivantes dans ce voisinage (entrées de références croisées, Catalog, clés d'arbre de pages) sortent de la mémoire
Votre propre classe reste mince. Deux méthodes sont obligatoires : GetSize et ReadAt. Surchargez ReadAtCancellable quand votre client HTTP peut avorter une requête en vol, et surchargez IsRangeAvailable quand la source est un téléchargement encore en cours. Le wrapper pose cette question avant chaque rapport : si un bloc entier n'est pas encore là, il réessaie avec les seuls octets demandés, et si ceux-là manquent aussi la lecture revient courte au lieu de bloquer
type
  // TMyHttpClient représente votre propre classe de client HTTP
  THttpRangeSource = class(THPDFRandomAccessSource)
  private
    FClient: TMyHttpClient;
    FUrl: string;
    FSize: Int64;
  public
    constructor Create(const AUrl: string);
    function GetSize: Int64; override;
    function ReadAt(Offset: Int64; var Buffer; Count: Longint): Longint; override;
    function ReadAtCancellable(Offset: Int64; var Buffer; Count: Longint;
      CancellationToken: THPDFCancellationToken): Longint; override;
  end;

var
  Raw: THttpRangeSource;
  Cached: THPDFCoalescingRandomAccessSource;
  Pdf: THotPDF;
begin
  Raw := THttpRangeSource.Create('https://files.example.com/contract.pdf');
  // OwnsSource=True : le wrapper libère Raw ; blocs de 256 Kio, budget de 8 Mio
  Cached := THPDFCoalescingRandomAccessSource.Create(Raw, True, 262144, 8388608);
  Cached.MaxReadAheadBlocks := 8;   // plage valide 1..32
  Pdf := THotPDF.Create(nil);
  try
    // OwnsSource=True encore : Pdf libère Cached, qui libère Raw
    if Pdf.LoadFromRandomAccessSource(Cached, True) > 0 then
      RenderFirstPage(Pdf);   // votre propre code
  finally
    Pdf.Free;
  end;
end;
La prélecture asynchrone et la lecture anticipée adaptative sont toutes deux actives dès la construction du wrapper, donc l'exemple ne touche que le plafond de fenêtre. Le constructeur valide ses arguments d'emblée : BlockSize doit se trouver entre 4 096 et 16 777 216 octets et MaxCacheBytes doit tenir au moins un bloc, sinon vous recevez un ERangeError avant qu'un seul octet ne bouge
Vous n'avez pas strictement besoin du wrapper explicite. Passez à LoadFromRandomAccessSource une source ordinaire et HotPDF l'enrobe pour vous, avec la politique de cache brut que vous pouvez lire et changer via GetCacheAdmissionPolicy et SetCacheAdmissionPolicy pour la couche clkRawCompressed : huit entrées, 2 Mio au total, 256 Kio par entrée. Passez votre propre THPDFCoalescingRandomAccessSource et il est utilisé exactement tel que configuré. Pour tout ce qui traverse un réseau, construisez le wrapper vous-même ; vous obtenez les molettes de lecture anticipée et l'enregistrement complet de statistiques, tandis que le chemin automatique ne rapporte que les comptes de hit, miss, admission et éviction via GetCacheAdmissionStatistics
Jusqu'où faut-il lire à l'avance ?
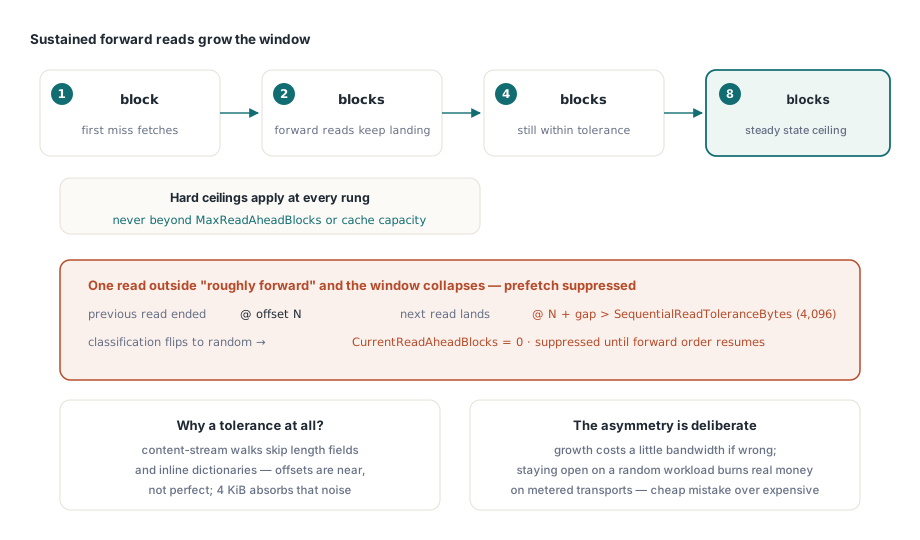
La lecture anticipée adaptative décide par document. Avec AdaptiveReadAheadEnabled posé, chaque lecture que le parseur fait à travers le document chargé est classée séquentielle ou aléatoire, et la fenêtre de prélecture suit un score. Deux lectures avant consécutives ouvrent la fenêtre à deux blocs, quatre l'ouvrent à quatre, six l'ouvrent à huit. La fenêtre ne dépasse jamais MaxReadAheadBlocks, et elle ne dépasse jamais le nombre de blocs qui tiennent dans MaxCacheBytes, donc un petit cache ne peut pas être inondé par sa propre prélecture
Une lecture qui saute en arrière, ou atterrit trop loin après la fin de la lecture précédente, fait tomber le score sous zéro. La fenêtre se ferme, toute prélecture qui se dirige ailleurs est annulée, et SuppressedPrefetchCount monte. Deux lectures avant plus tard, la fenêtre se rouvre à un seul bloc. Ce retard est le but : une lecture contiguë chanceuse au milieu d'une chasse aux références croisées ne relance pas la spéculation
SequentialReadToleranceBytes, 4 096 par défaut, définit « trop loin ». Un parseur qui parcourt un flux de contenu ne produit pas des décalages parfaitement contigus ; il saute un champ de longueur ici, un dictionnaire d'image inline là. Les lectures qui atterrissent dans la tolérance de la fin précédente comptent encore comme avant. Posez-le trop bas et un balayage avant normal est classé aléatoire, donc la lecture anticipée ne s'enclenche jamais. Posez-le trop haut et un accès réellement aléatoire paraît séquentiel, et vous rapportez des mégaoctets que personne ne lit. Le setter accepte toute valeur de zéro jusqu'à BlockSize et remet le score à zéro quand il change
La croissance est graduelle, l'effondrement est immédiat, et cette asymétrie est délibérée. Trop rapporter sur une charge aléatoire brûle de la vraie bande passante, et sur un transport mesuré de l'argent réel ; trop peu rapporter sur une charge séquentielle coûte quelques aller-retours de plus. Laissez AdaptiveReadAheadEnabled allumé. Éteint, le wrapper prélit un bloc après chaque lecture quel que soit le motif, exactement le mauvais comportement pendant que le parseur saute entre sections de références croisées
La classification est pilotée par le flux depuis lequel HotPDF lit pendant un chargement. Si votre propre code tire aussi des octets à travers le wrapper, par exemple pour hacher un fichier ou extraire une pièce jointe, appelez ObserveReadPattern avec le décalage et la longueur après chaque lecture pour que la fenêtre réagisse à ce trafic aussi. Quand vous savez déjà quels octets seront voulus ensuite, PrefetchRange démarre directement un rapport en arrière-plan ; IsPrefetchActive dit si l'un tourne encore
Garder les blocs chauds quand le cache est plein
L'éviction la-plus-récemment-utilisée ordinaire a une faiblesse connue. Une longue passe avant, disons à travers une grande image embarquée, pousse dehors chaque bloc vers lequel le parseur revient sans cesse, y compris les blocs de références croisées et de Catalog dont il aura encore besoin à la page suivante. THPDFCoalescingRandomAccessSource compte combien de fois chaque bloc a été demandé, et une fois le budget plein, un nouveau bloc n'entre dans le cache que s'il a été demandé au moins aussi souvent que le bloc qu'il remplacerait. Sinon la lecture va droit à votre source pour exactement les octets demandés, et RejectionCount et FrequencyRejectionCount l'enregistrent
Cette règle est active par défaut (l'argument de constructeur AdaptiveAdmission). ConfigureCacheAdmission change le budget d'octets, le plafond par entrée, une limite optionnelle de compte d'entrées et la règle d'admission sur un wrapper vivant ; il annule toute prélecture en cours et rogne le cache aux nouvelles limites sur-le-champ
Une annulation qui arrête réellement le transfert
La prélecture tourne sur un seul thread d'arrière-plan, et le wrapper l'annule dès qu'elle cesse de valoir la peine d'aller à son terme. Une lecture avant pour des octets hors de la plage en prélecture l'annule, donc la page demandée par l'utilisateur n'attend jamais derrière du trafic spéculatif. Une lecture aléatoire l'annule. Détruire le wrapper, ou appeler CancelPrefetch ou ClearCache, l'annule et attend la sortie du thread. Chacun de ces cas pose le THPDFCancellationToken que le thread de prélecture passe à votre ReadAtCancellable
Que les octets cessent réellement de couler dépend de votre surcharge. Le ReadAtCancellable par défaut sur THPDFRandomAccessSource consulte le token avant et après un ReadAt simple, ce qui suffit pour un partage de fichiers mais laisse une réponse HTTP de 256 Kio à moitié finie aller à son terme. Un client qui lit le corps de réponse par morceaux peut consulter le token entre morceaux et avorter :
function THttpRangeSource.ReadAt(Offset: Int64; var Buffer;
  Count: Longint): Longint;
begin
  Result := ReadAtCancellable(Offset, Buffer, Count, nil);
end;

function THttpRangeSource.ReadAtCancellable(Offset: Int64; var Buffer;
  Count: Longint; CancellationToken: THPDFCancellationToken): Longint;
var
  Status: Integer;
begin
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
  // GetRange et son callback sont l'API de votre client : il envoie
  // « Range: bytes=Offset-(Offset+Count-1) » et appelle le callback entre morceaux de corps
  Result := FClient.GetRange(FUrl, Offset, Count, Buffer, Status,
    function: Boolean
    begin
      Result := (CancellationToken <> nil) and
        CancellationToken.IsCancellationRequested;
    end);
  // 200 au lieu de 206 signifie que le serveur a ignoré Range et envoyé tout le fichier
  if Status <> 206 then
    raise EStreamError.CreateFmt('Range request not honored (HTTP %d)', [Status]);
  if CancellationToken <> nil then
    CancellationToken.ThrowIfCancellationRequested('http range read');
end;
Le contrôle de statut couvre le piège que la plupart des sources HTTP rencontrent d'abord. Le RFC 9110 §14 laisse un serveur ignorer un en-tête Range et répondre 200 avec la représentation complète, et certaines configurations de CDN et de proxy font exactement ça pour certains fichiers. Une source qui copie les premiers Count octets d'une réponse 200 remet au parseur des octets du décalage zéro quel que soit le décalage demandé. Les valeurs de retour comptent aussi : le wrapper lève EStreamError si ReadAt rapporte un compte négatif ou plus d'octets que demandés, et il traite zéro comme fin de données
Le seul token non nil que votre source reçoit appartient au thread de prélecture. Les lectures du parseur pendant un chargement atteignent votre ReadAtCancellable avec un token nil, donc arrêter le chargement lui-même est un autre interrupteur : affectez un token à THotPDF.OperationCancellationToken, et le chargement de document le consulte en chemin. Le même modèle de token pilote la file décrite dans le rendu en arrière-plan avec une file de requêtes, donc un viewer peut annuler un chargement, ses rendus et son trafic réseau spéculatif depuis un seul handler de fermeture
Lire les statistiques du cache de plages
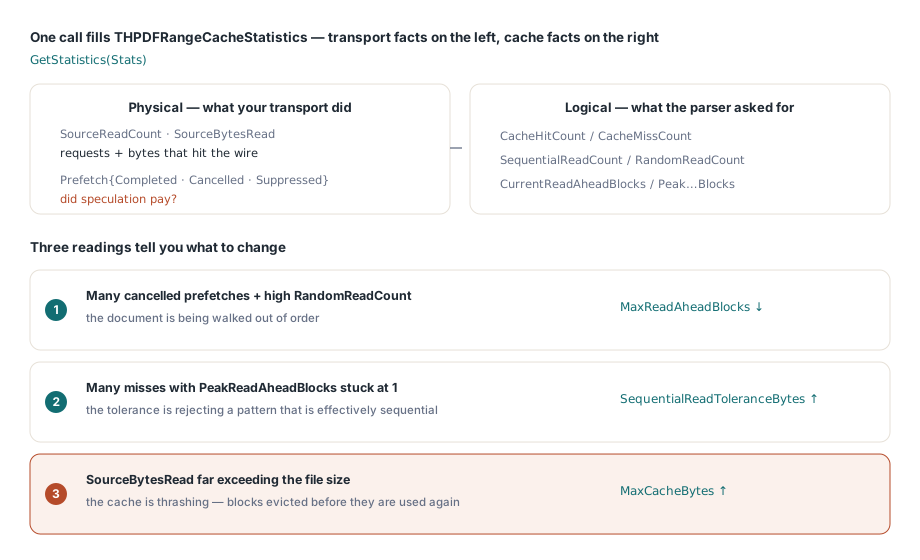
GetStatistics remplit un enregistrement THPDFRangeCacheStatistics qui sépare ce que votre transport a fait de ce que le cache a fait. SourceReadCount et SourceBytesRead sont le trafic physique. CacheHitCount et CacheMissCount sont le trafic logique. SequentialReadCount et RandomReadCount montrent comment le motif d'accès a été classé, CurrentReadAheadBlocks et PeakReadAheadBlocks montrent jusqu'où la fenêtre s'est ouverte, et les quatre compteurs de prélecture disent si la spéculation a payé. CachedRangeCount, CachedBytes, EvictionCount et RejectionCount décrivent le cache lui-même
var
  S: THPDFRangeCacheStatistics;
begin
  Cached.GetStatistics(S);
  Log(Format('physical %d reads / %d bytes, hits %d, misses %d',
    [S.SourceReadCount, S.SourceBytesRead, S.CacheHitCount, S.CacheMissCount]));
  Log(Format('pattern: %d sequential, %d random, peak window %d blocks',
    [S.SequentialReadCount, S.RandomReadCount, S.PeakReadAheadBlocks]));
  Log(Format('prefetch: %d issued, %d completed, %d canceled, %d suppressed',
    [S.PrefetchRequestCount, S.PrefetchCompletedCount,
     S.PrefetchCancelledCount, S.SuppressedPrefetchCount]));
  Log(Format('cache: %d blocks / %d bytes, %d evicted, %d rejected',
    [S.CachedRangeCount, S.CachedBytes, S.EvictionCount, S.RejectionCount]));

  // Rejets qui s'accumulent sur un document surtout séquentiel : donnez-lui plus de place
  if S.RejectionCount > S.CacheHitCount then
    Cached.ConfigureCacheAdmission(16 * 1024 * 1024, Cached.BlockSize, 0);
end;
Trois lectures vous disent quoi changer. Beaucoup de prélectures annulées à côté d'un compte élevé de lectures aléatoires signifient que le document est parcouru dans le désordre, donc abaissez MaxReadAheadBlocks et cessez de payer la bande passante que vous jetez. Beaucoup de manqués avec la fenêtre crête coincée à 1 signifient que la tolérance rejette un motif en réalité séquentiel, donc montez SequentialReadToleranceBytes. SourceBytesRead bien au-dessus de la taille du fichier signifie que des blocs sont évincés avant d'être réutilisés ; montez MaxCacheBytes avant de toucher à quoi que ce soit d'autre. Le seuil de rejet de l'exemple est notre propre heuristique de départ, alors calibrez-le sur votre trafic
Les fichiers linéarisés changent la donne
Si vous contrôlez le producteur, linéariser le document change le problème au lieu de le régler à la molette. L'annexe F d'ISO 32000-1 place les objets de la première page et une table d'indices en tête du fichier, donc un viewer peut rendre la page une depuis les octets d'ouverture sans toucher au reste. HotPDF expose ce chemin via GetProgressiveLinearizedLoadInfo et ReadProgressiveLinearizedFirstPageSection, qui prennent tous deux le même THPDFRandomAccessSource que vous enroberiez pour le regroupement ; le côté écriture est couvert dans la génération de PDF linéarisés avec tables d'indices
Les deux techniques se composent. Le regroupement rend n'importe quel document tolérable sur une liaison lente, y compris des fichiers de tiers que vous ne pouvez pas resauvegarder ; la linéarisation fait arriver la première page vite sur les documents que vous produisez vous-même. Les fichiers sur disque local trop gros pour tenir en mémoire sont un autre problème sans latence d'aller-retour à amortir, et les chemins de fichiers mappés et de flux paresseux de le flux de travail Direct File API leur conviennent mieux
Les classes de sources à accès aléatoire, le wrapper de regroupement, les politiques d'admission au cache et les appels de chargement linéarisé progressif sont tous livrés avec HotPDF, un composant PDF natif pour Delphi et C++Builder avec source complète. Licence et référence API complète sont sur la page du composant PDF HotPDF pour Delphi