Prenez un rapport de 400 pages qui incorpore une police de 2 Mo : facturer à chaque page tout ce qu'elle référence donne un total étrange. Les pages additionnent 800 Mo de police dans un fichier qui fait peut-être 30 Mo sur le disque. Répartissez la police uniformément et chaque page coûte environ 5 Ko : plus rien ne paraît coûteux, et la mémoire semble sortir de nulle part. Aucun des deux chiffres ne répond à la vraie question : combien d'octets serait-on susceptible de libérer si un objet donné disparaissait
Ce chiffre porte un nom en analyse de tas : la taille retenue (retained size), et la théorie des graphes offre une façon propre de la calculer. Un objet est facturé à son dominateur, l'objet le plus proche par lequel tout chemin partant de la racine doit passer pour l'atteindre. Les objets partagés remontent jusqu'à un nœud qui les possède réellement, les objets exclusifs restent en place, et les totaux s'additionnent sans double comptage
Taille superficielle, taille retenue et règle du dominateur dans HotPDF
HotPDF calcule cela pour un document chargé via THotPDF.BuildLoadedObjectDependencyGraph. L'appel renvoie un THPDFObjectDependencyNode par objet indirect chargé et un THPDFObjectDependencyEdge par référence indirecte, puis lance une analyse par dominateurs enracinée dans le Catalog du document, l'objet désigné par l'entrée /Root du trailer (ISO 32000-1 §7.7.2). Chaque nœud porte deux tailles. EstimatedShallowBytes est ce que l'objet coûte à lui seul. EstimatedRetainedBytes est son propre coût plus le coût superficiel de tous les objets qu'il domine
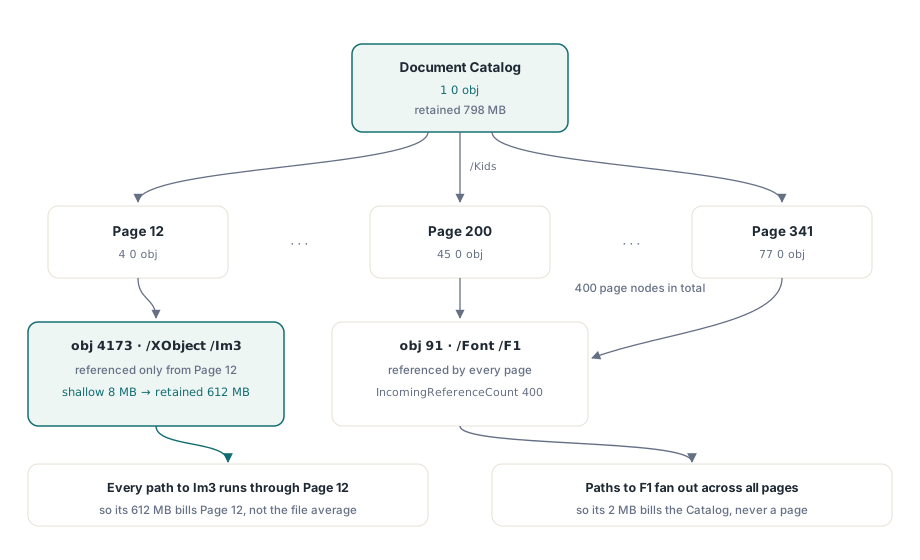
Revenons à la police. Chaque page la référence, donc aucune page seule ne la domine ; les chemins ne convergent qu'au nœud de l'arborescence de pages au-dessus de ces pages, qui dans un arbre plat est l'objet racine /Pages. Les 2 Mo de la police s'y déposent puis remontent jusqu'au Catalog. Un XObject image dessiné sur la page 12 et nulle part ailleurs est le cas inverse : tout chemin vers lui passe par la page 12, donc la taille retenue de la page 12 inclut toute l'image. Le haut de la liste retenue est donc une liste d'objets dont la suppression libérerait de la mémoire
La même arithmétique fournit gratuitement une contre-vérification. THPDFObjectDependencyGraphInfo.CatalogRetainedBytes est égal à la somme des tailles superficielles de tous les objets accessibles depuis le Catalog, et TotalEstimatedBytes à la somme des tailles superficielles de tous les objets chargés, accessibles ou non. L'écart entre les deux est la mémoire détenue par des objets que le document ne référence plus
Exécuter le graphe et lire un résultat en échec
La méthode ne renvoie True que lorsque l'analyse complète est arrivée à son terme, et c'est cette valeur de retour qu'il faut vérifier. Un résultat False remplit quand même l'enregistrement d'information, mais les tableaux ne servent alors à rien pour un rapport. Quand le nombre d'objets dépasse MaxObjects (250 000 par défaut), la méthode s'arrête avant de construire le moindre nœud et met ObjectCount à un de plus que la limite : vous apprenez que la limite était trop petite, pas combien le document est grand. Quand le budget d'arêtes (2 000 000 par défaut) ou la limite d'imbrication de 256 niveaux pour les objets directs est atteint pendant le balayage, les nœuds reviennent avec des tailles superficielles partielles et sans aucune taille retenue ni accessibilité
uses
  SysUtils, HPDFDoc;

procedure ProfileLoadedPdf(const FileName: string);
var
  Pdf: THotPDF;
  Nodes: THPDFObjectDependencyNodeArray;
  Edges: THPDFObjectDependencyEdgeArray;
  Info: THPDFObjectDependencyGraphInfo;
begin
  Pdf := THotPDF.Create(nil);
  try
    // LoadFromFile renvoie le nombre de pages ; 0 signifie que le chargement a échoué
    if Pdf.LoadFromFile(FileName) = 0 then
      Exit;

    // Limites relevées pour une analyse forensique hors ligne
    if not Pdf.BuildLoadedObjectDependencyGraph(Nodes, Edges, Info,
      1000000, 8000000) then
    begin
      // Log est votre propre routine de journalisation
      Log(Format('graph incomplete: %s (limit %s, invalid %s, objects %d)',
        [string(Info.Diagnostic), BoolToStr(Info.LimitExceeded, True),
         BoolToStr(Info.InvalidObjectGraph, True), Info.ObjectCount]));
      Exit; // ne classez ni n'additionnez pas un tableau de nœuds partiel
    end;

    Log(Format('%d objects, %d edges (%d unresolved), %d reachable',
      [Info.ObjectCount, Info.EdgeCount, Info.UnresolvedReferenceCount,
       Info.ReachableObjectCount]));
    Log(Format('estimated %d bytes, Catalog retains %d, unreachable %d',
      [Info.TotalEstimatedBytes, Info.CatalogRetainedBytes,
       Info.TotalEstimatedBytes - Info.CatalogRetainedBytes]));

    LogTopRetained(Nodes, Edges, 10);
  finally
    Pdf.Free;
  end;
end;
Deux autres indicateurs méritent un coup d'œil dans cette branche d'échec. InvalidObjectGraph est positionné quand l'objet Catalog est introuvable parmi les objets chargés, ou quand un objet direct s'avère se contenir lui-même, ce qui n'arrive qu'avec des fichiers malformés. LimitExceeded couvre aussi une analyse par dominateurs qui ne converge pas après 128 passes. Diagnostic explique chaque cas en une ligne. Passer zéro ou une valeur négative pour MaxObjects, ou un MaxEdges négatif, déclenche EArgumentOutOfRangeException au lieu de renvoyer False
Quand l'appel échoue sur une limite, jetez les tableaux et relancez avec des bornes plus grandes. Des tailles superficielles partielles ont l'air plausibles dans un journal et sont fausses exactement de la façon qui envoie les gens vers le mauvais objet. Ces bornes existent parce que le graphe a un coût propre : chaque arête stocke une chaîne Path, donc une exécution de huit millions d'arêtes alloue huit millions de petites chaînes en plus du document qu'elle mesure. Cela a sa place sur un chemin de diagnostic que quelqu'un déclenche volontairement
Que compte réellement EstimatedShallowBytes ?
EstimatedShallowBytes estime la mémoire résidente, pas les octets dans le fichier. Pour chaque objet, il ajoute la taille d'instance de l'objet analysé et de ses enfants directs, les emplacements détenus par les listes de dictionnaires et de tableaux, la longueur de chaque clé, nom et chaîne, et la charge utile d'un flux si cette charge est en RAM : un flux mémoire, ou un flux chargé paresseusement déjà lu en mémoire. Un flux dont les octets dorment toujours dans le fichier source, ou qui a été déversé vers un fichier temporaire, ne contribue que son overhead d'objet
Cela a une conséquence pratique. Un fichier riche en scans profilé juste après le chargement peut afficher des tailles retenues modestes pour ses images, car rien ne les a encore décodées. Lancez le graphe après l'étape qui a fait grossir le processus (rendu, extraction de texte, fusion) et les flux matérialisés apparaissent avec leur poids réel. Pour une vérification reproductible, profilez le même fichier deux fois, une fois juste après LoadFromFile et une fois après l'opération coûteuse, puis comparez les premières entrées
ObjectType est grossier. Il indique le type de valeur PDF, otStream ou otDictionary et ainsi de suite, donc une image, un programme de police et un flux de contenu de page se lisent tous comme otStream. L'arête entrante révèle le rôle. THPDFObjectDependencyEdge.Path enregistre où dans l'objet source la référence a été trouvée, en commençant par $, avec /Key pour les entrées de dictionnaire, [n] pour les éléments de tableau et /dictionary pour le dictionnaire d'un flux. Un chemin $/Resources/XObject/Im3 depuis une page, ou $/XObject/Im3 depuis un dictionnaire de ressources séparé, signifie que l'objet sert de XObject nommé Im3 ; $/FontFile2 venant d'un descripteur de police signifie un programme TrueType incorporé ; $/Contents[0] signifie du contenu de page
// Votre propre fonction d'aide, hors de la bibliothèque : classe les Count
// premiers nœuds par taille retenue et affiche le chemin d'une référence entrante
procedure LogTopRetained(const Nodes: THPDFObjectDependencyNodeArray;
  const Edges: THPDFObjectDependencyEdgeArray; Count: Integer);
var
  Taken: array of Boolean;
  I, J, Best: Integer;
  Via: AnsiString;
begin
  SetLength(Taken, Length(Nodes));
  for I := 1 to Count do
  begin
    Best := -1;
    for J := 0 to High(Nodes) do
      if (not Taken[J]) and ((Best < 0) or
         (Nodes[J].EstimatedRetainedBytes >
          Nodes[Best].EstimatedRetainedBytes)) then
        Best := J;
    if Best < 0 then
      Break;
    Taken[Best] := True;

    Via := '(no incoming reference)';
    for J := 0 to High(Edges) do
      if Edges[J].Resolved and
         (Edges[J].TargetObjectNumber = Nodes[Best].ObjectNumber) and
         (Edges[J].TargetGenerationNumber = Nodes[Best].GenerationNumber) then
      begin
        Via := Edges[J].Path;
        Break;
      end;

    Log(Format('%d %d obj  shallow %d  retained %d  refs in %d  via %s',
      [Nodes[Best].ObjectNumber, Nodes[Best].GenerationNumber,
       Nodes[Best].EstimatedShallowBytes, Nodes[Best].EstimatedRetainedBytes,
       Nodes[Best].IncomingReferenceCount, string(Via)]));
  end;
end;
Un seul chemin entrant suffit à classer la plupart des objets. Pour un objet partagé, IncomingReferenceCount indique combien de références existent, et ImmediateDominatorObjectNumber avec son numéro de génération désigne l'objet qui le possède après l'analyse par dominateurs. Ce champ vaut -1 pour le Catalog et pour tout objet que le Catalog ne peut pas atteindre. Une arête dont l'indicateur Resolved est False pointe vers un numéro d'objet non chargé ; ces arêtes sont comptées dans UnresolvedReferenceCount, et un compte élevé sur un fichier par ailleurs sain signale généralement une section de références croisées endommagée
D'où viennent les objets inaccessibles ?
Un nœud avec ReachableFromCatalog à False est chargé et coûte de la mémoire, mais aucune chaîne de références depuis le Catalog n'y mène, donc rien dans la structure du document n'amène une visionneuse vers lui. Sa taille retenue égale sa taille superficielle, car l'analyse par dominateurs ne porte que sur les objets accessibles. Sommer EstimatedRetainedBytes sur les nœuds inaccessibles donne donc le même résultat que TotalEstimatedBytes - CatalogRetainedBytes
Les mises à jour incrémentielles sont une source courante, mais pas de la façon qu'on imagine spontanément. Quand une révision ultérieure redéfinit l'objet 2120, l'entrée de références croisées la plus récente gagne et l'ancienne définition n'est jamais chargée, donc les copies supplantées d'un même numéro d'objet n'apparaissent pas dans le graphe. Ce qui apparaît, c'est un objet qu'une révision ultérieure a simplement cessé de référencer : une annotation retirée d'un tableau /Annots réécrit, une image remplacée par un nouveau numéro d'objet, un champ de formulaire retiré de l'AcroForm. Rien dans l'ISO 32000-1 §7.5.6 n'oblige une mise à jour à marquer ces entrées comme libres, et tant que les données de références croisées les listent comme utilisées, le chargeur les traite comme des objets vivants. L'article sur les flux d'objets et les mises à jour incrémentielles détaille l'empilement des révisions
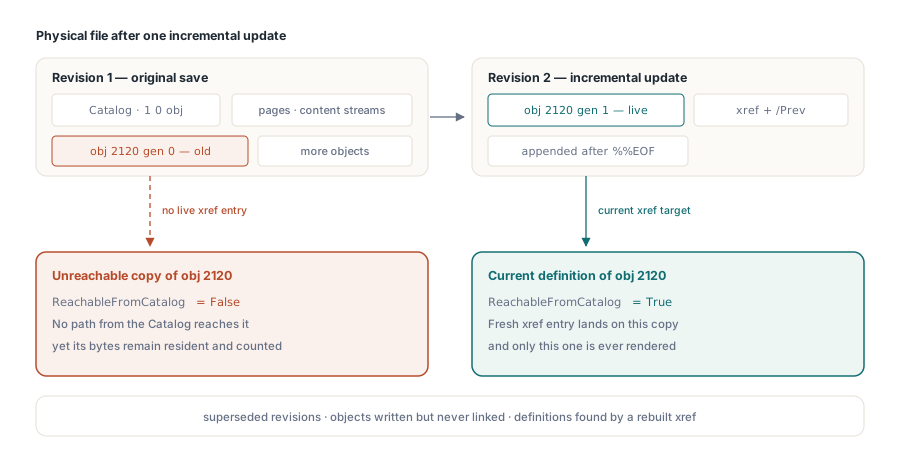
Les deux autres sources sont des producteurs qui écrivent des objets sans réussir à les lier ensuite, et des fichiers endommagés dont les données de références croisées ont dû être reconstruites par balayage, ce qui peut récupérer des définitions d'objets que rien ne référence. Quand une grande part du total estimé se trouve dans des nœuds inaccessibles, une réécriture propre du fichier vaut mieux qu'empiler encore une révision, et le graphe vous donne le décompte d'octets pour justifier la sauvegarde plus lente
Le parseur est-il celui qui retient la mémoire ?
Avant d'accuser le document, regardez comment le chargement lui-même s'est comporté. Deux appels décrivent le parseur plutôt que le contenu, et tous deux se réinitialisent au début de chaque LoadFromFile ou LoadFromStream, donc ils décrivent toujours le chargement le plus récent
GetLastParserArenaStatistics remplit un enregistrement THPDFParserArenaStatistics pour l'arène de blocs qui abrite les jetons et tampons éphémères pendant l'analyse. Les blocs font 64 KiB (BlockSize), et une allocation plus grande qu'un bloc reçoit un bloc à sa taille. AllocationCount moins ReusedAllocationCount égale BlockAllocationCount, le nombre de fois où l'arène a dû demander un nouveau bloc au gestionnaire de mémoire. Les blocs sont conservés toute la vie de l'instance THotPDF et libérés à sa destruction. Si une instance traite tout un lot, RetainedBytes reflète à peu près le plus grand espace de travail dont un fichier du lot a eu besoin, ce qui explique un plateau qui dure jusqu'à la libération du composant. TemporaryObjectElisionCount compte les clés de dictionnaire lues directement dans l'arène au lieu d'être construites comme objets nom temporaires
GetDocumentStringInternStatistics décrit le pool propre au document qui déduplique les noms PDF, les opérateurs de flux de contenu et les chaînes courtes. Les chaînes de 1 à 64 octets sont éligibles. Le pool garde au plus 65 536 entrées et 4 Mio, et ces plafonds reviennent dans l'enregistrement sous MaxStringLength, MaxEntryCount et MaxRetainedBytes. Une chaîne vide, plus longue que 64 octets, ou nouvelle alors que le pool est plein, est comptée dans BypassCount et conservée comme chaîne ordinaire. Un fichier qui produit des quantités énormes de noms uniques coûte donc à peu près ce qu'il coûterait sans le pool, et pas plus
var
  Arena: THPDFParserArenaStatistics;
  Intern: THPDFDocumentStringInternStatistics;
begin
  if Pdf.GetLastParserArenaStatistics(Arena) then
    Log(Format('arena: %d blocks, %d bytes held, peak %d, ' +
      '%d new blocks for %d allocations, %d tokens',
      [Arena.RetainedBlockCount, Arena.RetainedBytes, Arena.PeakUsedBytes,
       Arena.BlockAllocationCount, Arena.AllocationCount, Arena.TokenCount]));

  if Pdf.GetDocumentStringInternStatistics(Intern) then
  begin
    Log(Format('intern: %d of %d requests hit, %d bypassed, %d bytes reused',
      [Intern.HitCount, Intern.RequestCount, Intern.BypassCount,
       Intern.ReusedBytes]));
    // Votre propre vérification, pas un appel de la bibliothèque : pool à plafond
    if (Intern.EntryCount >= Intern.MaxEntryCount) or
       (Intern.RetainedBytes + Intern.MaxStringLength >
        Intern.MaxRetainedBytes) then
      Log('intern pool at its cap: later strings were not deduplicated');
  end;
end;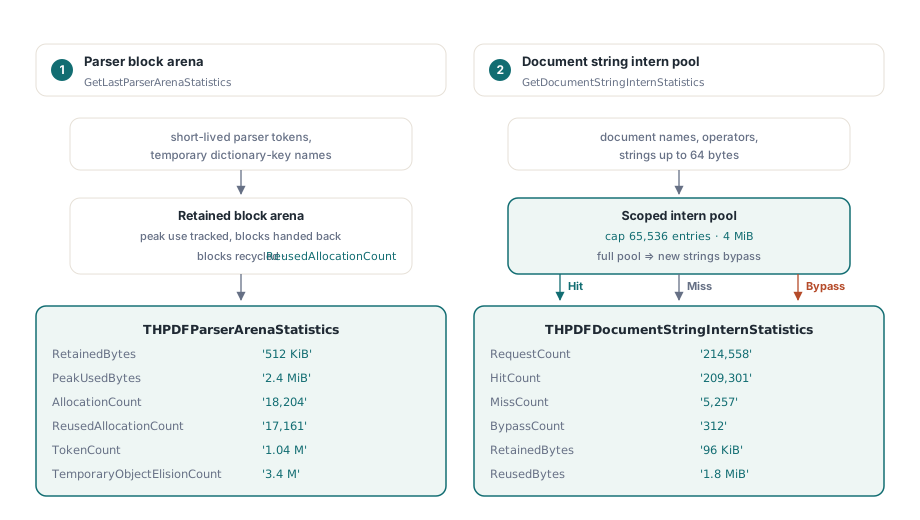
Les PDF typiques répètent un petit vocabulaire de noms et d'opérateurs, donc HitCount reste proche de RequestCount et ReusedBytes grandit avec le nombre de pages. Un BypassCount qui approche RequestCount sur un fichier modeste est inhabituel. Sur un chemin d'entrée pour des téléversements non fiables, consignez-le
Un ordre de triage face à une plainte mémoire
Commencez par CatalogRetainedBytes. S'il est proche de la croissance que vous avez mesurée dans le processus, la mémoire est dans le document et le haut de la liste retenue la nommera. S'il est bien en dessous, la mémoire vit quelque part que le graphe ne mesure pas : vos propres caches, bitmaps rendus ou arène du parseur, et l'enregistrement d'arène est la prochaine chose à lire
- Classez les nœuds par
EstimatedRetainedByteset lisez lePathentrant des dix premiers. Des cibles XObject en tête pointent généralement vers du contenu riche en scans où le sous-échantillonnage paie ; des cibles/FontFile,/FontFile2ou/FontFile3pointent vers des programmes de polices complets incorporés là où des sous-ensembles auraient suffi ; de gros flux/Contentsviennent généralement de sorties vectorielles générées, cartes ou exports CAO - Retranchez
CatalogRetainedBytesdeTotalEstimatedBytes. Un gros reste signifie des objets échoués, donc la correction appartient à l'étape de sauvegarde - Lisez les enregistrements d'arène et d'internement en dernier. Ils expliquent rarement des gigaoctets, mais ils expliquent bien un processus qui reste volumineux après fermeture de tous les documents
Suivez ces étapes dans cet ordre. La première règle la plupart des plaintes, et pour les très gros documents la réponse structurelle consiste souvent à cesser de garder tout le graphe d'objets en mémoire d'un coup, c'est exactement ce pour quoi le flux de travail de l'API fichier directe est conçu
Ces trois diagnostics sont de simples appels de méthodes renvoyant des enregistrements ordinaires, donc ils se glissent dans la journalisation ou la télémétrie qu'une application Delphi ou C++Builder possède déjà. HotPDF se livre sous forme de composant VCL natif avec le code source complet ; la documentation et une version d'essai sont sur la page HotPDF Delphi PDF component