HotPDF fait faire des allers-retours aux valeurs de list box multi-sélection à travers FDF et XFDF en gardant la valeur du champ comme tableau de bout en bout. Depuis la version 2.755.0, ExportLoadedFormToFDF, ExportLoadedInterchangeToFDF et ExportLoadedFormToXFDF écrivent chaque option sélectionnée comme sa propre chaîne FDF ou élément <value> XFDF, et les méthodes d'import correspondantes vérifient chaque valeur contre les options du champ et reconstruisent les indices de sélection /I avant de changer quoi que ce soit. Rien ne se fait coller en une seule chaîne en route
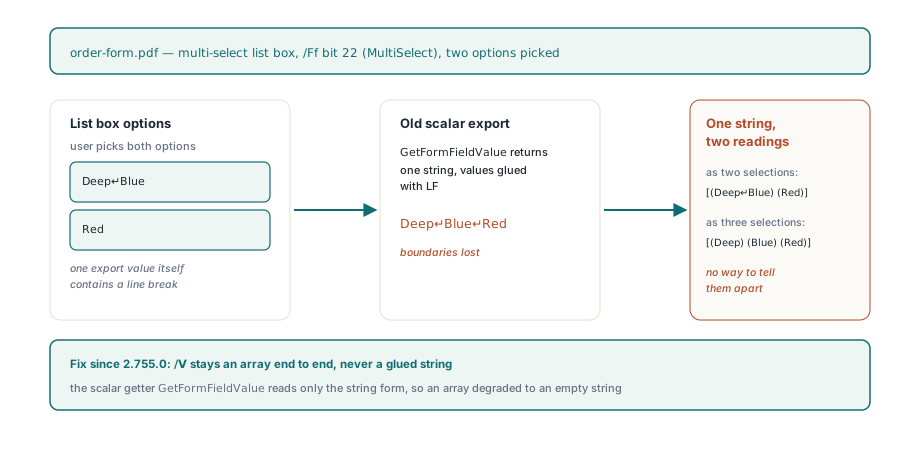
L'échec corrigé ici est facile à reproduire. Prenez un bon de commande avec une list box multi-sélection d'options produit, laissez un utilisateur en choisir deux, exportez les données du formulaire pour un système back-office, puis réimportez le fichier édité dans le PDF. Avant ce changement, la list box revenait vide ou fausse. La raison, c'est que l'une des valeurs d'export contenait un retour à la ligne, et l'ancien chemin avait aplati les sélections en une unique chaîne séparée par des lignes. Sortir plusieurs sélections de cette chaîne n'a jamais été fiable, et avec une valeur d'export qui contient elle-même un retour à la ligne, cela ne peut pas marcher du tout
Pourquoi coller des valeurs multi-sélection avec des retours à la ligne casse-t-il l'aller-retour ?
Coller les sélections en une seule chaîne jette les frontières entre valeurs, et une valeur peut contenir le séparateur, donc aucun importateur ne peut redécouper la chaîne correctement. ISO 32000-1 §12.7.4.4 permet à l'entrée /V d'un champ de choix d'être une chaîne de texte unique ou un tableau de chaînes de texte, et une list box avec le drapeau MultiSelect (bit 22 de /Ff) utilise la forme tableau dès que plus d'une option est choisie. La même section définit /I comme un tableau d'indices d'options à base zéro en ordre croissant, ce que les lecteurs emploient pour distinguer deux options qui partagent par hasard une valeur d'export. Dans HotPDF, le getter scalaire GetFormFieldValue ne lit que la forme chaîne, donc faire passer un tableau par lui dégradait l'export en chaîne vide, et l'ancien import XFDF collait les éléments <value> répétés avec LF. Imaginez une option exportée Deep, saut de ligne, Blue : après collage, Deep\nBlue\nRed peut être deux sélections ou trois, et le fichier ne donne aucun moyen de savoir lequel. Le correctif a été d'arrêter complètement d'utiliser un scalaire au milieu de l'aller-retour
Que contiennent les fichiers FDF et XFDF exportés ?
HotPDF écrit une valeur multi-sélection comme tableau typé en FDF et comme un élément <value> par sélection en XFDF, si bien que les frontières restent visibles sur disque. En FDF, chaque item garde l'orthographe qu'il avait dans le PDF source : les chaînes hexadécimales sortent en hex, et les chaînes littérales sont échappées par un unique helper qui transforme CR et LF en \r et \n. En XFDF, la racine porte xml:space="preserve" comme ISO 19444-1 l'exige, ce qui veut dire que tout blanc à l'intérieur d'un élément texte compte comme donnée. HotPDF écrit donc la balise ouvrante, le texte échappé et la balise fermante de chaque <value> d'un seul tenant, garde l'indentation hors de l'élément, et encode CR, LF et TAB en références de caractères pour qu'un analyseur XML appliquant la normalisation des fins de ligne ne puisse pas changer les octets d'origine
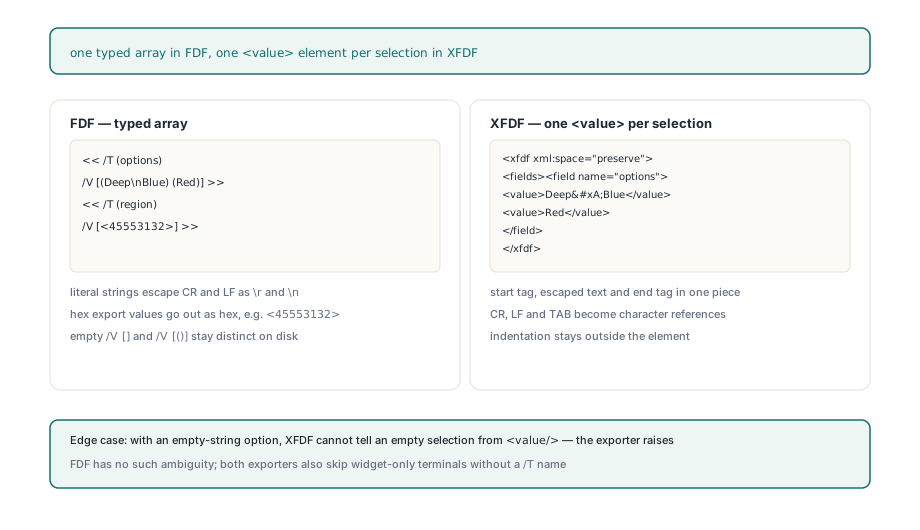
<!-- FDF : un tableau typé par champ -->
<< /T (options) /V [(Deep\nBlue) (Red)] >>
<< /T (region) /V [<45553132>] >>
<!-- XFDF : un <value> par sélection -->
<xfdf xmlns="http://ns.adobe.com/xfdf/" xml:space="preserve">
<fields>
<field name="options">
<value>Deep
Blue</value>
<value>Red</value>
</field>
</fields>
</xfdf>Deux cas limites d'export valent d'être connus avant d'écrire le code appelant. D'abord, ExportLoadedFormToFDF bâtit tout le corps FDF en mémoire avant de créer le fichier cible (corrigé en 2.755.1), donc une valeur non exportable, comme un tableau contenant autre chose que des chaînes, lève sans tronquer un fichier existant. Ensuite, une sélection vide sur une list box qui offre aussi une valeur d'export chaîne vide est ambiguë en XFDF, parce que <value/> peut signifier que rien n'est sélectionné ou que l'option vide est sélectionnée. ExportLoadedFormToXFDF lève dans ce cas plutôt que de deviner, et il lève avant que le fichier cible soit ouvert. Le FDF n'a pas cette ambiguïté, puisque /V [] et /V [()] sont distincts. Les deux exporteurs FDF sautent aussi les terminaux widget seul sans nom /T, à l'instar de l'exporteur XFDF, parce qu'aucun importateur ne pourrait jamais rattacher ces entrées à un champ
var
  Pdf: THotPDF;
  Written: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('order-form.pdf', '') > 0 then
    begin
      // Les list box multi-sélection sont écrites en /V [(...) (...)]
      Written := Pdf.ExportLoadedFormToFDF('order-form.fdf');
      try
        Pdf.ExportLoadedFormToXFDF('order-form.xfdf');
      except
        on E: Exception do
          // Sélection vide plus option d'export vide : le XFDF ne peut pas
          // les distinguer, et le fichier .xfdf existant reste intact
          ShowMessage('XFDF export refused: ' + E.Message);
      end;
    end;
  finally
    Pdf.Free;
  end;
end;
Comment HotPDF valide-t-il une valeur multi-sélection à l'import ?
HotPDF n'accepte un tableau importé que si la cible est un champ de choix avec le drapeau MultiSelect positionné et si chaque valeur du tableau correspond à une valeur d'export du tableau /Opt du champ. Chaque case d'option ne sert qu'une fois, donc une liste de deux options partageant la valeur d'export b accepte [<62> <62>] comme deux sélections distinctes et rejette un troisième b. Le /I reconstruit suit l'ordre de /Opt et pas celui des valeurs entrantes, puisque §12.7.4.4 exige des indices croissants. HotPDF bâtit le nouveau /V et le nouveau /I comme objets détachés et ne les affecte qu'après que chaque valeur a passé la validation, si bien qu'une valeur rejetée ne laisse jamais derrière elle un demi-tableau ni des indices périmés. La copie est écrite vers le champ importé plutôt que dans un tableau d'ancêtre partagé, les orthographes hexadécimales arrivant du FDF restent hex jusqu'à la sauvegarde, et les champs dont les calculs dépendent de la list box sont marqués pour recalcul. Si vous n'avez besoin que de poser une seule valeur, poser une valeur de champ de formulaire dans un PDF chargé passe par le chemin scalaire, qui ne gère par conception pas les sélections multiples
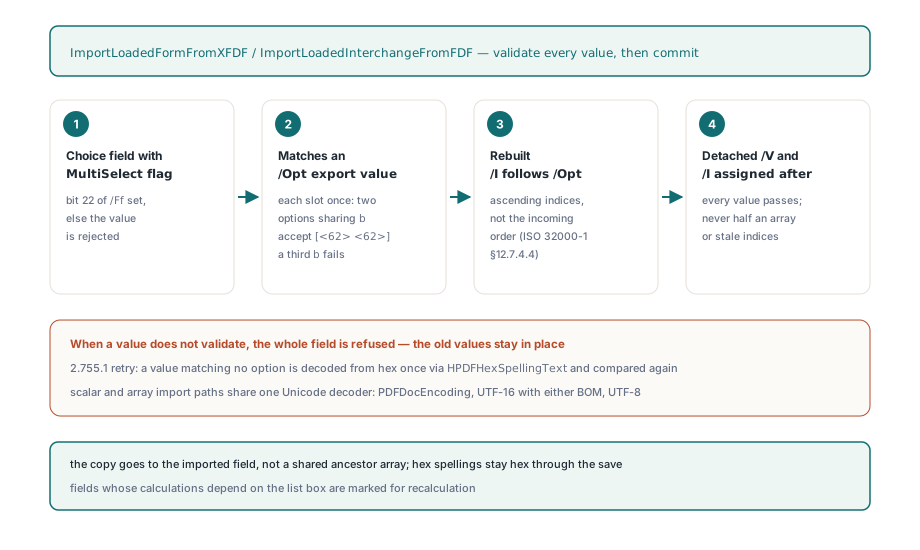
Certains autres outils écrivent des valeurs d'export ASCII simples comme chaînes hexadécimales sans marque d'ordre des octets, par exemple <416272>, puis exportent le XFDF en écrivant ces chiffres hexadécimaux comme texte. Une comparaison littérale stricte au retour échoue, et l'import abandonne. La version 2.755.1 ajoute une relance : quand une valeur ne correspond à aucune option, HPDFHexSpellingText décode le texte comme charge hexadécimale et compare le résultat à nouveau. La relance ne s'applique qu'à une entrée qui aurait levé sinon, donc elle ne change jamais une valeur qui correspondait déjà. La même version a aussi fait utiliser le même décodeur Unicode aux chemins scalaire et tableau, qui comprend PDFDocEncoding, UTF-16 avec l'une ou l'autre marque d'ordre des octets et UTF-8. Avant, une même valeur logique pouvait correspondre sur un chemin et échouer sur l'autre dans des documents qui mélangeaient les encodages
Pourquoi un fichier FDF valide peut-il encore perdre des champs pendant l'analyse ?
Un analyseur FDF qui ne suit pas les chaînes hexadécimales peut couper un dictionnaire de champ en deux quand une valeur hexadécimale se termine juste à côté du terminateur du dictionnaire. Dans << /T (region) /V <416273>>>, le premier > ferme la chaîne hexadécimale, mais un analyseur naïf le lit avec le > suivant comme la fin du dictionnaire et abandonne le champ en silence. L'importateur FDF au niveau fichier suivait déjà s'il se trouvait dans une chaîne hexadécimale, et en 2.755.1 les analyseurs de tableau et de dictionnaire derrière ImportLoadedInterchangeFromFDF font de même. Un second point concerne les références indirectes. Un fichier FDF est un petit document de syntaxe PDF avec sa propre numérotation d'objets (ISO 32000-1 §12.7.7), donc une valeur telle que /V [11 0 R] désigne l'objet 11 du fichier FDF, pas l'objet 11 du PDF que vous remplissez. L'analyseur FDF simplifié de HotPDF ne résout pas les références à l'intérieur du fichier, donc il rejette un tel tableau au lieu de lire ce que l'objet 11 est par hasard dans le document cible
Les imports fichier, flux et XFDF rapportent les erreurs différemment
Les trois routes d'import valident de la même façon mais rapportent les échecs différemment, et il vaut la peine d'en choisir une à dessein. ImportLoadedFormFromFDF saute tout champ qui échoue à la validation et renvoie le nombre de champs réellement appliqués, donc un compte inférieur aux attentes est le seul signe d'un problème. ImportLoadedInterchangeFromFDF et ImportLoadedFormFromXFDF lèvent au premier champ rejeté. Chaque champ est engagé pour son compte, donc les champs traités avant l'exception gardent leurs nouvelles valeurs. Ne traitez aucun de ces imports comme une transaction sur tout le fichier d'échange : si vous avez besoin d'un comportement tout-ou-rien, abandonnez le document chargé quand une exception survient au lieu de le sauvegarder
var
  Pdf: THotPDF;
  Source: TMemoryStream;
  Status: AnsiString;
  Info: THPDFFDFInterchangeInfo;
begin
  Pdf := THotPDF.Create(nil);
  Source := TMemoryStream.Create;
  try
    Source.LoadFromFile('order-form-reviewed.fdf');
    if Pdf.LoadFromFile('order-form.pdf', '') > 0 then
    try
      // Champs seulement ; une valeur hors /Opt ou une cible non multi-sélection lève
      if Pdf.ImportLoadedInterchangeFromFDF(Source, True, False, Status, Info) then
        Pdf.SaveLoadedDocument('order-form-filled.pdf');
    except
      on E: Exception do
        ShowMessage('Import rejected, nothing saved: ' + E.Message);
    end;
  finally
    Source.Free;
    Pdf.Free;
  end;
end;
Étendre les callbacks XFDF sans casser les appelants existants
Le support des tableaux dans l'unité XFDF de plus bas niveau vit dans un enregistrement séparé, THPDFXFDFArrayAccess, et dans de nouvelles surcharges de HPDFXFDFExportFields et HPDFXFDFImportFields, pas dans des champs supplémentaires ajoutés à la fin de l'enregistrement THPDFXFDFAccess existant. La raison, c'est la compatibilité binaire. Du code qui remplit THPDFXFDFAccess comme variable locale ne règle souvent que les cases qu'il connaît et n'efface jamais le reste, donc un nouveau pointeur de fonction ajouté à cet enregistrement contiendrait des ordures de pile, et la bibliothèque le prendrait pour un vrai callback. Avec un enregistrement séparé, les anciens appelants gardent l'ancien agencement et les anciennes surcharges, et ces surcharges passent en interne un enregistrement de tableau tout nil. La surcharge d'import scalaire d'origine colle toujours les valeurs répétées avec LF pour compatibilité, et seule la surcharge consciente des tableaux les garde séparées. Quand vous branchez votre propre magasin de données, partez de Default(THPDFXFDFArrayAccess). Renvoyez True depuis GetFormFieldValueArray pour tout champ à valeur de liste, y compris sans rien de sélectionné, et False pour retomber sur le callback scalaire
uses HPDFXFDF;

// Pointeur de fonction simple, pas « of object » : Context porte votre propre magasin
function StoreGetSelections(Context: Pointer; FieldIndex: Integer;
  out Values: THPDFXFDFValueArray): Boolean;
begin
  Result := TFormStore(Context).IsListField(FieldIndex);
  if Result then
    Values := TFormStore(Context).Selections(FieldIndex);
end;

procedure ExportStore(Store: TFormStore; out Bytes: TBytes);
var
  Access: THPDFXFDFAccess;
  ArrayAccess: THPDFXFDFArrayAccess;
begin
  Access := MakeStoreAccess(Store);             // vos liaisons scalaires existantes
  ArrayAccess := Default(THPDFXFDFArrayAccess); // chaque case inutilisée est nil
  ArrayAccess.GetFormFieldValueArray := StoreGetSelections;
  HPDFXFDFExportFields(Access, ArrayAccess, Bytes);
end;
L'échange multi-sélection fonctionne sur des list box qui existent déjà et ont le bit MultiSelect positionné dans /Ff. Pour la création des champs de choix et de leurs bits de drapeaux à l'origine, voyez ajouter des ListBox et autres champs AcroForm à un PDF chargé. Pour le balisage d'annotations qui passe par l'arbre <annots> du XFDF, voyez l'import et l'export d'annotations XFDF dans HotPDF. La référence API complète et le téléchargement d'essai sont sur la page du composant PDF HotPDF pour Delphi