HotPDF convertit du HTML en pages PDF via THPDFHTMLImporter.RenderHTML5, un profil de médias paginés versionné doté d'un vrai DOM, d'une vraie cascade CSS, de tableaux, de sauts de page et d'une génération optionnelle d'AcroForm à partir des contrôles de formulaire HTML. Il s'exécute entièrement in-process : pas de moteur de navigateur, pas de Chromium, pas de convertisseur externe, et par défaut aucun accès fichier ni réseau
La raison pour laquelle un point d'entrée séparé existe plutôt qu'une amélioration de RenderHTML est la compatibilité. L'ancienne méthode génère des factures et des courriers en production depuis des années, et un DOM permissif doté d'une cascade complète change la sortie de documents qui ont été calibrés sur l'ancien comportement. L'ancienne méthode conserve donc exactement sa sémantique, et tout ce qui est nouveau vit derrière RenderHTML5, dont la version de profil est rapportée par HTML5ProfileVersion et dont les jalons pris en charge sont listés par HTML5ProfileMilestones
Qu'apporte réellement le profil HTML5 ?
Quatre capacités comptent en pratique. Un DOM structurel où html et body sont des conteneurs plutôt que des nœuds de texte. Une cascade CSS avec une précédence correcte. La mise en page des tableaux. Et un contrôle explicite des sauts de page, ce que signifie « médias paginés » : le HTML a été conçu pour un viewport défilant, et le transformer en pages exige de décider où le contenu est autorisé à se couper
Le point sur les conteneurs semble être un détail d'implémentation et constitue en réalité la différence entre fonctionner et ne pas fonctionner. Si les éléments racines sont traités comme des conteneurs de texte, tout le DOM s'effondre en un seul bloc de texte dès l'analyse, et chaque règle de feuille de style, saut de page, tableau et sous-arbre de formulaire qui suit s'applique alors à rien. Tout moteur de rendu HTML qui produit un mur de texte indifférencié à partir d'un document structuré a commis exactement cette erreur
L'ordre de la cascade, détaillé
La précédence CSS n'est pas un tri unique. HotPDF applique les déclarations normales des règles correspondantes par ordre de spécificité puis d'ordre source, applique ensuite les déclarations normales en ligne par-dessus, puis les déclarations !important des règles correspondantes, et enfin les déclarations !important en ligne. Quatre passes, dans cet ordre
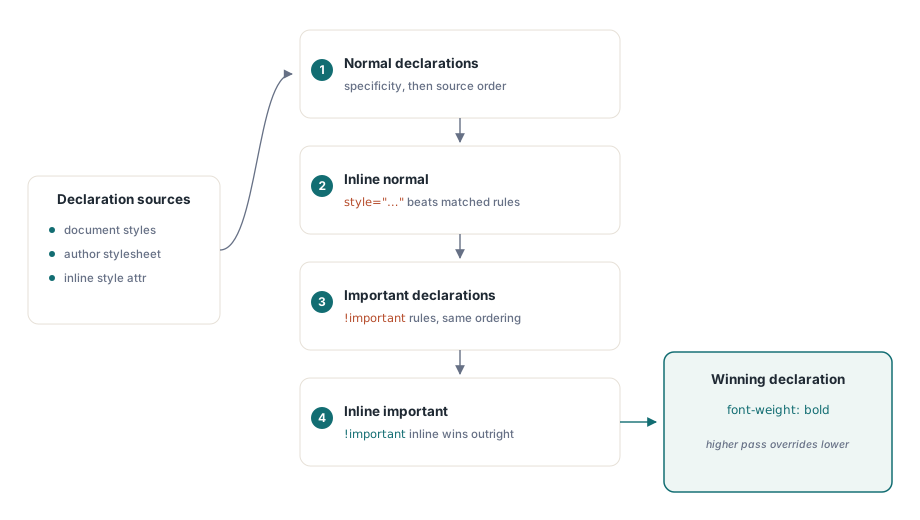
Les implémentations qui réduisent cela à « le dernier gagne » traitent correctement les cas courants et de travers les cas intéressants, ce qui est pire que de tout traiter uniformément de travers, car l'échec n'apparaît que dans les gabarits qui utilisent !important pour surcharger une feuille de style de base — précisément les gabarits écrits par des personnes qui s'attendent à ce que la cascade fonctionne :
uses
  HPDFDoc, HPDFHTMLImport;

var
  Pdf: THotPDF;
  Importer: THPDFHTMLImporter;
  Html, Css: WideString;
begin
  Pdf := THotPDF.Create(nil);
  Importer := THPDFHTMLImporter.Create(Pdf);
  try
    Pdf.FileName := 'statement.pdf';
    Pdf.BeginDoc;

    Importer.Margin := 56;              // points
    Importer.BaseFontName := 'Arial';
    Importer.BaseFontSize := 10;
    Importer.CreateAcroForms := False;  // affiche les contrôles, ne crée pas les champs

    Css := '@page { margin: 56pt } ' +
           'table { border-collapse: collapse } ' +
           'tr.total { page-break-inside: avoid; font-weight: bold }';
    Html := LoadTemplate('statement.html');

    if not Importer.RenderHTML5(Html, Css) then
      raise Exception.Create('nothing was emitted - check the markup');

    Pdf.EndDoc;

    Writeln(Format('profile=%d nodes=%d rules=%d layout ops=%d',
      [Importer.Statistics.ProfileVersion,
       Importer.Statistics.ParsedNodeCount,
       Importer.Statistics.CSSRuleCount,
       Importer.Statistics.LayoutOperationCount]));
  finally
    Importer.Free;
    Pdf.Free;
  end;
end;
Le second argument est une feuille de style d'auteur appliquée en plus de celle que porte le document, ce qui est le moyen propre d'imposer des règles maison telles que les marges de page et le contrôle des veuves sans modifier chaque gabarit
Pourquoi l'importateur ne va-t-il jamais rien chercher lui-même ?
Un convertisseur HTML vers PDF qui résout les références externes est un moteur de falsification de requête côté serveur déguisé en outil de génération de documents. Pointez-le vers un balisage fourni par l'utilisateur et il ira volontiers chercher http://169.254.169.254/ ou une URL de fichier sur votre serveur applicatif, puis intégrera le résultat dans un PDF que quelqu'un télécharge
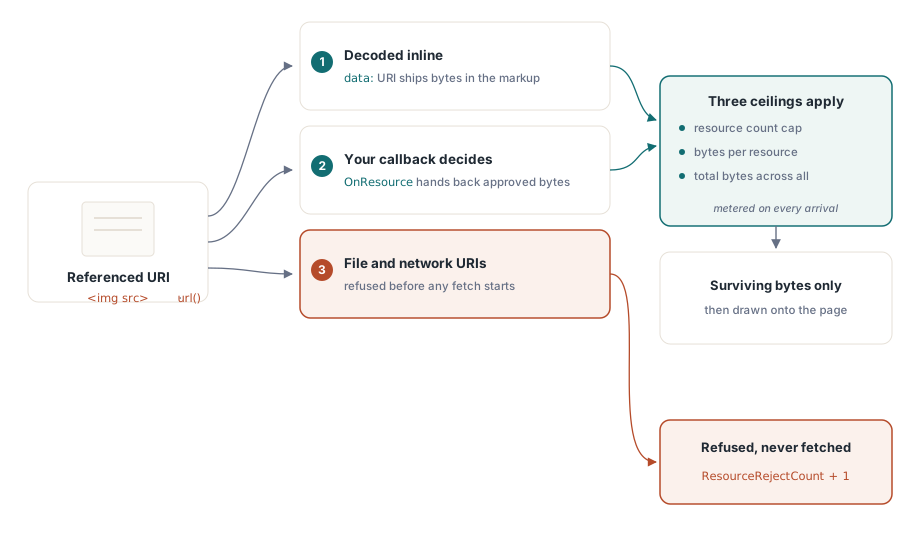
HotPDF ne lit donc par défaut ni fichiers ni réseau. Les images et autres ressources arrivent de deux façons exactement : sous forme d'URI data: à l'intérieur du balisage, ou via le callback OnResource, où votre code décide ce que signifie une URI et fournit les octets :
procedure TReportForm.SupplyResource(Sender: TObject;
  const URI: WideString; ResourceKind: THPDFHTMLResourceKind;
  var Data: TBytes; var ContentType: string; var Handled: boolean);
begin
  Handled := False;
  // Ne servir que depuis un répertoire d'assets local en liste blanche. Ne jamais
  // passer l'URI à un client HTTP, et ne jamais la joindre à un chemin
  // sans la valider au préalable
  if StartsText('asset:', URI) then
  begin
    Data := LoadAssetBytes(Copy(URI, 7, MaxInt));
    ContentType := 'image/png';
    Handled := Length(Data) > 0;
  end;
end;
Chaque ressource qui arrive quand même est encore comptabilisée face à trois plafonds distincts : combien de ressources, combien d'octets chacune, et combien d'octets au total. Un callback qui restitue fidèlement tout ce qu'on lui demande ne peut pas être amené à épuiser la mémoire par un document qui référence deux cents fois la même image de 50 Mo
Quatre budgets, un seul mode d'échec
Nœuds d'analyse, règles CSS, opérations de mise en page et ressources sont mesurés indépendamment, car ils échouent indépendamment. Un document peut être petit et pathologiquement coûteux à mettre en page ; un autre peut être peu profond avec une feuille de style conçue pour faire exploser la correspondance de sélecteurs. Épuiser l'un ou l'autre déclenche EHPDFHTMLImportBudget, une classe d'exception dédiée afin que l'épuisement de budget puisse être intercepté séparément d'une entrée malformée
Les statistiques se réinitialisent au début de chaque appel à RenderHTML5, si bien que les chiffres décrivent un import unique plutôt que la durée de vie de l'objet importateur. Dans un service qui rend des gabarits non fiables, journalisez ParsedNodeCount, LayoutOperationCount et ResourceRejectCount par document : un nombre de rejets qui augmente signifie généralement qu'un auteur de gabarit référence des assets que votre callback ne reconnaît pas, et un nombre d'opérations de mise en page proche du plafond signifie que le prochain document légèrement plus grand échouera
Choisir entre l'import HTML et l'API de mise en page
L'import HTML l'emporte quand le contenu est rédigé en HTML par des personnes qui ne sont pas développeurs Delphi, quand les gabarits changent plus souvent que le code, ou quand le même contenu doit aussi être envoyé par e-mail. L'arbre de mise en page déclarative décrit dans la mise en page PDF déclarative avec sortie balisée l'emporte quand le document est généré à partir de données par votre propre code, quand vous avez besoin que la structure PDF/UA soit émise automatiquement, ou quand un contrôle précis de la pagination compte plus que la commodité de rédaction
Ces approches ne s'excluent pas mutuellement. Un schéma courant consiste à utiliser l'import HTML pour le corps d'un rapport, avec en-tête, pied de page et blocs de signature dessinés directement, puisqu'il s'agit d'une géométrie fixe qu'aucun gabarit ne devrait posséder. Les tableaux sont le seul domaine où il vaut la peine de mesurer les deux approches : les tableaux financiers complexes se paginent parfois mieux via la voie dédiée aux tableaux décrite dans la génération de tableaux en PDF
Réglez CreateAcroForms délibérément. Désactivé, les contrôles de formulaire HTML s'affichent comme une illustration statique, ce que veut un relevé imprimé. Activé, ils deviennent de vrais champs AcroForm interactifs, ce que veut un formulaire remplissable, et le comportement des champs qui s'ensuit est traité dans l'ajout de champs de formulaire à un PDF chargé
L'import HTML, la mise en page déclarative et l'API de dessin direct visent le même objet document en Delphi et C++Builder ; la liste complète des fonctionnalités se trouve sur la page du composant PDF HotPDF Delphi