Un utilisateur tape Müller dans un champ de recherche, ne trouve rien, copie le même nom depuis le PDF, le recolle dans le champ, et obtient soudain des résultats. Regardez les deux chaînes dans le débogueur et Length renvoie 6 pour celle tapée et 7 pour celle collée. Le mot tapé porte U+00FC, un ü précomposé unique ; le document stocke un u simple suivi de U+0308 COMBINING DIAERESIS. Les deux s'affichent en les mêmes glyphes, et une comparaison par unités de code ne les appellera jamais égaux
Pourquoi des chaînes d'apparence identique se comparent-elles inégales ?
Unicode autorise délibérément plus d'un encodage pour le même caractère abstrait, et appelle ces encodages canoniquement équivalents. L'annexe Unicode Standard Annex #15 définit deux formes normales qui comptent pour la recherche : NFC, qui préfère les points de code précomposés, et NFD, qui scinde chaque caractère précomposé en une lettre de base plus ses signes diacritiques combinants dans un ordre fixe. Les lettres latines à diacritiques existent sous les deux formes. Les syllabes hangul aussi, qui peuvent apparaître comme une syllabe précomposée unique ou comme une suite de deux ou trois jamo conjoignants
La forme qui finit dans un PDF dépend du logiciel qui l'a produit, de la plateforme sur laquelle il tournait, et parfois de la façon dont la table ToUnicode d'une police a été construite. Un document saisi sur une machine et édité sur une autre peut mêler les deux formes sur la même page. Rien de tout cela n'est visible pour la personne qui cherche. Son clavier et sa méthode de saisie produisent généralement du NFC, si bien que tout contenu décomposé du fichier devient introuvable de son côté
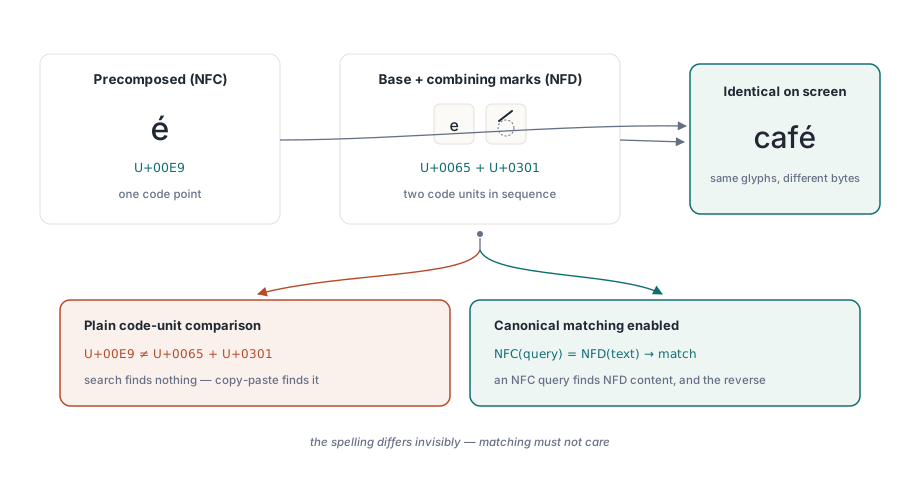
Le contournement évident est de jeter le problème dans le même panier que le pliage de casse : mettre les deux côtés en minuscules, retirer les accents, comparer. Cela casse pour une raison structurelle. Le pliage de casse et le retrait d'accents sont des transformations un à un au niveau des unités de code, si bien que le texte plié a exactement la même longueur que l'original et qu'une correspondance en position 17 dans la copie pliée est une correspondance en position 17 dans le texte extrait. La normalisation change les longueurs. Une lettre précomposée devient deux ou trois unités de code, une séquence décomposée se replie en une, les syllabes hangul s'étendent en jamo, et après cette transformation les positions rendues ne pointent plus vers le texte que vous avez extrait
Rechercher avec soCanonicalEquivalent dans PDF Library for Delphi
Dans PDF Library for Delphi, le membre soCanonicalEquivalent de TPDFlibSearchOptions fait que SearchText compare les décompositions canoniques de la requête et du texte de la page, si bien qu'une requête NFC trouve du contenu NFD et qu'une requête NFD trouve du contenu NFC. L'option fait partie d'un ensemble, ce qui signifie qu'elle se combine avec soWholeWord, soCaseSensitive, soWildcards et soDiacriticInsensitive sans aucune API séparée :
uses
  SysUtils, Math, PDFlibrary;

var
  Lib: TPDFlib;
  Hits: array of TPDFlibSearchHit;
  Found, Stored, I: Integer;
  Slice: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('contracts.pdf', '');
    Lib.SearchContextChars := 24;      // remplit ContextBefore / ContextAfter
    SetLength(Hits, 500);

    Found := Lib.SearchText('Bäcker',
      [soCanonicalEquivalent, soWholeWord, soGraphemeClusters],
      '', Hits);                       // plage de pages vide = toutes les pages

    // Found compte chaque résultat ; seuls les Length(Hits) premiers ont été copiés
    Stored := Min(Found, Length(Hits));
    for I := 0 to Stored - 1 do
    begin
      Slice := Copy(Hits[I].MatchText, Hits[I].MatchStart,
        Hits[I].MatchLength);
      Writeln(Format('page %d: [%s] %d code units, ...%s|%s|%s...',
        [Hits[I].Page, Slice, Hits[I].MatchLength,
         Hits[I].ContextBefore, Slice, Hits[I].ContextAfter]));
    end;
  finally
    Lib.Free;
  end;
end;
Deux détails de cette boucle font trébucher. SearchText renvoie le nombre total de résultats même quand le tampon est plus petit, si bien qu'itérer jusqu'à Found - 1 sur un grand document marche au-delà de la fin d'un tableau de 500 éléments ; bornez avec Min ou passez à SearchTextEach, qui remet chaque résultat à un callback et n'a besoin d'aucun tampon. Et MatchText est tout le bloc de texte qui contenait la correspondance, avec MatchStart comme index en base 1 dedans, si bien que le mot apparié lui-même est le Copy montré ci-dessus
Lancez cela contre un fichier qui stocke Bäcker décomposé et la longueur imprimée est 7 ; contre un fichier NFC elle est 6. Même requête, même ensemble d'options. La tranche est toujours le texte tel qu'il se trouve dans le document
Où le résultat atterrit dans le texte original
Cette dernière propriété est ce qui rend la recherche normalisée utilisable pour quoi que ce soit au-delà d'une réponse oui/non. PDF Library for Delphi enregistre, pour chaque unité de code que le normaliseur produit, le début et la fin de la plage UTF-16 originale d'où elle vient. Une décomposition récursive hérite de la plage de son parent, une composition fusionne les plages de ses entrées, et quand une correspondance est trouvée, la recherche balaie l'intervalle mappé pour le plus petit début et la plus grande fin
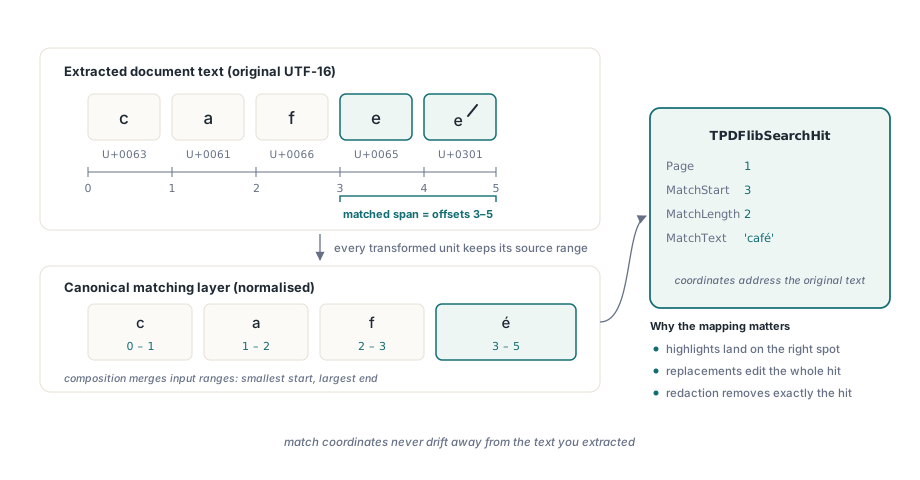
En conséquence, MatchStart, MatchLength, ContextBefore, ContextAfter et les deux points d'entrée de remplacement adressent le texte extrait que l'appelant a déjà. Une recherche qui pourrait dire « il y a un résultat dans ce bloc » sans dire exactement où serait acceptable pour un compte de résultats et fausse pour tout le reste : les surlignages dériveraient d'un caractère ou deux par lettre accentuée, et un remplacement réécrirait la mauvaise plage de texte
Le normaliseur est livré à l'intérieur de la bibliothèque. Il porte des tables compactes pour la décomposition canonique, la composition et la classe combinante canonique d'Unicode 15.1, applique les règles algorithmiques du hangul au lieu d'entrées de table, et réordonne les signes combinants de façon stable pendant la NFD. Aucun fichier de données externe n'est chargé et aucun appel de normalisation du système d'exploitation n'est fait, si bien qu'un service Windows, un démon Linux et un build Free Pascal renvoient des résultats identiques pour le même fichier. Nous préférons les choses ainsi même si le système pourrait faire le travail sous Windows : un index de recherche construit sur un serveur et interrogé sur un autre ne devrait jamais être en désaccord parce que les deux machines tournent sur des versions d'Unicode différentes
L'option est désactivée par défaut, et ce défaut est raisonnable. Construire le texte NFD et sa carte de positions coûte du temps, et une recherche sur des factures en ASCII pur n'en a jamais besoin. Quand soCanonicalEquivalent est activé, chaque bloc de texte garde deux copies transformées, une avec les signes combinants et une sans, si bien qu'un lot de requêtes sur le même bloc le normalise une fois. Le simple pliage de casse reste sur le chemin un à un moins cher
Qu'est-ce qui se passe mal quand un résultat finit à l'intérieur d'un caractère ?
L'équivalence canonique répond à « est-ce le même texte », mais elle ne dit rien de l'endroit où un résultat est autorisé à s'arrêter. Cherchez un café décomposé pour cafe avec soCanonicalEquivalent seul et les quatre premières unités de code correspondent ; l'accent aigu combinant qui suit reste hors du résultat. soWholeWord ne l'attrape pas, car ses caractères de mot suivent les règles d'identificateur (lettres ASCII, chiffres et tiret bas) et un signe combinant compte comme une frontière. Le surlignage couvre cafe, et un remplacement laisse un accent égaré flotter sur ce qui suit
La même chose arrive bien au-delà des accents latins. Un emoji drapeau est deux points de code d'indicateur régional. Un emoji famille est plusieurs personnes reliées par des jointures de largeur nulle. Une conjonction devanagari est une consonne, un virama et une autre consonne, et une voyelle vietnamienne peut porter deux signes empilés. Tout ce qui est hors du plan multilingue de base est une paire de surrogates en UTF-16, et en couper une en deux produit un surrogate non apparié que beaucoup de pipelines de texte remplacent par U+FFFD
soGraphemeClusters exige que les deux bouts de chaque résultat, littéral ou générique, tombent sur des frontières de clusters de graphèmes étendus telles que les définit l'annexe Unicode Standard Annex #29. La segmentation couvre l'appariement CR/LF, les caractères de contrôle, les types de syllabes hangul, Extend et SpacingMark, Prepend, les séquences ZWJ d'emoji, les paires d'indicateurs régionaux et les ruptures de conjonction indic, et elle ne place jamais une frontière à l'intérieur d'une paire de surrogates. Avec l'indicateur activé, cafe ne correspond plus du tout à un café décomposé ; ajoutez soDiacriticInsensitive si l'appariement aveugle aux accents est ce que vous voulez réellement
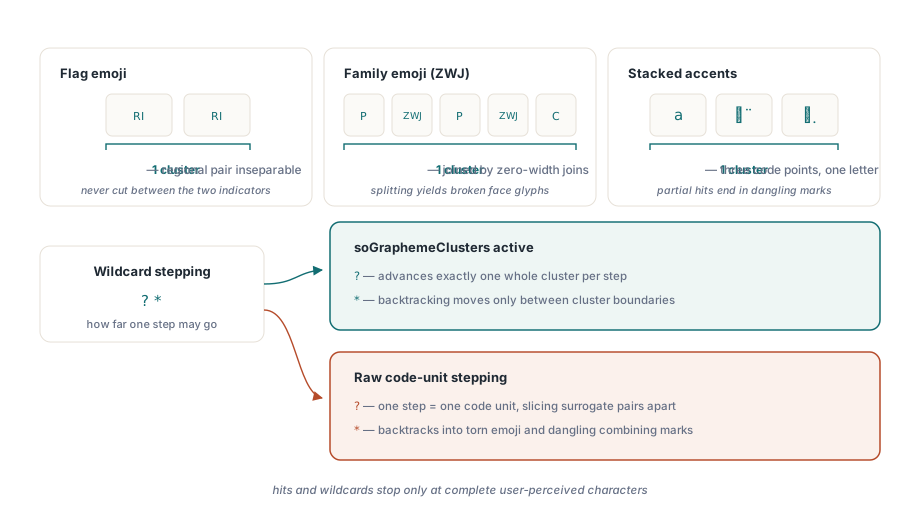
Les génériques sont là où l'indicateur change le plus visiblement les résultats. Sous soCanonicalEquivalent, le texte de la page est comparé en NFD, si bien que côté devient c o U+0302 t e U+0301 quelle que soit la façon dont le fichier l'a stocké. Sans soGraphemeClusters, le ? de c?té consomme exactement une unité de code, le o, puis attend un t et trouve U+0302. Aucun résultat. Avec l'indicateur, ? avance d'un cluster entier, et le retour arrière de * ne se déplace lui aussi qu'entre frontières de clusters :
// « ? » avance d'un caractère perçu par l'utilisateur, si bien que cela
// correspond à côté, que le PDF l'ait stocké précomposé ou décomposé
Found := Lib.SearchText('c?té',
  [soWildcards, soCanonicalEquivalent, soGraphemeClusters], '', Hits);

// Le remplacement emploie les mêmes plages sûres en clusters, si bien qu'il
// ne scinde jamais un emoji ni ne laisse un accent orphelin derrière
Replaced := Lib.SearchAndReplaceTextInContent('naïve', 'plain',
  [soCanonicalEquivalent, soGraphemeClusters], '1-20');
if Replaced = 0 then
  Writeln(Lib.GetLastUnicodeReplacementDiagnostics)
else
  Lib.SaveToFile('contracts-edited.pdf');
SearchAndReplaceTextInContent réécrit le texte à l'intérieur du contenu de page et renvoie le nombre de correspondances remplacées. Quand il renvoie zéro, GetLastUnicodeReplacementDiagnostics dit pourquoi, par exemple qu'une correspondance n'a pas pu être ramappée vers le contenu qui l'a dessinée. L'autre point d'entrée, SearchAndReplaceText, accepte le même ensemble d'options et dessine le remplacement par-dessus le bloc apparié à la place
Choisir un ensemble d'options par charge de travail
Trois combinaisons couvrent la plupart des applications. Pour un champ de recherche d'utilisateur final à l'intérieur d'un visualiseur de documents, employez soCanonicalEquivalent plus soDiacriticInsensitive : les deux formes d'encodage correspondent, et les orthographes accentuées comme non accentuées aussi, ce que les gens attendent après des années de recherche web. Pour une revue légale ou de conformité, où un faux positif coûte un après-midi à quelqu'un, employez soCanonicalEquivalent avec soCaseSensitive et soWholeWord et laissez le pliage des accents de côté, si bien que l'équivalence reste exacte tout en ignorant comment le fichier s'est trouvé encodé
Pour tout ce qui modifie le document, ajoutez soGraphemeClusters à chaque fois. C'est le seul endroit que nous ne laisserions pas au goût. Une recherche qui renvoie une plage plus courte d'une unité de code ne fait qu'égarer la personne qui lit les résultats ; un remplacement ou une suppression qui emploie la même plage écrit l'erreur dans le fichier, et personne ne le remarque avant que la page soit imprimée ou extraite à nouveau. La suppression qui doit détruire le contenu plutôt que le couvrir est un sujet à part, couvert dans la véritable censure et la suppression de contenu
Quand plusieurs termes passent sur le même document, préférez SearchTextBatch. Il évalue chaque requête non vide tant que les blocs de texte d'une page sont résidents, si bien que chaque page est extraite une fois et chaque bloc normalisé une fois, et chaque requête porte son propre ensemble d'options :
var
  Queries: array[0..2] of TPDFlibSearchQuery;
  BatchHits: array of TPDFlibSearchBatchHit;
  Count, I: Integer;
begin
  Queries[0].Query := 'Müller';
  Queries[0].Options := [soCanonicalEquivalent, soDiacriticInsensitive];
  Queries[1].Query := '서울';                // Hangul : NFC ou jamo dans le fichier
  Queries[1].Options := [soCanonicalEquivalent, soGraphemeClusters];
  Queries[2].Query := 'Nguyễn';
  Queries[2].Options := [soCanonicalEquivalent, soCaseSensitive,
    soWholeWord, soGraphemeClusters];

  SetLength(BatchHits, 2000);
  Count := Min(Lib.SearchTextBatch(Queries, '', BatchHits),
    Length(BatchHits));
  for I := 0 to Count - 1 do
    Writeln(Format('query %d -> page %d',
      [BatchHits[I].QueryIndex, BatchHits[I].Hit.Page]));
end;
Les résultats reviennent ordonnés par page, puis bloc, puis requête, et QueryIndex est la position en base 0 dans le tableau que vous avez passé. SearchTextBatchEach est la forme à callback pour des jeux de résultats que vous ne pouvez pas dimensionner à l'avance. La façon dont les blocs de texte sont extraits en premier lieu est décrite dans la recherche de texte et l'énumération d'éléments de page
Écritures où l'équivalence canonique n'est pas optionnelle
Pour le coréen, l'équivalence canonique décide si un nom est trouvé du tout, car syllabes précomposées et jamo décomposés apparaissent tous deux dans de vrais documents. Le vietnamien empile un signe tonal sur une voyelle qui porte déjà peut-être une brève ou un circonflexe, si bien que sa forme composée dépend entièrement du producteur. Pour le devanagari, le bengali et les autres écritures indic, les règles de conjonction décident si une frontière de résultat atterrit à un endroit qu'un lecteur peut reconnaître. Le japonais et le chinois sont comparativement faciles côté recherche, bien que le côté mise en page ne le soit pas, comme le couvre l'écriture verticale pour le japonais et le chinois
Notre recommandation est franche. Si le corpus contient une langue autre que l'anglais, activez d'abord soCanonicalEquivalent et ne le désactivez qu'après l'avoir chronométré sur vos propres documents et jugé le coût inacceptable. La défaillance qu'il prévient atterrit précisément sur les noms que vos utilisateurs cherchent le plus
Le même moteur conscient d'Unicode pilote recherche, extraction, remplacement et censure depuis Delphi, C++Builder et Free Pascal ; ensembles d'options, API par lots et reste de la boîte à outils texte sont listés sur la page produit PDF Library for Delphi