PDFlibPas, la PDF Library pour Delphi, importe des images TIFF dont la compression JPEG dépasse la baseline 8 bits : séquentiel étendu 12 bits (SOF1), Huffman lossless (SOF3), codage arithmétique (SOF9 et SOF10) et JPEG old-style TIFF 6.0 avec offsets de tables. Comme le DCTDecode du PDF ne peut pas porter ces processus, PDFlibPas les décode en Pascal natif et intègre les échantillons sans perte à 8 ou 16 bits par composante
L'ensemble complet exige la v3.724.0 ou plus, et il vise frontalement les TIFF venus de scanners, de logiciels de capture médicale et scientifique, et de systèmes d'archive figés dans les années 1990. Voici pourquoi ces variantes ne peuvent pas être copiées telles quelles dans le PDF, comment PDFlibPas les fait atterrir, et les pièges Pascal rencontrés en chemin
Pourquoi un JPEG 12 bits ne peut-il pas entrer directement dans un PDF ?
Un JPEG 12 bits ne peut pas passer tel quel parce que le PDF n'a aucun filtre obligé de le décoder. L'ISO 32000-1 §7.4.8 définit DCTDecode autour du format baseline JPEG, avec l'extension progressive ajoutée en PDF 1.3. Rien dans cette clause ne couvre la précision d'échantillons 12 bits, le processus lossless de l'annexe H de l'ITU-T T.81, ni le codeur entropique arithmétique de l'annexe D. Un lecteur qui rencontre une trame SOF1 12 bits ou un marqueur SOF9 dans un flux DCTDecode a parfaitement le droit de ne rien dessiner, et la plupart des viewers font exactement ça
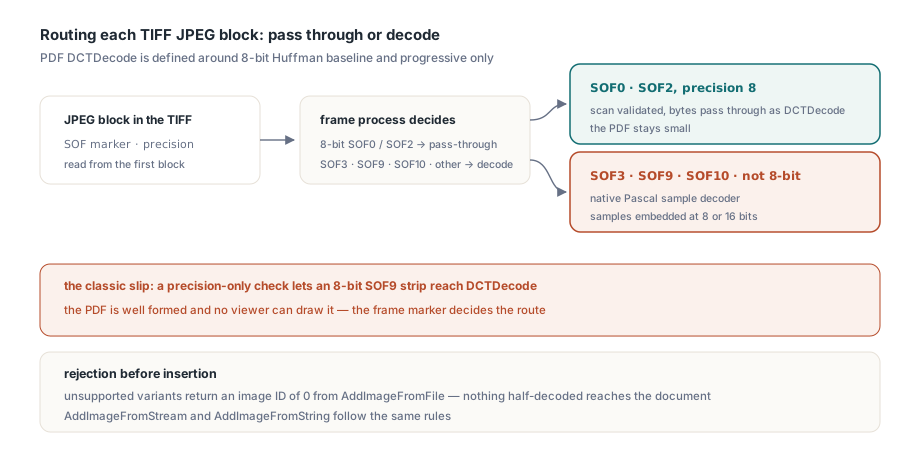
Pour les bandes Huffman baseline et progressives 8 bits qui composent la plupart des fichiers JPEG-dans-TIFF, PDFlibPas valide toujours chaque scan et transmet les octets compressés en DCTDecode, ce qui garde le PDF léger. Tout le reste est décodé. PDFlibPas lit le marqueur de trame et la précision d'échantillons du premier bloc JPEG, et quand il trouve SOF3, SOF9, SOF10 ou une précision autre que 8, la page passe par le décodeur d'échantillons au lieu du chemin de transmission directe. Détecter le codage arithmétique par son marqueur de trame compte plus qu'il n'y paraît : un contrôle qui ne regarde que la précision d'échantillons laisse un TIFF classique glisser une bande SOF9 8 bits dans le chemin DCTDecode et produire un PDF que les lecteurs ne peuvent pas afficher
Ce que PDFlibPas écrit dans le PDF à la place
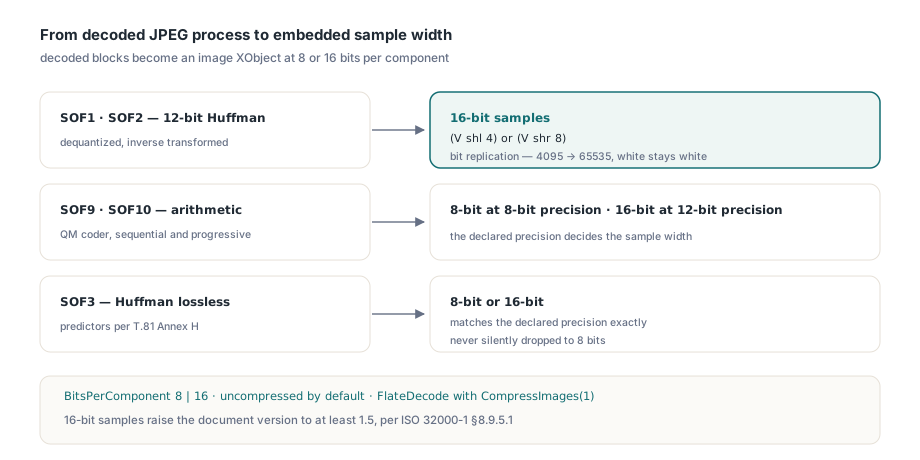
PDFlibPas transforme les blocs JPEG décodés en un image XObject ordinaire avec BitsPerComponent 8 ou 16. Les échantillons sont stockés non compressés par défaut ; appelez CompressImages(1) avant d'ajouter l'image et PDFlibPas les écrit avec FlateDecode. L'ISO 32000-1 §8.9.5.1 autorise 16 bits par composante à partir du PDF 1.5, donc PDFlibPas monte la version du document à 1.5 au moins dès qu'une image à échantillons 16 bits est ajoutée. Cela inclut les images multi-bandes et tuilées, dont l'objet racine est un Form XObject sans BitsPerComponent propre à inspecter
La correspondance est fixe par processus JPEG :
- Le JPEG Huffman 12 bits (séquentiel SOF1, progressif SOF2) est déquantifié, transformé inverse et élargi en échantillons 16 bits
- Le JPEG à codage arithmétique (séquentiel SOF9, progressif SOF10) devient des échantillons 8 bits en précision 8 bits et des échantillons 16 bits en précision 12 bits
- Le JPEG Huffman lossless (SOF3) devient des échantillons 8 bits ou 16 bits, à la précision déclarée exactement
L'élargissement de 12 à 16 bits utilise la réplication de bits, (V shl 4) or (V shr 8), donc 4095 se mappe en 65535 et le blanc reste blanc au lieu de plafonner à 65520. PDFlibPas ne rabaisse jamais ces images à 8 bits dans votre dos. Quand la bibliothèque rasterise une telle page pour sa propre surface d'affichage, elle utilise l'octet haut de chaque échantillon, mais l'image PDF intégrée garde les seize
Le prix se paie en taille de fichier : même avec CompressImages(1), des échantillons 16 bits compressés en Flate sont plus gros que les données DCT d'où ils viennent, et sans compression ils le sont encore plus. Pour les workflows de diagnostic et d'archivage, cet échange est généralement le bon. Si la taille compte davantage pour un travail donné, le guide de réduction de la taille des PDF en Delphi montre où partent réellement les octets
Importer ces TIFF avec TPDFlib
Le code appelant ne change pas du tout. TPDFlib.AddImageFromFile(Const FileName: WideString; Options: Integer): Integer prend le numéro de page TIFF à base 1 dans Options et renvoie un ID d'image, ou 0 quand la page ne peut pas être importée. Les variantes JPEG non supportées sont rejetées avant que l'image ne soit insérée, donc un 0 signifie que rien de mi-décodé n'a atteint le document
uses
  PDFlibrary;

function TiffToPdf(const TiffName, PdfName: WideString): Boolean;
var
  Lib: TPDFlib;
  Page, PageCount, ImageID: Integer;
  DPI, W, H: Double;
begin
  Result := False;
  Lib := TPDFlib.Create;
  try
    Lib.SetMeasurementUnits(0);   // espace utilisateur par défaut, 1/72 pouce
    Lib.SetOrigin(1);             // origine en haut à gauche pour DrawImage
    Lib.CompressImages(1);        // Flate pour les échantillons décodés
    PageCount := Lib.GetImagePageCount(TiffName);
    if PageCount = 0 then
      Exit;
    for Page := 1 to PageCount do
    begin
      ImageID := Lib.AddImageFromFile(TiffName, Page);  // Options = page TIFF
      if ImageID = 0 then
        Exit;                     // données d'image non supportées ou endommagées
      Lib.SelectImage(ImageID);
      case Lib.ImageResolutionUnits of
        2: DPI := Lib.ImageHorizontalResolution;          // points par pouce
        3: DPI := Lib.ImageHorizontalResolution * 2.54;   // points par cm
      else
        DPI := 0;
      end;
      if DPI <= 0 then
        DPI := 300;
      W := Lib.ImageWidth * 72 / DPI;
      H := Lib.ImageHeight * 72 / DPI;
      if Page > 1 then
        Lib.NewPage;
      Lib.SetPageDimensions(W, H);
      Lib.DrawImage(0, 0, W, H);
    end;
    Result := Lib.SaveToFile(PdfName) = 1;
  finally
    Lib.Free;
  end;
end;
Aucun branchement par format n'est nécessaire, et AddImageFromStream et AddImageFromString suivent les mêmes règles pour des données TIFF en mémoire
JPEG old-style : tables à offsets, bandes sans en-têtes
Depuis la v3.713.0, PDFlibPas importe les TIFF JPEG old-style (Compression = 6) dont les tables viennent des tags d'offset JPEGQTables, JPEGDCTables et JPEGACTables ou d'un flux JPEGInterchangeFormat contenant uniquement les tables. La section 22 du TIFF 6.0 définissait ce layout, et la TIFF Technical Note 2 l'a ensuite remplacé par Compression = 7 et un tag JPEGTables partagé, mais les scanners ont continué à écrire l'ancienne forme pendant des années
Le côté conteneur, BigTIFF et layouts tuilés, est traité dans la note sur le durcissement du décodeur TIFF ; ici l'accent est mis sur la charge utile JPEG. Chaque tag d'offset de table pointe vers une table de quantification brute de 64 octets, ou vers une table Huffman de 16 compteurs suivis de ses valeurs, une entrée par composante. PDFlibPas les transforme en segments DQT et DHT dans un flux JPEGTables synthétisé. Chaque bande de données entropiques nues reçoit ensuite son propre en-tête : SOI, un marqueur de trame portant le nombre de lignes de cette bande, DRI quand JPEGRestartInterval est posé, SOS, les données d'entropie et EOI. Les bandes ne peuvent pas être collées en un seul scan, car le JPEG old-style relance la prédiction DC à chaque frontière de bande
Deux détails sont faciles à rater. Les trois composantes d'une image YCbCr pointent souvent leurs offsets de tables vers les mêmes octets, donc PDFlibPas déduplique les tables par contenu avant d'attribuer les numéros de tables. S'il reste plus de deux tables Huffman d'une classe, la trame synthétisée utilise SOF1 au lieu de SOF0, car une trame baseline ne peut référencer que deux tables DC et deux AC. Quand JPEGInterchangeFormat pointe plutôt vers un flux JPEG complet qui contient des scans, PDFlibPas traite ce flux comme l'image entière et l'importe comme une seule bande new-style. Le JPEG old-style lossless, tuilé et à plans séparés est refusé avec une erreur explicite plutôt que deviné, donc convertissez-les en JPEG new-style en amont
Pourquoi un JPEG CMYK dans un TIFF sort-il inversé ?
Un JPEG CMYK dans un TIFF sort inversé quand l'importeur applique la convention Adobe APP14 qui appartient aux fichiers JPEG autonomes. Photoshop écrit du CMYK inversé dans les JPEG autonomes, donc les producteurs de PDF ajoutent traditionnellement /Decode [1 0 1 0 1 0 1 0] pour compenser. Le PhotometricInterpretation 5 du TIFF définit les échantillons comme des quantités d'encre où 0 signifie pas d'encre, et les lecteurs TIFF grand public prennent les échantillons JPEG décodés au premier degré sans regarder l'APP14
PDFlibPas intègre les bandes CMYK TIFF compressées en JPEG sans le tableau Decode inversé, marqueur APP14 présent ou non. Le drapeau de transformation APP14 décide toujours si le YCCK est converti en CMYK, et DCTDecode gère cette étape tout seul. Les fichiers JPEG autonomes à quatre composantes gardent la convention Adobe inversée, donc des octets JPEG identiques sont traités différemment selon le conteneur, comme les deux formats l'exigent
Pourquoi le décodage JPEG lossless casse-t-il sur un décalage Pascal ?
Le décodage JPEG lossless casse en Pascal parce que les prédicteurs 5 et 6 exigent un décalage arithmétique à droite et que le shr Pascal est logique. SOF3 prédit chaque échantillon depuis ses voisins gauche (Ra), haut (Rb) et haut-gauche (Rc) et ne code que la différence. Sur les sept prédicteurs de la table H.1 du T.81, le prédicteur 5 est Ra + ((Rb - Rc) >> 1) et le prédicteur 6 est Rb + ((Ra - Rc) >> 1), et la différence entre crochets devient négative dès que le voisin haut-gauche est le plus clair. Donnez un Integer négatif au shr et le bit de signe devient un bit de magnitude, si bien que l'image se dissout en bruit
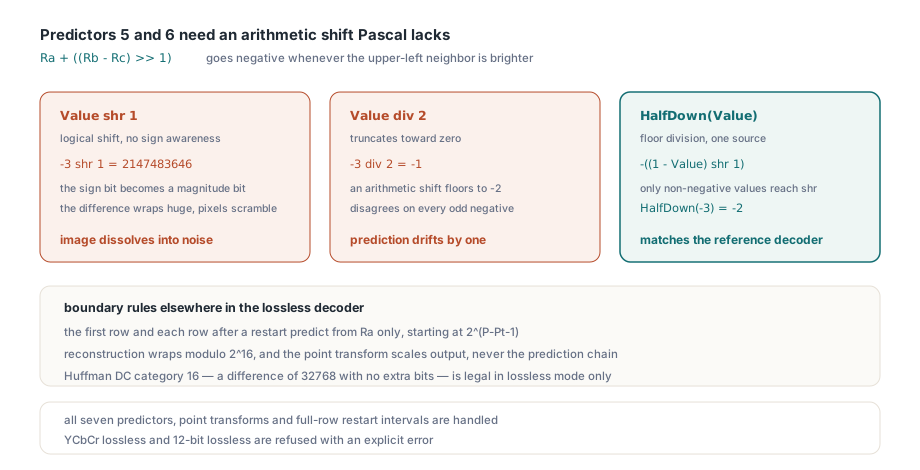
Remplacer le décalage par div 2 ne répare rien non plus. div tronque vers zéro alors qu'un décalage arithmétique arrondit vers l'infini négatif, et les deux divergent sur chaque valeur négative impaire. Free Pascal a SarLongint dans son unité System ; Delphi n'a pas d'équivalent, donc PDFlibPas utilise un helper qui compile à l'identique sur les deux :
// Décalage arithmétique à droite de un : floor(Value / 2)
// shr est un décalage logique, et div 2 tronque vers zéro
function HalfDown(Value: Integer): Integer;
begin
  if Value >= 0 then
    Result := Value shr 1
  else
    Result := -((1 - Value) shr 1);
end;

// Value = -3 :  -3 shr 1 = 2147483646,  -3 div 2 = -1,  HalfDown(-3) = -2
Pour le côté largeur de types de la même classe de problème, voir les pièges Longint et pointeurs sur Delphi Linux64
Le reste du décodeur lossless a ses propres règles de frontières. La première ligne, et la première ligne après chaque marqueur de restart, prédit depuis le voisin gauche seulement et démarre à 2^(P−Pt−1) pour une précision P et une transformation de point Pt ; chaque ligne suivante part de l'échantillon du dessus. La reconstruction boucle modulo 2^16, et la transformation de point ne met à l'échelle que la sortie, jamais la chaîne de prédiction. La catégorie DC Huffman 16, une différence de 32768 sans bits supplémentaires, n'est légale qu'en mode lossless, donc le parseur de tables doit l'accepter avant même de savoir quel processus la trame déclarera
PDFlibPas supporte les sept prédicteurs, les transformations de point et les intervalles de restart qui couvrent des lignes entières. La précision JPEG doit égaler BitsPerSample et valoir 8 ou 16, et chaque composante doit être échantillonnée 1x1. Les données lossless YCbCr et le JPEG lossless 12 bits sont refusés avec une erreur explicite
DCT 12 bits et codage arithmétique en Pascal natif
Les décodeurs 12 bits et arithmétique de PDFlibPas partagent une DCT inverse et ne diffèrent que par le décodage d'entropie. Dans le JPEG Huffman 12 bits, les catégories DC montent à 15 et les AC à 14, les tables de quantification peuvent porter des entrées 16 bits, et la prédiction DC se remet à zéro à chaque scan et à chaque restart. Les coefficients restent en ordre zigzag jusqu'à la déquantification, qui doit utiliser la valeur de quantification au même index zigzag, et ne passent qu'alors à l'ordre naturel pour l'IDCT séparable en deux passes. Les échantillons décodés atterrissent à ±1 au plus d'un décodeur de référence indépendant en virgule flottante
Le codage arithmétique remplace Huffman par le codeur QM de l'annexe D du T.81 : une table d'états de probabilité de 114 entrées, une zone de statistiques DC de 64 bins et une zone AC de 256 bins, pilotées par les paramètres de conditionnement du segment DAC (défauts L = 0, U = 1, Kx = 5). Statistiques, contexte DC et prédiction se remettent à zéro à chaque intervalle de restart et au début de chaque scan. Voilà pourquoi PDFlibPas garde les segments DAC quand il normalise les JPEGTables partagés pour des images arithmétiques ; retirez-les et chaque bande se décode avec le mauvais modèle de statistiques
La v3.723.0 a ajouté à ces chemins décodés les composantes sous-échantillonnées et la conversion YCbCr vers RGB avec les équations JFIF, et la v3.724.0 a ajouté les scans progressifs pour les données Huffman 12 bits (SOF2) et arithmétiques (SOF10). Le chroma sous-échantillonné est répliqué à pleine résolution plutôt que lissé, ce que produit un décodeur de référence avec le lissage de chroma désactivé. Le JPEG hiérarchique et le JPEG lossless à codage arithmétique (SOF11) sont refusés avec une erreur explicite
Tester des fixtures JPEG binaires en Delphi
Des fixtures JPEG construites à la main dans des tests unitaires Delphi peuvent échouer d'une façon qui ressemble trait pour trait à un bug de décodeur. Une constante chaîne construite à partir de caractères #$xx qui dépasse 255 caractères est typée UnicodeString, et son affectation à un AnsiString la convertit à travers la page de code active. Les octets $80 à $9F, monnaie courante dans les données codées en entropie, sont réécrits en chemin. Construire des en-têtes de marqueurs à l'exécution cache le même piège : en Delphi, AnsiChar + AnsiChar produit un UnicodeString, donc ajoutez des octets un par un à un AnsiString ou écrivez-les avec SetLength et affectation indexée. Pour les fixtures, stockez du texte hexadécimal et décodez-le à l'exécution :
uses
  SysUtils, PDFlibrary;

function HexToBytes(const Hex: AnsiString): AnsiString;
var
  I: Integer;
begin
  SetLength(Result, Length(Hex) div 2);
  for I := 1 to Length(Result) do
    Result[I] := AnsiChar(StrToInt('$' + string(Copy(Hex, I * 2 - 1, 2))));
end;

// La fixture reste en ASCII pur, aucune page de code ne peut la toucher
ImageID := Lib.AddImageFromString(HexToBytes(TiffHex), 1);
Pour générer des images de test, notez que jpegtran -arithmetic écrit du séquentiel SOF9 ; SOF10 exige aussi -progressive. Et un ID d'image non nul ne prouve que l'import a été accepté. Rendez la page et comparez les pixels, car une erreur de transmission directe produit un PDF bien formé qu'aucun viewer ne peut dessiner
Faire entrer des archives de scans historiques dans le PDF
Ces variantes JPEG ont tendance à surgir toutes en même temps lors d'une migration d'archive. PDFlibPas lit les TIFF JPEG 12 bits, lossless, arithmétiques et old-style par le même appel AddImageFromFile que tout le reste, garde la précision complète dans le PDF, et refuse les processus rares hors de cet ensemble avec une erreur explicite. Pour les licences, la liste complète des fonctionnalités et les téléchargements d'essai, voir la page produit de la PDFlibPas PDF Library pour Delphi