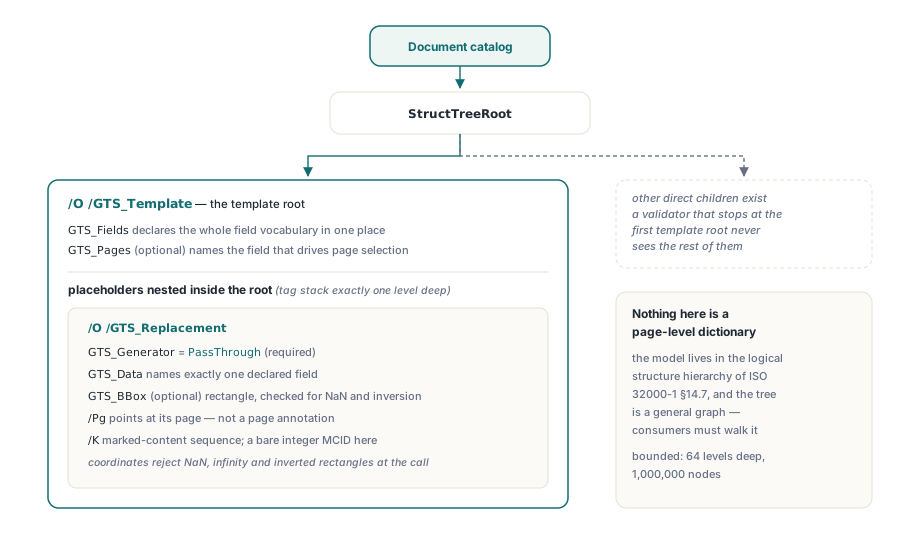
PDFlibPas implémente PDF/VCR-1 comme un profil de structure étiquetée : la définition de remplacement vit sous StructTreeRoot comme branche enfant directe, où une racine de modèle porte /O /GTS_Template pour déclarer le jeu de champs et chaque placeholder porte /O /GTS_Replacement pour lier un champ de données. Rien de tout cela n'est un dictionnaire au niveau de la page
Cette seule phrase est la partie que la plupart des implémentations ratent, et se tromper coûte plus cher qu'une validation échouée. Un travail de données variables dont le plan de remplacement est mal lu ne plante pas. Il s'imprime, en volume, avec le mauvais champ dans la mauvaise case, et le premier à s'en apercevoir est le client qui tient cinquante mille mailings
Où vit réellement la définition de remplacement
PDF/VCR-1 met son modèle de remplacement dans la hiérarchie de structure logique décrite dans ISO 32000-1 §14.7, pas dans un dictionnaire de page privé. La racine de modèle est un élément de structure accroché directement à StructTreeRoot, distingué par un propriétaire d'attributs GTS_Template, et elle déclare tout le vocabulaire de champs en un seul endroit via GTS_Fields plus un GTS_Pages optionnel nommant le champ qui pilote la sélection de page
Les placeholders sont des éléments de structure imbriqués dans cette racine, avec un propriétaire d'attributs GTS_Replacement. Chacun porte GTS_Generator (que PDFlibPas exige en PassThrough), une valeur GTS_Data nommant exactement un champ déclaré, et un GTS_BBox optionnel. La liaison à la page n'est pas non plus une annotation de page : l'élément pointe vers sa page via /Pg et vers la séquence de contenu marqué via /K. Choisir la structure plutôt qu'un dictionnaire de page entraîne une conséquence facile à énoncer et facile à sous-estimer : l'arbre de structure est un graphe général atteint depuis le catalogue, donc tout ce qui consomme le profil doit être un parcoureur d'arbre avec tous les dangers que cela implique, plutôt qu'un lecteur de dictionnaire. Si vous n'avez jamais travaillé avec l'arbre de structure, la mécanique est posée dans la structure PDF étiquetée et l'accessibilité
Pourquoi vérifier seulement la première branche de premier niveau laisse-t-il passer les mauvais fichiers ?
Parce que StructTreeRoot peut avoir beaucoup d'enfants directs, et un validateur qui s'arrête après avoir localisé la racine de modèle ne voit jamais le reste. C'est l'échec précis que PDFlibPas est construit pour éviter, et il produit exactement le genre de faux succès pire que pas de vérification du tout : un fichier qui se déclare conforme et contient une seconde racine de modèle, ou un placeholder posé hors de la branche de modèle où aucun consommateur ne l'honorera
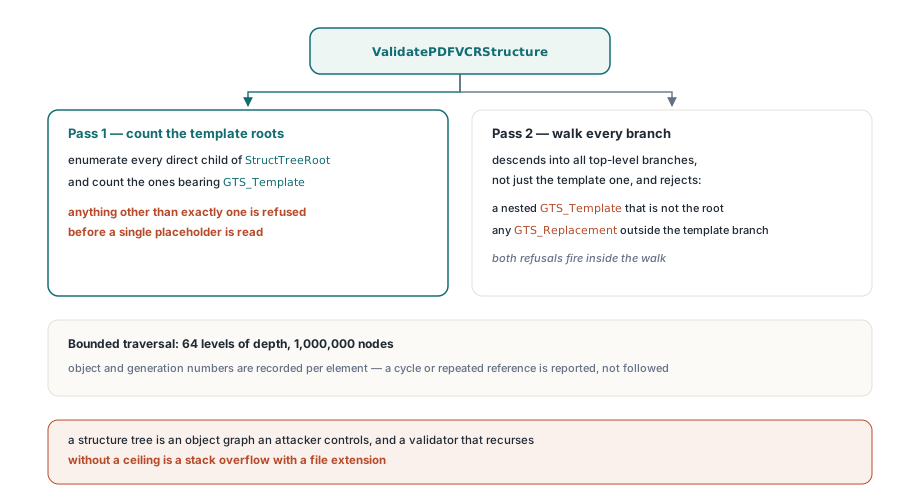
Donc ValidatePDFVCRStructure dans PDFlibPas fait deux passes sur le même arbre. La première passe énumère chaque enfant direct de StructTreeRoot et compte ceux qui portent GTS_Template ; tout ce qui n'est pas exactement un est refusé avant qu'un seul placeholder soit lu. La seconde passe descend dans toutes les branches de premier niveau, pas seulement celle du modèle, et rejette deux choses à la fois : un élément imbriqué portant GTS_Template qui n'est pas la racine, et tout élément GTS_Replacement trouvé hors de la branche de modèle
La traversée est bornée à 64 niveaux de profondeur et 1 000 000 de nœuds, et elle enregistre le numéro d'objet et de génération de chaque élément visité pour qu'un cycle ou une référence répétée soit rapporté plutôt que suivi. Ces nombres ne sont pas du réglage de performance. Un arbre de structure est un graphe d'objets contrôlé par un attaquant, et un validateur qui récurse sans plafond est un débordement de pile avec une extension de fichier
Écrire un modèle, et les contraintes que l'API refuse de plier
PDFlibPas expose l'écriture à travers une API à parenthèses qui impose les règles structurelles au moment de l'écriture plutôt que de les découvrir à la sauvegarde. SetPDFVCRMode bascule le document dans le profil, ce qui exige en interne le mode de base PDF/X-4 d'ISO 15930-7 et active le drapeau mark-info, parce qu'un fichier PDF/VCR-1 sans contenu marqué n'a rien vers quoi un placeholder puisse pointer. À partir de là, BeginPDFVCRTemplate prend la liste de champs et le champ de sélection de page, et elle est stricte de façons qui méritent d'être connues avant de concevoir votre schéma de données. Les noms de champs passent par PDFVCRValidFieldName, qui n'accepte que les lettres ASCII, les chiffres, le souligné, le trait d'union et le point, parce que ce sont les caractères qui se sérialisent en un nom PDF sans ambiguïté d'échappement. PDFVCRNormalizeFieldList garde la liste sensible à la casse et rejette les doublons d'emblée, et le champ de sélection de page doit lui-même apparaître dans la liste déclarée
var
  Lib: TPDFlib;
  Diag: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Lib.NewDocument;

    if Lib.SetPDFVCRMode(1) <> 1 then
      raise Exception.Create('PDF/VCR mode was refused');

    Lib.NewPage;
    if Lib.BeginPDFVCRTemplate('Salutation,FullName,AccountNo',
                               'AccountNo') <> 1 then
      raise Exception.Create('Field list rejected');

    // Un placeholder lie exactement un champ déclaré.
    Lib.BeginPDFVCRPlaceholder('FullName', 72, 690, 320, 712);
    Lib.DrawText(72, 694, 'SAMPLE NAME');
    Lib.EndPDFVCRPlaceholder;

    Lib.EndPDFVCRTemplate;

    Diag := Lib.GetPDFVCRDiagnostics;
    if Diag <> '' then
    begin
      Writeln('PDF/VCR blockers: ', Diag);
      Exit;
    end;

    Lib.SaveToFile('campaign-template.pdf');
  finally
    Lib.Free;
  end;
end;
Notez ce que les parenthèses vous achètent. BeginPDFVCRPlaceholder refuse de s'ouvrir si aucun modèle n'est actif et si la pile de tags n'est pas exactement à un niveau de profondeur, c'est ainsi que PDFlibPas garantit que les placeholders sont des enfants directs de la racine de modèle et ne s'imbriquent jamais les uns dans les autres. Les coordonnées sont aussi validées, rejetant NaN, l'infini et les rectangles inversés, donc une mauvaise boîte englobante échoue à l'appel plutôt que dans un rapport de preflight une semaine plus tard
Pourquoi un placeholder a-t-il besoin de son propre chemin de sérialisation MCID ?
Parce que PDF/VCR-1 veut que /K soit un entier nu, et ce n'est pas ainsi qu'un écrivain PDF étiqueté général sérialise le lien entre un élément de structure et son contenu. Sous ISO 32000-1 §14.6, un élément de structure référence normalement le contenu marqué soit via un entier MCID direct, quand l'élément identifie déjà sa page via /Pg, soit via un dictionnaire de référence de contenu marqué qui nomme la page explicitement. Une bibliothèque qui émet de la sortie étiquetée à beaucoup d'usages tend à standardiser sur la forme dictionnaire parce qu'elle compose mieux entre les pages
PDFlibPas a pris l'option étroite ici plutôt que la générale. SetCurrentStructElemDirectMCIDKid marque l'élément de structure courant, et seuls les éléments portant ce drapeau sérialisent /K comme un MCID direct avec la page portée sur /Pg ; tout le reste garde le chemin existant du dictionnaire MCR intact. C'est un compromis délibéré et c'est le genre qui mérite d'être dit à voix haute : ajouter un profil ne devrait pas changer les octets de sortie que tout autre document étiqueté produit déjà, donc le profil reçoit un chemin qui lui est propre plutôt qu'un interrupteur global. Chaque fichier étiqueté existant garde sa sérialisation précédente, et la surface de régression reste de la taille de la nouvelle fonctionnalité
Une traversée, deux consommateurs
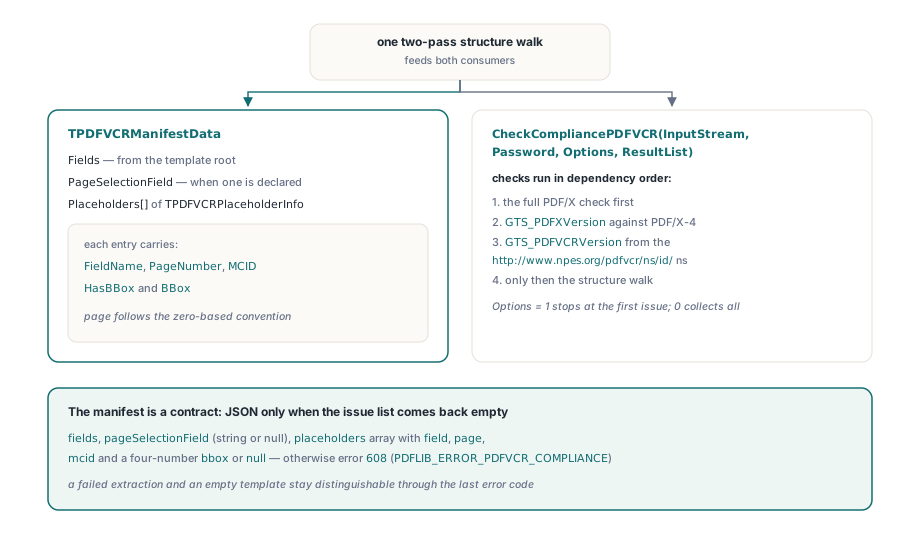
PDFlibPas dérive le manifeste de remplacement et le verdict de conformité de la même marche en deux passes, c'est pourquoi le manifeste peut être fié comme plan de travail. La traversée remplit un enregistrement TPDFVCRManifestData pendant qu'elle valide : Fields depuis la racine de modèle, PageSelectionField quand un est déclaré, et un tableau Placeholders d'entrées TPDFVCRPlaceholderInfo portant FieldName, PageNumber, MCID, HasBBox et BBox. Le point d'entrée de conformité est CheckCompliancePDFVCR(InputStream, Password, Options, ResultList), et il exécute ses vérifications en ordre de dépendance plutôt que toutes à la fois : la vérification PDF/X complète d'abord, puis GTS_PDFXVersion contre PDF/X-4, puis GTS_PDFVCRVersion lue depuis le namespace http://www.npes.org/pdfvcr/ns/id/, et seulement ensuite la marche de structure. Passer Options à 1 le fait s'arrêter au premier problème, ce que vous voulez dans une porte de lot ; passer 0 collecte tout, ce que vous voulez dans un rapport
// Vérifiez un modèle que vous avez reçu plutôt que produit
var
  Issues: TStringList;
  Stream: TFileStream;
  I: Integer;
begin
  Issues := TStringList.Create;
  Stream := TFileStream.Create('supplier-template.pdf',
                               fmOpenRead or fmShareDenyWrite);
  try
    if CheckCompliancePDFVCR(Stream, '', 0, Issues) <> 100 then
      for I := 0 to Issues.Count - 1 do
        Writeln('PDF/VCR: ', Issues[I]);
  finally
    Stream.Free;
    Issues.Free;
  end;
end;
Le manifeste est un contrat, donc il n'existe que pour les fichiers conformes
BuildPDFVCRManifest ne renvoie du JSON que quand la liste de problèmes revient vide, et une chaîne vide sinon. Ce n'est pas du code défensif pour lui-même. Un manifeste est consommé par un moteur de composition qui pilotera une vraie sortie, et rendre une liste de champs partielle extraite d'un fichier à deux racines de modèle invite le moteur à traiter une structure non conforme comme un plan de remplacement fiable. Via l'API document, GetPDFVCRManifest(InputFileName, Password) enveloppe le même appel et règle le dernier code d'erreur à PDFLIB_ERROR_PDFVCR_COMPLIANCE (608) quand le fichier n'est pas qualifié, donc une extraction échouée et un modèle vide sont distinguables. Le JSON rapporte fields, pageSelectionField comme chaîne ou null, et un tableau placeholders dont les entrées donnent field, page, mcid et soit un bbox à quatre nombres soit null
var
  Lib: TPDFlib;
  Manifest: WideString;
begin
  Lib := TPDFlib.Create;
  try
    Manifest := Lib.GetPDFVCRManifest('campaign-template.pdf', '');
    if Manifest = '' then
      // 608 signifie que le fichier n'est pas conforme PDF/VCR-1,
      // 401 signifie que le fichier n'a pas pu être ouvert
      Writeln('No manifest, error ', Lib.LastErrorCode)
    else
      Writeln(Manifest);
  finally
    Lib.Free;
  end;
end;
Un détail à porter dans votre consommateur : la valeur page suit la convention de page zéro-based de toute la bibliothèque, pas la numérotation un-based qu'un humain voit dans une visionneuse. Les confondre est un off-by-one silencieux qui pose le contenu sur la mauvaise feuille, et aucun validateur ne l'attrapera parce que les deux nombres sont structurellement valides
Où sont les frontières
Le support PDF/VCR-1 dans PDFlibPas couvre l'écriture de modèles, la porte de sauvegarde, la preflight autonome et l'extraction de manifeste. Il n'effectue pas le remplacement. Substituer des données dans les placeholders et produire les instances personnalisées est l'étape de composition, et elle vit hors de la bibliothèque exprès, parce que le manifeste est précisément l'interface qui permet d'écrire un moteur de composition indépendamment. La porte de sauvegarde refuse aussi plutôt que répare. Contrairement aux profils où un mauvais drapeau d'annotation peut être normalisé silencieusement, chaque contrainte PDF/VCR-1 que PDFVCRReadyForSave applique est une où deviner changerait le sens du document : inventer une racine de modèle, ou choisir à quel champ appartient un placeholder non lié, produit un fichier qui valide et ment. La même ligne réparer-versus-refuser est discutée pour un autre profil dans le mode auteur PDF/E-1 et la preflight bornée, et le workflow pour lancer plusieurs vérifications de conformité sur un document est couvert dans le workbench de conformité et de signature
L'écriture, la marche de structure bornée, la porte de sauvegarde et l'extracteur de manifeste sont tous livrés dans la bibliothèque PDF Delphi PDFlibPas, ce qui signifie qu'un modèle peut être produit sous le profil puis vérifié via un chemin de code séparé qui n'a jamais vu l'état de l'écrivain, et cette séparation est la seule raison pour laquelle une revendication de conformité vaut quelque chose