Le dictionnaire d'un encodeur LZW garde toujours une entrée d'avance sur le décodeur qui lira sa sortie, si bien que les deux côtés ne peuvent pas partager un seul seuil de largeur de code. PDFlibPas donne à TPLLZWEncoder et TPDFLZWDecompressor des seuils séparés dérivés du même drapeau EarlyChange, et cette avance d'une entrée est toute la raison pour laquelle le drapeau existe
Quasiment toute implémentation LZW écrite à la main se trompe au même endroit. Vous écrivez le décodeur d'abord, parce que c'est ce qu'il faut pour ouvrir des fichiers. Ça marche. Puis vous écrivez l'encodeur, en reflétant la logique du décodeur ligne pour ligne parce que LZW est symétrique, vous lancez un test d'aller-retour, et ça passe. Vous livrez. Six mois plus tard un client ouvre votre sortie dans une visionneuse qui n'est pas la vôtre, et c'est du charabia à partir d'un point au milieu du flux. Le miroir était le bug : les deux moitiés de LZW ne sont pas symétriques, et faire comme si elles l'étaient produit des flux que seul votre propre code sait lire
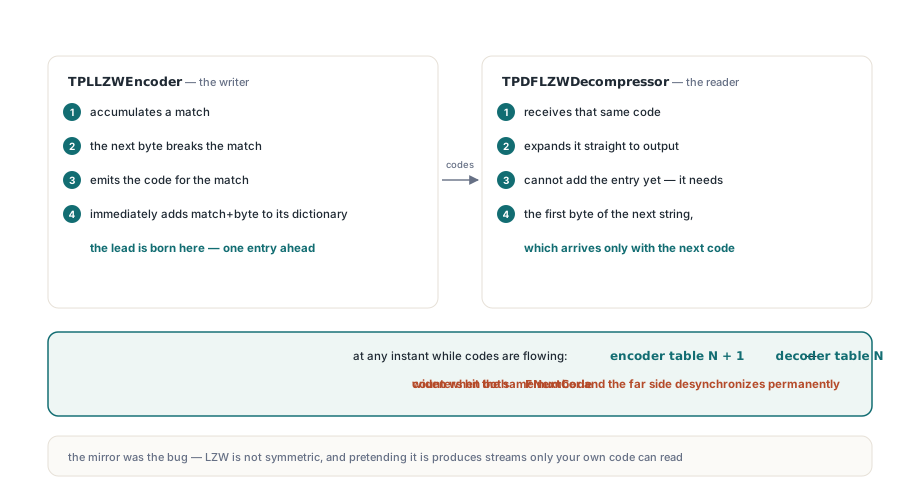
Pourquoi l'encodeur exige-t-il un seuil différent de celui du décodeur ?
Parce que l'encodeur apprend chaque entrée du dictionnaire une étape avant que le décodeur ne puisse le faire. Ce n'est pas un choix de conception dans PDFlibPas ; c'est inhérent au fonctionnement de LZW, et toute implémentation correcte doit compenser quelque part. Parcourez la boucle et vous verrez d'où vient l'avance. L'encodeur accumule une correspondance, découvre que l'octet suivant la casse, émet le code de la correspondance, puis ajoute immédiatement correspondance-plus-octet à son dictionnaire. Le décodeur reçoit ce même code et l'expand, mais il ne peut pas encore ajouter l'entrée correspondante, parce que la nouvelle entrée a besoin du premier octet de la chaîne suivante, qui n'arrive qu'avec le code suivant. Donc à tout instant où des codes circulent, la table de l'encodeur tient une entrée de plus que celle du décodeur. Si les deux côtés élargissent le code de 9 à 10 bits quand leur propre FNextCode atteint le même nombre, ils s'élargissent à un code d'écart et le lecteur de bits à l'autre bout se désynchronise définitivement. Dans TPDFLZWDecompressor.ResetDictionary, le seuil du décodeur est calculé une fois et stocké dans FChangeCode :
// TPDFLZWDecompressor.ResetDictionary : le côté décodeur du seuil
FCodeSize := FInitialCodeSize;                 // 9 pour LZWDecode en PDF
FBitMask  := (Cardinal(1) shl FCodeSize) - 1;  // 511
if FEarlyChange then
  FChangeCode := FBitMask                      // élargir quand FNextCode atteint 511
else
  FChangeCode := FBitMask + 1;                 // élargir quand FNextCode atteint 512
FClearCode := 1 shl (FCodeSize - 1);           // 256
FEOICode   := FClearCode + 1;                  // 257
FNextCode  := FClearCode + 2;                  // 258
La boucle de décodage élargit juste après avoir ajouté une entrée, en testant (FNextCode = FChangeCode) and (FCodeSize < 12) et en recalculant FBitMask et FChangeCode pour la nouvelle largeur. Neuf bits basculent à 511 ou 512, dix bits à 1023 ou 1024, onze bits à 2047 ou 2048, et douze bits est le plafond où le dictionnaire doit être vidé avec un ClearCode plutôt que d'être agrandi. L'encodeur ne peut réutiliser aucun de ces nombres. Son GrowCodeSize ajoute un pour compenser l'avance, donc avec EarlyChange réglé il élargit à 512 pendant que le décodeur élargit à 511 :
procedure GrowCodeSize(FinalDataCode: Boolean);
var
  ChangeCode: Cardinal;
begin
  if FCodeSize >= 12 then
    Exit;
  if FEarlyChange then
    ChangeCode := Cardinal(1) shl FCodeSize          // 512 tant qu'on est à 9 bits
  else
    ChangeCode := (Cardinal(1) shl FCodeSize) + 1;   // 513 tant qu'on est à 9 bits
  // Le décodeur ajoute sa dernière entrée en attente avant de lire EOI.
  if FinalDataCode then
    Dec(ChangeCode);
  if FNextCode = ChangeCode then
    Inc(FCodeSize);
  end;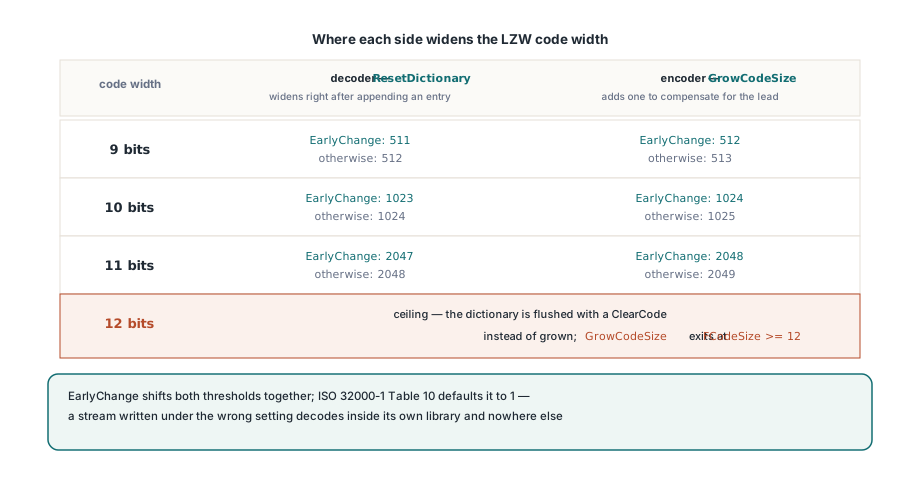
Le dernier code de données est là où les deux côtés se rejoignent enfin
La fin du flux est le seul endroit où l'encodeur doit cesser de mener et penser comme le décodeur, c'est à cela que sert le paramètre FinalDataCode sur GrowCodeSize. Émettez le code EOI à la mauvaise largeur et tout ce qui précède reste parfaitement valide, donc le défaut se cache derrière des milliers d'octets corrects. La séquence se déroule ainsi. L'encodeur émet son dernier code de données et, contrairement à chaque itération précédente, n'ajoute rien à son propre dictionnaire ensuite, parce qu'il ne reste aucun octet suivant pour étendre la correspondance. Le décodeur fait l'inverse : il reçoit ce code final, et c'est seulement maintenant qu'il peut compléter l'entrée qu'il tenait en attente depuis le précédent. À la dernière étape le décodeur rattrape, l'avance s'effondre à zéro, et la largeur qu'il utilisera pour lire EOI est décidée par une entrée que l'encodeur n'a jamais faite. Dec(ChangeCode) est l'encodeur qui fait semblant, pour exactement un appel, d'être le décodeur :
// TPLLZWEncoder.Compress, la queue du flux
EmitCode(CurCode);      // dernier code de données, à la largeur courante
GrowCodeSize(True);     // peut élargir en utilisant le seuil décrémenté
EmitCode(FEOICode);     // EOI à la largeur que le décodeur lira réellement
FlushBits;
FlushOutput;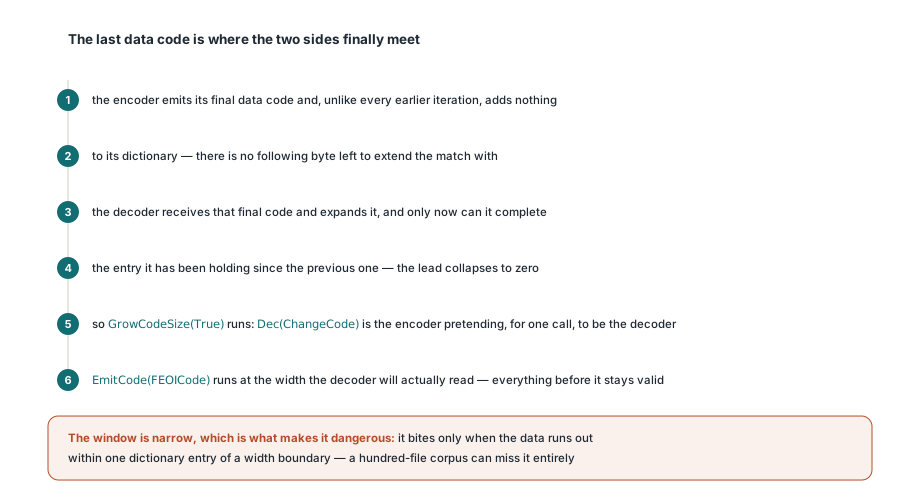
La fenêtre dans laquelle cela compte est étroite, c'est ce qui la rend dangereuse. Elle ne mord que quand les données s'épuisent par hasard à une entrée de dictionnaire près d'une frontière de largeur, donc un corpus d'une centaine de fichiers de test peut la manquer entièrement pendant qu'un fichier client la touche à chaque fois. Les cas limites dans Compress doivent être conduits délibérément : fabriquez des entrées dont le dictionnaire se pose à 510, 511 et 512 entrées, puis lisez à la main la largeur de bits de l'EOI émis depuis le flux plutôt que de l'inférer d'un décodage réussi
Pourquoi un test d'aller-retour qui passe peut-il encore cacher un flux cassé ?
Parce que deux implémentations qui font la même erreur sont d'accord entre elles. Si votre encodeur et votre décodeur élargissent tous les deux un code trop tôt, ou tous les deux un code trop tard, ils restent en verrouillage, l'aller-retour reproduit l'entrée octet pour octet, et la suite est verte pendant que le flux que vous avez produit est illisible par tout le reste. C'est la chose la plus précieuse à retenir de tout l'exercice : pour LZW, l'auto-cohérence ne vaut rien comme preuve. Donc l'auto-test d'aller-retour ne peut pas être le test principal, et PDFlibPas valide le chemin LZW de trois autres façons. Des flux de codes construits à la main avec le motif de bits attendu écrit à la main, pour que l'assertion porte sur les octets plutôt que sur le résultat de leur décodage. L'interopérabilité bidirectionnelle contre des implémentations indépendantes, où les flux produits par cet encodeur sont décodés ailleurs et les flux produits ailleurs sont décodés par TPDFLZWDecompressor. Et le décodage différentiel, qui lit les mêmes octets deux fois avec EarlyChange réglé dans les deux sens, pour qu'un flux qui se décode proprement sous le mauvais réglage vous dise que les frontières de largeur n'ont jamais été exercées du tout :
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := True;
  A := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
Dec := TPDFLZWDecompressor.Create;
try
  Dec.EarlyChange := False;   // délibérément la mauvaise règle pour le PDF
  B := Dec.Decompress(Stream);
finally
  Dec.Free;
end;
// A doit correspondre à la source ; B ne doit PAS correspondre. Si B correspond aussi,
// l'entrée était trop courte pour franchir une frontière de largeur de code.
Ce sont les entrées externes qui donnent réellement cette couverture. Le matériel de test actuel franchit les largeurs de 9, 10, 11 et 12 bits et force 34 réinitialisations de dictionnaire dans un seul flux, ce qui est la seule façon réaliste de prouver que le chemin ClearCode au plafond 4095 fonctionne. Si vos fixtures ne dépassent jamais quelques kilo-octets, aucun de ce code n'a jamais tourné. Et quand une correction change ce que votre encodeur produit, traitez l'ancienne sortie comme cassée plutôt que comme une base de compatibilité à préserver ; un flux qui mélange mal les largeurs de code n'est pas un format hérité, c'est un bug qui a fini par être écrit sur disque
Le PDF dit 1, le TIFF dit que ça dépend
PDFlibPas définit EarlyChange par défaut à True sur TPLLZWEncoder et TPDFLZWDecompressor parce que le tableau 10 d'ISO 32000-1 définit EarlyChange comme un paramètre de décodage LZWDecode avec une valeur par défaut de 1, ce qui signifie que la longueur de code augmente un code en avance. C'est spécifié dans la section 7.4.4.2 d'ISO 32000-1 à côté des paramètres de prédicteur, et un PDF qui veut l'autre comportement doit dire /EarlyChange 0 explicitement dans son dictionnaire /DecodeParms. Le TIFF est la raison pour laquelle le drapeau est une propriété plutôt qu'une constante : la section 13 du TIFF 6.0 décrit la compression LZW sans la même déclaration sans ambiguïté, et les encodeurs en circulation se sont historiquement divisés là-dessus, ce qui est très probablement la raison pour laquelle la spécification PDF a ressenti le besoin de nommer le paramètre. Sur un pipeline TIFF-vers-PDF, le réglage n'est donc pas quelque chose que vous pouvez coder en dur à l'un ou l'autre bout. Ce dont le côté TIFF a eu besoin doit être porté explicitement dans le /DecodeParms du PDF, sinon vous convertissez un fichier qui s'ouvrait bien en un fichier qui ne s'ouvre pas. Le même soin s'applique à FillOrder, où foTop et foBottom choisissent quelle extrémité de l'octet le lecteur de bits remplit, et au prédicteur horizontal 2 du TIFF, que TPDFLZWParms porte à travers Predictor, Colors, BitsPerComponent et Columns. Nos notes sur durcir le décodeur TIFF intégré pour BigTIFF et les layouts en tuiles couvrent le reste de ce chemin
Deux pièges plus petits qui méritent d'être nommés
Les deux sont faciles à câbler de travers quand vous avez l'encodeur et le décodeur ouverts côte à côte et que vous supposez que la symétrie tient aussi là :
InitialCodeSizene veut pas dire la même chose sur les deux classes.TPLLZWEncoder.InitialCodeSizeest la largeur de symbole racine, validée de 2 à 8, avecInitDictionaryqui dériveFClearCodecomme1 shl FInitialCodeSizeet règleFCodeSizeàFInitialCodeSize + 1.TPDFLZWDecompressor.InitialCodeSizeest la première largeur de code, validée de 2 à 9, avecResetDictionaryqui dériveFClearCodecomme1 shl (FCodeSize - 1). Pour des données PDF ordinaires à 8 bits, les valeurs par défaut sont 8 et 9 respectivement et vous ne le remarquez jamais ; réglez-les toutes les deux au même nombre à la main et vous avez construit une paire désaccordée- Décoder du LZW non fiable est un problème de sécurité mémoire avant d'être un problème de correction, parce que les index du dictionnaire viennent directement du fichier.
TPDFLZWDecompressorrejette tout code au-dessus de 4095 ou à ou au-dessus deFNextCode, refuse d'ajouter des entrées au-delà de 4095, vérifie l'entrée restante en bits avant chaqueGetNextCode, et exposeSawExplicitEOIpour qu'un appelant puisse distinguer un flux correctement terminé d'un flux qui a simplement manqué d'octets. Un flux tronqué n'est pas un succès partiel. L'étude plus large dans durcir un parseur PDF Pascal contre les fichiers malveillants couvre la classe de défauts que ces gardes ferment
Ce que cela vous laisse
LZW a l'air symétrique et ne l'est pas. Le dictionnaire de l'encodeur mène d'une entrée pendant le corps du flux et l'avance disparaît au code final, donc une implémentation correcte porte deux seuils plus un cas spécial, et le drapeau EarlyChange décale les deux seuils ensemble. Décalez l'un ou l'autre d'un seul code et vous produisez une sortie valide jusqu'au moment où elle ne l'est plus, sans erreur et sans exception nulle part, juste une visionneuse quelque part qui rend du bruit. La frontière honnête, c'est que rien de tout cela n'est testable de l'intérieur : rien dans votre propre suite ne peut distinguer un flux correct d'un flux systématiquement faux, donc la vérification d'interopérabilité n'est pas une passe supplémentaire optionnelle, c'est la seule vraie preuve que vous aurez jamais. Les deux classes sont livrées dans la PDF Library for Delphi, qui gère aussi le travail de structure environnant décrit dans nos notes sur les object streams et les cross-reference streams, pour Delphi et C++Builder à travers les versions de compilateur que la bibliothèque supporte