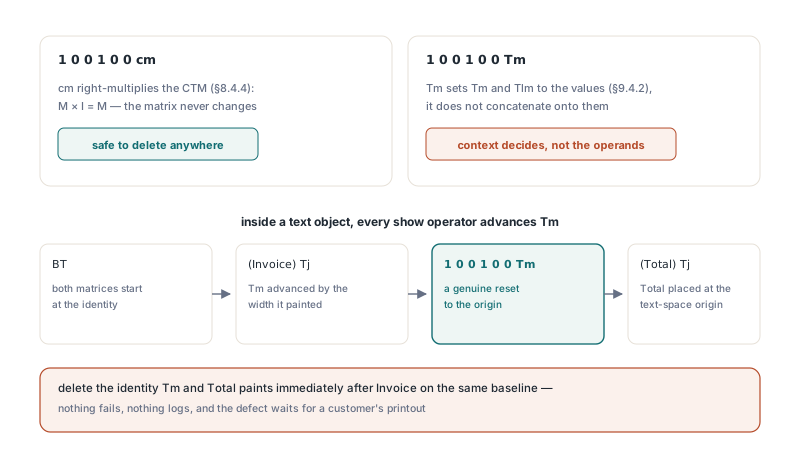
Prenez un flux de contenu qu'un générateur de rapports pourrait écrire, BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET, et retirez-en le 1 0 0 1 0 0 Tm parce que ses six nombres épellent la matrice identité. Rendez le résultat et "Total" ne commence plus à l'origine de l'espace texte. Il commence là où "Invoice" s'est achevé, sur la même ligne de base. Un Tm identité n'est redondant que tant que la matrice de texte et la matrice de ligne de texte portent déjà l'identité : directement après BT, ou directement après un autre Tm identité
La suppression est tentante parce que les mêmes six nombres sont vraiment du poids mort devant un cm. Un optimiseur de flux de contenu qui traite les deux opérateurs de la même façon rétrécira pléthore de flux correctement. Puis il rencontre un générateur qui utilise un Tm identité comme un retour chariot, et le texte bouge
Pourquoi 1 0 0 1 0 0 Tm n'est-il pas toujours un no-op ?
Les deux opérateurs font une arithmétique différente. ISO 32000-1 §8.4.4 définit cm comme concaténant son opérande avec la matrice de transformation courante ; multipliez n'importe quelle matrice par l'identité et vous récupérez la même matrice, si bien qu'un 1 0 0 1 0 0 cm peut être supprimé partout où il apparaît. Tm est une affectation. Au sens du §9.4.2 il met la matrice de texte et la matrice de ligne de texte à ses opérandes et jette ce qu'elles portaient, si bien qu'il change quelque chose ou non dépend entièrement des opérateurs devant lui
§9.4.1 dit que BT démarre les deux matrices à l'identité. De là, presque tout ce qui se trouve à l'intérieur d'un objet texte en déplace au moins une. Td, TD, T* et un Tm non identité repositionnent la matrice de ligne de texte. Chaque opérateur d'affichage de texte (Tj, TJ, ' et ") avance la matrice de texte de la largeur des glyphes qu'il vient de peindre, et les deux derniers commencent d'abord une nouvelle ligne. Une fois que l'un d'eux a tourné, un Tm identité est un vrai bond de retour à l'origine. Le flux de la facture ci-dessus dépend de ce bond
Tracer un flux à la main tranche vite la question. Passez l'exemple de la facture dans le traceur d'état CTM et matrice de texte de flux de contenu et l'enregistrement montre cm se concaténant à la CTM pendant que Tm écrase les deux matrices de texte — deux règles de mise à jour différentes cachées derrière des opérandes identiques
Comment PDF Library for Delphi décide quel Tm identité jeter
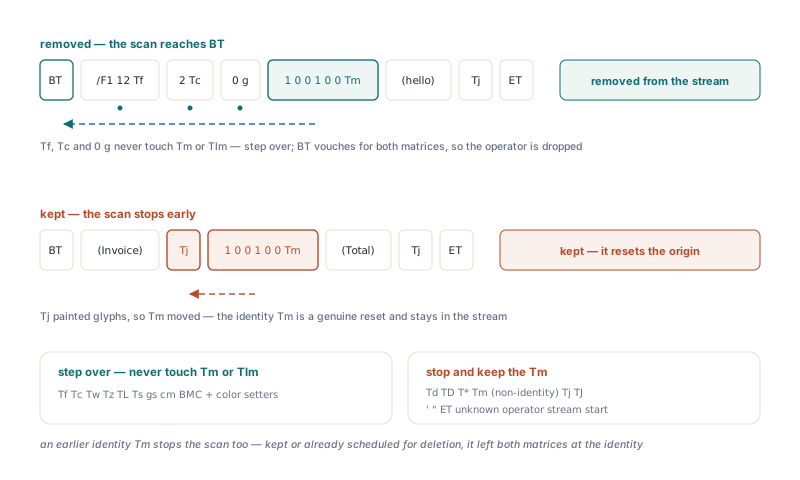
PDF Library for Delphi laisse tomber chaque cm identité pendant sa passe peephole, et ne laisse tomber un Tm identité que quand un scan à reculons depuis cet opérateur atteint BT ou un autre Tm identité avant de rencontrer quoi que ce soit qui aurait pu bouger les matrices de texte. Le test d'"identité" est numérique : l'opérateur exige exactement six opérandes numériques valant 1, 0, 0, 1, 0, 0, si bien qu'un 1.0 0 0 1.0 0 0 Tm qualifie aussi. En marchant à reculons, le scan range chaque opérateur rencontré dans l'un de deux groupes :
- S'arrêter et garder le Tm :
Td,TD,T*, unTmnon identité,Tj,TJ,',",ET, tout opérateur que le parseur ne reconnaît pas, ou le début du flux - Passer outre et continuer à scanner : les opérateurs qui ne touchent jamais la matrice de texte ni la matrice de ligne de texte, tels que
Tf,Tc, les réglages de couleur,gs, les opérateurs de contenu marqué,Doetcm
Un Tm identité antérieur termine le scan en faveur de la suppression, que l'optimiseur le garde ou l'ait déjà programmé pour le retrait. De toute façon il a laissé les deux matrices à l'identité, le même état que laisse BT. Voilà pourquoi une série de trois opérateurs Tm identité juste après BT se réduit à néant
Les arrêts conservateurs sont délibérés. Un opérateur inconnu pourrait être une extension de vendeur qui fait n'importe quoi, si bien que le scan refuse de raisonner au-delà. Après ET il n'y a pas d'objet texte ouvert, et un Tm identité assis là n'a aucun BT qui plaide pour les valeurs des matrices. Le scan regarde aussi un seul flux de contenu à la fois. Cela compte pour les pages dont /Contents est un tableau : le PDF laisse un objet texte commencer dans un flux et continuer dans le suivant, si bien qu'une couche qui s'ouvre au milieu d'un objet texte, sans BT propre, garde son Tm identité même quand la couche précédente l'aurait rendu redondant
Nous pensons que c'est le bon côté où se tromper. Suivre les matrices à travers les frontières de flux, ou simuler les opérateurs inconnus, récupérerait peut-être quatorze octets de texte non compressé par fichier bizarre. Se tromper déplace un glyphe sur une facture imprimée. Le coût et le risque ne jouent pas dans la même cour
Un effet de bord vaut d'être connu parce qu'il change ce que vous voyez dans la sortie. La même passe retire aussi les objets texte sans rien à l'intérieur, si bien qu'un BT 1 0 0 1 0 0 Tm ET disparaît complètement : le Tm identité part d'abord, et la paire BT/ET qu'il laisse derrière est vide
Faire tourner l'optimiseur sur un extrait de flux de contenu
L'optimiseur travaille sur le même modèle TPDFContentProgram parsé que vous utiliseriez pour éditer le texte de page au niveau des instructions, comme dans la visite guidée de la cartographie caractère-vers-octet de contenu. Cela rend facile l'essai de la règle sur une chaîne avant de lui confier un document entier. Le helper ci-dessous parse un flux décodé, fait tourner TPDFContentPeepholeOptimizer, et émet le résultat une instruction par ligne. Régler CanonicalNumbers avant Parse reflète la passe de sauvegarde, qui réécrit chaque nombre à une précision fixe
uses
  PDFlibContentModel, PDFlibContentOptimize;

function OptimizeSnippet(const Source: AnsiString): AnsiString;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
begin
  Result := Source;
  Prog := TPDFContentProgram.Create;
  try
    Prog.CanonicalNumbers := True; // même gestion des nombres que la passe de sauvegarde
    if not Prog.Parse(Source) then
      Exit; // dégâts structurels majeurs : on laisse les octets tranquilles
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run; // renvoie le nombre d'instructions retirées
    finally
      Optimizer.Free;
    end;
    Result := Prog.Emit; // une instruction par ligne, séparée par #10
  finally
    Prog.Free;
  end;
end;

// Retiré : Tm juste après BT, le second de deux Tm identité d'affilée
//   OptimizeSnippet('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET')
// Gardé : Tm après Td, après Tj, après un Tm non identité, ou hors BT
//   OptimizeSnippet('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET')
Faites passer le flux de la facture par lui et le Tm identité survit, parce que le scan à reculons bute sur Tj bien avant d'atteindre BT. Mettez /F1 12 Tf, 2 Tc et 0 g entre BT et le Tm identité et il part quand même, car rien de cela ne touche les matrices de texte. Le cas intéressant est BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm. Il perd exactement un opérateur. Le premier Tm identité défait le déplacement que Td a fait, et seul le second est redondant
Parse ne renvoie False que sur des dégâts majeurs tels qu'une chaîne ou un dictionnaire non terminé. Les opérateurs inconnus se parsent très bien et restent dans le programme, où ils servent d'arrêts durs pour le scan
Quand l'optimiseur peephole tourne-t-il réellement ?
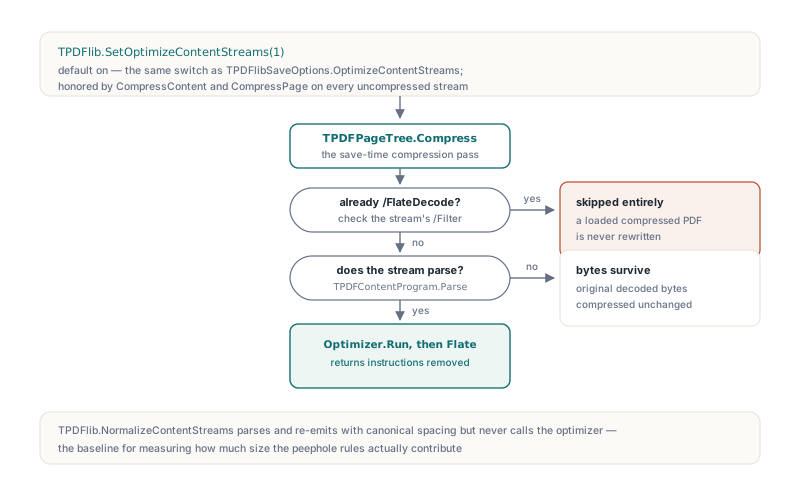
L'optimiseur ne tourne qu'à l'intérieur de la passe de compression, et seulement sur les flux de contenu de page qui ne sont pas déjà compressés en Flate. TPDFlib.SetOptimizeContentStreams(1) est le défaut, et le même interrupteur apparaît comme le champ OptimizeContentStreams de TPDFlibSaveOptions ; CompressContent et CompressPage l'honorent tous les deux. Un flux dont /Filter est déjà /FlateDecode est carrément sauté, si bien que charger un PDF compressé typique et le sauvegarder à nouveau laisse ses opérateurs exactement tels qu'ils étaient. Les flux stockés non compressés sont décodés, optimisés puis compressés en Flate. Si un flux échoue à l'analyse, ses octets décodés d'origine sont compressés inchangés
var
  Lib: TPDFlib;
  Options: TPDFlibSaveOptions;
begin
  Lib := TPDFlib.Create;
  try
    if Lib.LoadFromFile('report.pdf', '') <> 1 then
      Exit;
    // Les flux de page non compressés passent par les règles peephole, puis Flate
    Lib.SetOptimizeContentStreams(1);
    Lib.CompressContent;
    Lib.SaveToFile('report-optimized.pdf');

    // Le même choix via les options de sauvegarde groupées ; False désactive
    Options.CompressContent := True;
    Options.CompressFonts := True;
    Options.CompressImages := True;
    Options.Linearize := False;
    Options.KeepModDate := False;
    Options.OptimizeContentStreams := False;
    Options.GarbageCollect := False;
    Options.PackObjectStreams := True;
    Lib.SaveToFileOptions('report-plain.pdf', Options);
  finally
    Lib.Free;
  end;
end;
Laissez le défaut actif. Chaque transformation de la passe est équivalente en sortie, et la règle de la matrice identité chasse un motif que beaucoup de générateurs émettent, en ouvrant chaque objet texte par BT 1 0 0 1 0 0 Tm. L'éteindre a du sens surtout quand vous voulez comparer votre propre sortie non compressée à ce que vous avez écrit, ou quand vous avez besoin d'une base de référence. Pour cette base, TPDFlib.NormalizeContentStreams parse et réémet le contenu avec espacement et nombres canoniques mais n'appelle jamais l'optimiseur, si bien que l'écart de taille entre une sauvegarde normalisée et une sauvegarde optimisée est ce que les règles peephole ont apporté. Attendez-vous à ce qu'il soit modeste à côté des gains plus gros décrits dans l'optimisation de la taille des fichiers PDF avec sous-ensemble de polices
Un test qui couvre une seule forme ne définit pas la règle
Un test qui donne BT 1 0 0 1 0 0 Tm (hello) Tj ET à un optimiseur et affirme qu'aucun Tm ne reste épingle une seule forme : un Tm identité directement après BT est retiré. Il ne dit rien d'un Tm identité après Td ou après du texte affiché. Lire cette seule assertion comme "un Tm identité est toujours retirable" est une erreur facile, et coûteuse, car l'échantillon passe dans les deux cas. Les tests de toute règle de ce genre ont besoin que les formes gardées soient écrites à côté des formes retirables
Le helper ci-dessous compte les opérateurs Tm qui survivent, puis vérifie une table d'entrées. Remplacez ExpectTm par l'assertion de votre framework de test ; il ne fait pas partie de la bibliothèque
uses
  SysUtils, PDFlibContentModel, PDFlibContentOps, PDFlibContentOptimize;

function TmCountAfterOptimize(const Source: AnsiString): Integer;
var
  Prog: TPDFContentProgram;
  Optimizer: TPDFContentPeepholeOptimizer;
  I: Integer;
begin
  Result := -1; // -1 signale un échec d'analyse
  Prog := TPDFContentProgram.Create;
  try
    if not Prog.Parse(Source) then
      Exit;
    Optimizer := TPDFContentPeepholeOptimizer.Create(Prog);
    try
      Optimizer.Run;
    finally
      Optimizer.Free;
    end;
    Result := 0;
    for I := 0 to Prog.Count - 1 do
      if Prog[I].Op = coTextMatrix then
        Inc(Result);
  finally
    Prog.Free;
  end;
end;

// Votre propre helper de contrôle, proposé ici ; remplacez-le par une vraie assertion
procedure ExpectTm(const Source: AnsiString; Expected: Integer);
var
  Actual: Integer;
begin
  Actual := TmCountAfterOptimize(Source);
  if Actual <> Expected then
    raise Exception.CreateFmt('%s: expected %d Tm, got %d',
      [string(Source), Expected, Actual]);
end;

procedure CheckIdentityTmRule;
begin
  // Formes retirables
  ExpectTm('BT /F1 12 Tf 1 0 0 1 0 0 Tm (hello) Tj ET', 0);
  ExpectTm('BT 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  ExpectTm('BT /F1 12 Tf 2 Tc 0 g 1 0 0 1 0 0 Tm (a) Tj ET', 0);
  // Formes qui doivent garder le Tm identité
  ExpectTm('BT (Invoice) Tj 1 0 0 1 0 0 Tm (Total) Tj ET', 1);
  ExpectTm('BT 10 20 Td 1 0 0 1 0 0 Tm 1 0 0 1 0 0 Tm (a) Tj ET', 1);
  ExpectTm('BT 2 0 0 2 5 5 Tm (a) Tj 1 0 0 1 0 0 Tm (b) Tj ET', 2);
  ExpectTm('1 0 0 1 0 0 Tm (a) Tj', 1);    // sans BT englobant
  ExpectTm('BT ET 1 0 0 1 0 0 Tm', 1);     // après ET
end;
Les deux dernières lignes ont l'air ridicules jusqu'à ce qu'on se rappelle que des tableaux /Contents en couches produisent exactement ces fragments. Un flux qui commence au milieu d'un objet texte n'a pas de BT, et un Tm identité après ET n'appartient à aucun objet texte du tout. Les deux restent. La paire BT ET vide de la dernière ligne est retirée par la règle de l'objet texte vide, et voilà pourquoi le compte vérifie les opérateurs Tm au lieu de comparer des chaînes entières
Ce que la règle abandonne, c'est le Tm identité occasionnel au milieu d'un objet texte, quelques octets par page avant même que Flate ne les voie. Ce qu'elle achète est une garantie sur laquelle repose la conception de l'optimiseur : aucune transformation de la passe ne change la page visible. Un optimiseur de taille qui déplace du texte est un bug de rendu avec un bon taux de compression
Si vous générez ou post-traitez du contenu PDF en Delphi ou C++Builder, la PDF Library for Delphi et C++Builder livre le parseur de flux de contenu, cette passe peephole et les options de sauvegarde montrées ci-dessus, avec NormalizeContentStreams pour produire une base de référence propre et non optimisée à comparer