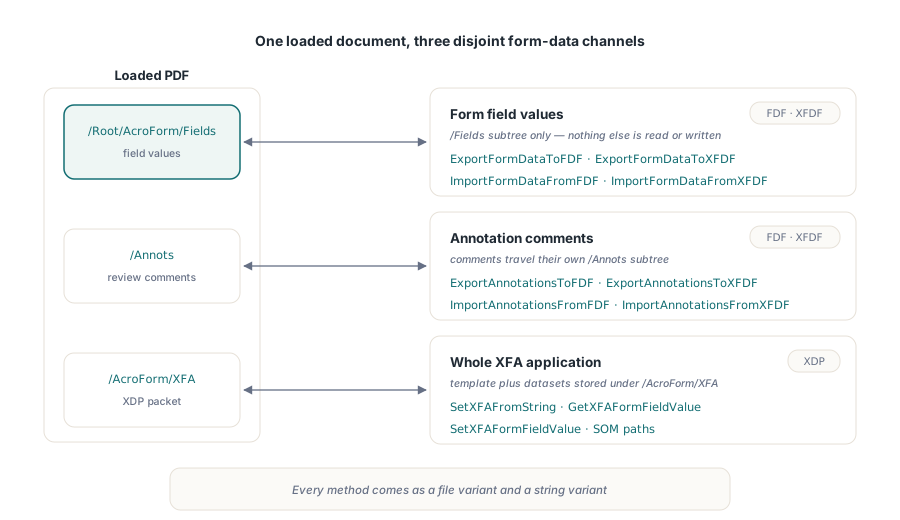
losLab PDF Library fait entrer et sortir les données de formulaire d'un PDF de trois manières différentes : FDF et XFDF pour les valeurs de champs AcroForm, ces deux mêmes formats pour les commentaires d'annotation, et un paquet XFA XDP entier écrit directement dans le formulaire. ExportFormDataToXFDF, ImportFormDataFromXFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF et SetXFAFromString sont les points d'entrée, et chacun d'eux possède une variante fichier et une variante chaîne
S'il y a autant de méthodes, c'est que les données de formulaire PDF ne sont pas une seule chose. Un AcroForm rempli porte des valeurs de champs, il peut aussi porter des commentaires de relecture, et un formulaire XFA hérité incorpore toute une description applicative XML qui n'a rien à voir ni avec l'un ni avec l'autre. losLab PDF Library garde ces trois préoccupations sur des API séparées à dessein, car les fusionner imposerait le mauvais modèle de données à au moins deux d'entre elles. Décider de quelle famille vous avez besoin est le premier choix de conception, et il est en général tranché dès que vous savez ce que consomme réellement le système récepteur en face
Quelle est la différence entre les données de formulaire FDF, XFDF et XFA ?
FDF et XFDF portent la même information dans deux syntaxes différentes, et XFA est un monde à part. FDF est un document miniature en syntaxe PDF (ISO 32000-2 §12.7.8) : un tableau /Fields de dictionnaires << /T (name) /V (value) >>, avec des chaînes échappées exactement comme le sont les chaînes littérales à l'intérieur d'un PDF. XFDF est la forme XML des mêmes données (ISO 19444), un arbre <fields> qu'Acrobat et la plupart des back-ends de formulaires lisent et écrivent nativement. XFA n'est ni l'un ni l'autre : c'est un modèle XML Forms Architecture accompagné de ses données, stocké sous forme de XML Data Package (XDP) que le PDF référence depuis /AcroForm/XFA. Choisissez FDF ou XFDF quand vous échangez des valeurs de champs, et ne recourez à XFA que si vous maintenez un document rédigé dès l'origine comme un formulaire XFA
À l'intérieur de FDF et XFDF, losLab PDF Library trace une seconde ligne : valeurs de champs contre commentaires d'annotation. La famille des données de formulaire (ExportFormDataToFDF, ImportFormDataFromFDF, ExportFormDataToXFDF, ImportFormDataFromXFDF) lit et écrit le sous-arbre /Fields et ne touche à rien d'autre. La famille des annotations (ExportAnnotationsToFDF, ImportAnnotationsFromFDF, ExportAnnotationsToXFDF, ImportAnnotationsFromXFDF) lit et écrit le sous-arbre /Annots à la place, ce qu'Acrobat appelle Export Comments. Les deux ne se recouvrent jamais : exporter des valeurs de champs ne ramassera pas au passage des notes de relecture égarées, et importer des commentaires ne dérangera pas les valeurs déjà saisies par un utilisateur. Ce que fait un widget lorsqu'on clique dessus ou qu'il est recalculé est encore une troisième préoccupation, traitée dans la note compagnon sur les actions de formulaire interactif et JavaScript
Comment remplir un formulaire PDF depuis FDF ou XFDF en Delphi ?
Chargez le document, appelez une méthode d'import, puis enregistrez. ImportFormDataFromXFDF et ImportFormDataFromFDF analysent chacune les données de formulaire entrantes, associent chaque entrée à un champ AcroForm par son nom pleinement qualifié, affectent la valeur et renvoient le nombre de champs réellement mis à jour. Les deux méthodes ne mettent à jour que les champs qui existent déjà dans le PDF cible ; aucune n'invente de champ pour un nom que le formulaire ne définit pas, ce qui empêche un fichier de données égaré ou hostile de faire grossir votre formulaire en silence
var
  Lib: TPDFlib;
  FieldsSet: Integer;
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('application-blank.pdf', '');
    // XFDF produit par un système de gestion de dossiers, déjà en UTF-8 sur le disque
    FieldsSet := Lib.ImportFormDataFromXFDF('applicant-1042.xfdf');
    if FieldsSet > 0 then
      Lib.SaveToFile('application-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Deux détails décident si des données non triviales survivent au voyage. Le premier est l'échappement : FDF stocke les valeurs en chaînes littérales PDF, si bien qu'une valeur contenant une parenthèse, une barre oblique inverse ou un octet non imprimable arrive enveloppée dans l'échappement octal défini par l'ISO 32000-2 §7.3.4.2, et losLab PDF Library inverse cet échappement à l'import pour que les parenthèses et les barres reviennent sous forme des caractères littéraux saisis par l'utilisateur. Le second est l'encodage : les méthodes fondées sur des fichiers écrivent et lisent XFDF et FDF en UTF-8, ce que promet la déclaration XFDF et ce dont toute valeur de champ non ASCII (un nom accentué, un symbole monétaire, une adresse CJK) a besoin pour faire l'aller-retour sans corruption. Si vous fabriquez le XFDF vous-même, déclarez UTF-8 et écrivez en UTF-8, et l'import sera d'accord avec vous
Champs hiérarchiques, choix multivalués et texte enrichi
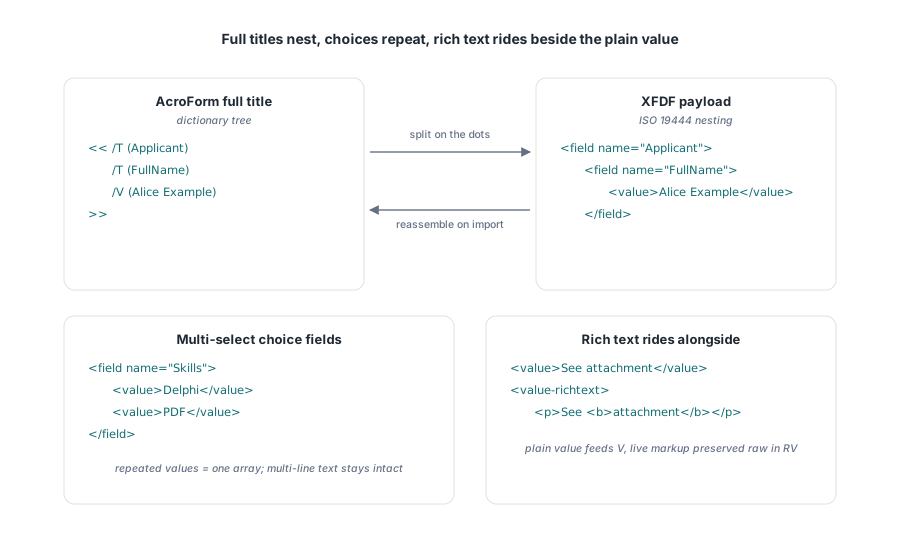
Les noms de champs hiérarchiques sont le premier endroit où casse un exportateur naïf. AcroForm adresse un champ imbriqué par un titre complet pointé tel que Applicant.FullName, mais XFDF ne met pas cette chaîne pointée dans un attribut de nom unique ; l'ISO 19444 l'imbrique, sous la forme <field name="Applicant"><field name="FullName">. losLab PDF Library découpe le titre pointé en éléments <field> imbriqués à l'export et réassemble les éléments imbriqués en titre complet à l'import, de sorte que les deux directions restent symétriques. À l'export, elle saute aussi les champs parents non terminaux, car un nœud parent dans un AcroForm ne porte que le niveau de nommage et n'a pas de valeur propre ; l'émettre produirait un <value></value> vide qui ne correspond pas au formulaire réel. Les listes à sélection multiple sont le deuxième piège : un champ de choix peut retenir plusieurs valeurs sélectionnées à la fois, ce que XFDF exprime par des éléments <value> répétés et FDF par un tableau /V, et losLab PDF Library ne scinde un champ en plusieurs valeurs que lorsqu'il s'agit véritablement d'un choix à sélection multiple, si bien qu'un simple champ texte multiligne conserve ses sauts de ligne au lieu d'éclater en valeurs fictives
Le texte enrichi est le troisième piège, et celui que l'on rate le plus souvent. Un champ mis en forme stocke son balisage dans l'entrée RV sous forme de sous-arbre XHTML, et XFDF le transporte dans <value-richtext>. losLab PDF Library écrit ce sous-arbre comme un fragment XML vivant plutôt que de l'échapper, si bien qu'un outil en aval lit du vrai texte enrichi et non une suite de balises visibles ; à l'import, elle préserve le sous-arbre RV brut tout en appliquant la valeur simple <value> à V. Là où un champ offre les deux, la valeur simple l'emporte pour V et le texte enrichi voyage à côté dans RV, règle d'interopérabilité qui empêche un import de texte enrichi de réécrire discrètement une valeur qu'un autre outil avait déjà posée. Quand votre texte enrichi existe pour transmettre la structure du document aux technologies d'assistance, traitez-le comme vous traiteriez l'ordre de lecture évoqué dans la note sur le PDF balisé et la structure d'accessibilité
var
  Lib: TPDFlib;
const
  XFDF =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xfdf xmlns="http://ns.adobe.com/xfdf/" xml:space="preserve">' +
    '<fields>' +
    '  <field name="Applicant">' +
    '    <field name="FullName"><value>Alice Example</value></field>' +
    '  </field>' +
    '  <field name="Skills">' +
    '    <value>Delphi</value><value>PDF</value>' +
    '  </field>' +
    '  <field name="Notes">' +
    '    <value>See attachment</value>' +
    '    <value-richtext><body><p>See <b>attachment</b></p></body></value-richtext>' +
    '  </field>' +
    '</fields></xfdf>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.LoadFromFile('intake.pdf', '');
    // Applicant.FullName se réassemble ; Skills remplit les tableaux /V + /I ;
    // Notes reçoit V depuis <value> et RV depuis <value-richtext>
    Lib.ImportFormDataFromXFDFString(XFDF);
    Lib.SaveToFile('intake-filled.pdf');
  finally
    Lib.Free;
  end;
end;
Comment faire l'aller-retour des commentaires d'annotation en FDF ou XFDF ?
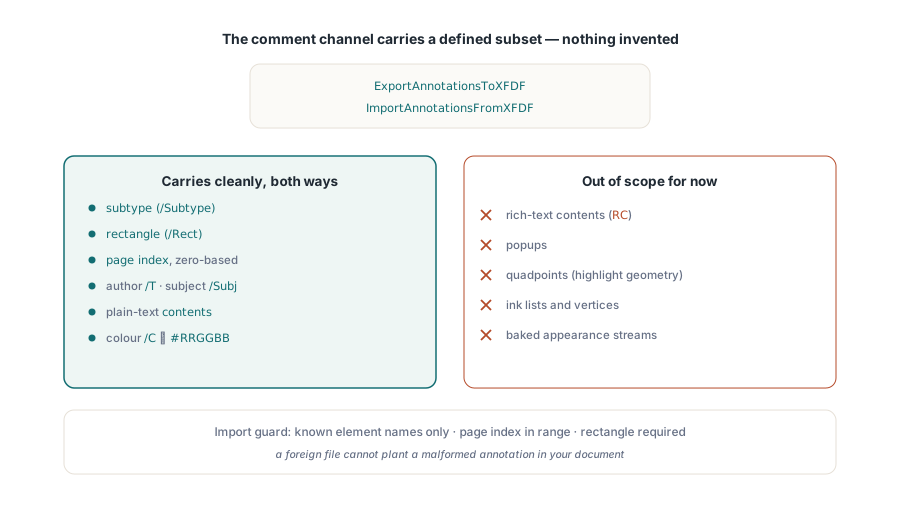
Les commentaires voyagent sur la famille des annotations, et le sous-ensemble pris en charge est délibérément restreint. ExportAnnotationsToXFDF et ImportAnnotationsFromXFDF, avec leurs équivalents FDF, transportent le balisage de style texte avec les champs qui font réellement l'aller-retour proprement : le sous-type de l'annotation, son rectangle, son index de page à base 0, l'auteur dans T, le sujet dans Subj, le Contents simple, et la couleur, qui fait correspondre le triplet DeviceRGB /C du PDF à un attribut XFDF #RRGGBB dans les deux sens. L'import n'accepte que des noms d'éléments connus et saute toute entrée dont la page est hors plage ou dont le rectangle manque, si bien qu'un XFDF retouché à la main ou d'origine étrangère ne peut pas déposer une annotation malformée dans le document. Ce que ce sous-ensemble ne transporte pas encore mérite d'être dit franchement : le contenu en texte enrichi (RC), les popups, les quadpoints, les listes de traits, les sommets et les flux d'apparence cuits sont hors périmètre pour l'instant, donc la géométrie de surlignage et les apparences de tampons personnalisés ne survivront pas à ce chemin. Pour confirmer ce qui a réellement atterri, parcourez les annotations de page ou l'arbre d'éléments plus large traité dans la recherche de texte et l'énumération des éléments de page
var
  Src, Dest: TPDFlib;
  Xfdf: WideString;
begin
  Src := TPDFlib.Create;
  Dest := TPDFlib.Create;
  try
    Src.LoadFromFile('reviewed.pdf', '');
    Xfdf := Src.ExportAnnotationsToXFDFString;   // sous-ensemble <annots> uniquement

    Dest.LoadFromFile('clean-copy.pdf', '');     // les pages doivent correspondre par index
    Dest.ImportAnnotationsFromXFDFString(Xfdf);
    Dest.SaveToFile('clean-copy-commented.pdf');
  finally
    Dest.Free;
    Src.Free;
  end;
end;
Écrire un paquet XFA XDP complet avec SetXFAFromString
XFA est le cas atypique, et SetXFAFromString est la manière de tout écrire d'un coup. La méthode prend un XML Data Package complet, le document <xdp:xdp> avec ses paquets template et datasets, et le stocke comme le flux référencé depuis /AcroForm/XFA. losLab PDF Library crée le conteneur AcroForm à la demande lorsque le document n'en a pas, vous n'avez donc pas à ajouter un champ jetable juste pour donner un point d'accroche au XFA, et elle jette tout état XFA analysé qu'elle détenait pour qu'une lecture ultérieure reflète le paquet que vous venez d'écrire plutôt qu'un cache périmé. Comme un paquet XFA est du XML et pas nécessairement de l'UTF-8, la bibliothèque détecte une marque d'ordre des octets UTF-16 et décode le paquet correctement avant l'analyse, ce qui compte pour les paquets produits par des outils dont le défaut est UTF-16
Une fois le paquet en place, GetXFAFormFieldValue et SetXFAFormFieldValue adressent les champs individuels par leur chemin dans le Scripting Object Model. losLab PDF Library accepte les racines SOM standard aussi bien que les chemins relatifs nus, si bien que form1.FullName, $data.form1.FullName et xfa.datasets.data.form1.FullName se résolvent tous vers le même nœud de données, et le côté template accepte $template et xfa.template de la même façon. Cette tolérance compte quand les chemins SOM sont générés par un autre système qui émet toujours la forme pleinement qualifiée
var
  Lib: TPDFlib;
const
  Xdp =
    '<?xml version="1.0" encoding="UTF-8"?>' +
    '<xdp:xdp xmlns:xdp="http://ns.adobe.com/xdp/">' +
    '  <template xmlns="http://www.xfa.org/schema/xfa-template/3.3/">' +
    '    <subform name="form1">' +
    '      <field name="FullName"><ui><textEdit/></ui></field>' +
    '    </subform>' +
    '  </template>' +
    '  <xfa:datasets xmlns:xfa="http://www.xfa.org/schema/xfa-data/1.0/">' +
    '    <xfa:data><form1><FullName>Alice Example</FullName></form1></xfa:data>' +
    '  </xfa:datasets>' +
    '</xdp:xdp>';
begin
  Lib := TPDFlib.Create;
  try
    Lib.SetXFAFromString(Xdp, 0);      // crée le conteneur AcroForm si aucun n'existe
    // relecture via le DOM de données avec un chemin SOM
    if Lib.GetXFAFormFieldValue('form1.FullName') = 'Alice Example' then
      Lib.SetXFAFormFieldValue('form1.FullName', 'Bob Example');
    Lib.SaveToFile('xfa-packet.pdf');
  finally
    Lib.Free;
  end;
end;
Le résumé honnête est que les valeurs de champs font l'aller-retour intégralement via FDF et XFDF, hiérarchie, sélection multiple et texte enrichi compris ; que les commentaires d'annotation font l'aller-retour sous forme d'un sous-ensemble de balisage textuel défini avec des lacunes claires ; et que XFA est écrit et lu comme un paquet entier, avec en plus un accès par champ via SOM. Adaptez le format au consommateur, déclarez UTF-8 pour tout ce que vous fabriquez à la main, et rappelez-vous que les méthodes d'import ne touchent jamais qu'aux champs et aux annotations qui cadrent déjà avec le document. Les méthodes de données de formulaire, d'annotation et de XFA décrites ici font partie de losLab PDF Library pour Delphi et C++Builder, dont la référence porte la liste complète des paramètres de chaque point d'entrée d'export et d'import