Une facture en chinois composée en Noto Sans SC à partir de son fichier .otf peut s'ouvrir dans mutool avec des idéogrammes sans rapport là où devrait figurer le nom du client, alors qu'une police TrueType rend la même page correctement. La cause, c'est le charset CFF de la police : PDFlibPas le réécrit à l'identité dans la copie embarquée, si bien que les codes d'indice de glyphe atteignent les glyphes visés
Qu'une police montre le problème dépend de la façon dont elle a été construite. Un programme TrueType embarqué comme police CIDFontType2 reçoit un CIDToGIDMap à Identity, et le code du flux de contenu tombe sur le bon glyphe. La plupart des polices OpenType latines à contours CFF sont name-keyed, et un programme CFF name-keyed utilise le CID entrant directement comme indice de glyphe. L'ISO 32000-1 remarque même, en §9.7.4.2, que CID et GID coïncident dans beaucoup de polices. Pas dans toutes. Les grandes familles CJK construites comme polices CID-keyed — Noto Sans CJK et ses sœurs Source Han parmi elles — portent leur propre numérotation de CID, et un générateur qui envoie des indices de glyphe directement dans cette numérotation obtient le glyphe qui se trouve posséder le CID correspondant
Ce qu'un programme CFF CID-keyed fait d'un CID
L'ISO 32000-1 §9.7.4.2 partage les programmes CFF embarqués en deux cas selon le Top DICT. Si le Top DICT utilise les opérateurs CIDFont — en pratique, il s'ouvre avec ROS (opérateur 12 30 : registry, ordering, supplement) — le lecteur prend le CID du flux de contenu, cherche le glyphe dont l'entrée de charset porte ce CID, et ce n'est qu'alors qu'il va chercher le contour dans le CharStrings INDEX. Sans opérateurs CIDFont, le CID est l'indice de glyphe. Le charset ne joue aucun rôle. Tout lecteur qui suit le §9.7.4.2 à la lettre dessinera donc le mauvais glyphe pour un code d'indice de glyphe chaque fois que le charset n'est pas l'identité, quel que soit le viewer choisi. Le charset lui-même, défini dans l'Adobe Technical Note #5176, existe en trois mises en page avec deux cas particuliers :
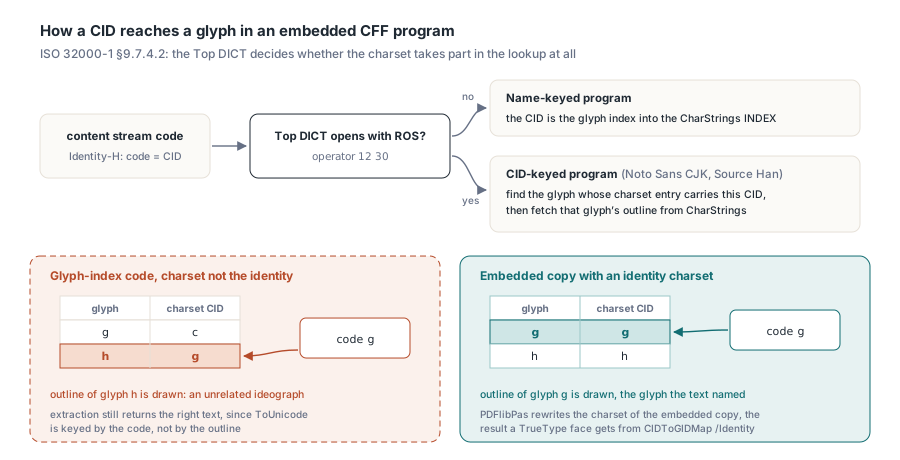
- Le format 0 stocke un SID ou CID de 2 octets par glyphe, dans l'ordre des glyphes
- Le format 1 stocke des plages : un premier CID suivi d'un compte sur 1 octet des glyphes qui le suivent avec des CIDs consécutifs
- Le format 2 reprend la même mise en page de plages avec un compte sur 2 octets, ce qui convient aux polices aux longues suites ininterrompues
- Le glyphe 0 est
.notdefet n'a d'entrée dans aucun format ; un décalage de charset de 0, 1 ou 2 désigne l'un des charsets prédéfinis au lieu de pointer vers des données
Commencez donc par déterminer le type de police en présence. Identity-H côté PDF dit seulement qu'un code de 2 octets égale le CID. La façon dont ce CID atteint un glyphe vit entièrement dans le programme de police. La fonction ci-dessous lit la table CFF d'un .otf, parcourt le Top DICT à la recherche de ROS, et vérifie si le charset mappe chaque glyphe vers un CID de même numéro. Elle ne demande que la RTL
uses
  System.SysUtils, System.IOUtils;

type
  TCFFCharsetReport = record
    IsCFF, CIDKeyed, IdentityCharset: Boolean;
    CharsetFormat, GlyphCount: Integer;
  end;

{$RANGECHECKS ON}  // un fichier tronqué lève ERangeError au lieu de mal lire
function InspectOtfCharset(const FileName: string): TCFFCharsetReport;
var
  B: TBytes;
  NumTables, I, Cff, P, Dict, DictEnd, Unused1, Unused2: Integer;
  Op, Operand, CharsetOfs, CharStringsOfs, G, Left: Integer;

  function BE(Pos, Count: Integer): Integer;
  var
    K: Integer;
  begin
    Result := 0;
    for K := 0 to Count - 1 do
      Result := (Result shl 8) or B[Pos + K];
  end;

  // Renvoie la fin du INDEX à Pos et cadre son premier objet
  function SkipIndex(Pos: Integer; out ObjStart, ObjEnd: Integer): Integer;
  var
    Count, OffSize, Base: Integer;
  begin
    Count := BE(Pos, 2);
    if Count = 0 then
    begin
      ObjStart := Pos + 2;
      ObjEnd := ObjStart;
      Exit(Pos + 2);
    end;
    OffSize := B[Pos + 2];
    Base := Pos + 2 + (Count + 1) * OffSize;  // décalages base 1 à partir d'ici
    ObjStart := Base + BE(Pos + 3, OffSize);
    ObjEnd := Base + BE(Pos + 3 + OffSize, OffSize);
    Result := Base + BE(Pos + 3 + Count * OffSize, OffSize);
  end;

begin
  Result := Default(TCFFCharsetReport);
  Result.CharsetFormat := -1;
  B := TFile.ReadAllBytes(FileName);
  if (Length(B) < 12) or (BE(0, 4) <> $4F54544F) then  // 'OTTO'
    Exit;
  Cff := -1;
  NumTables := BE(4, 2);
  for I := 0 to NumTables - 1 do
    if BE(12 + I * 16, 4) = $43464620 then               // 'CFF '
      Cff := BE(12 + I * 16 + 8, 4);
  if Cff < 0 then
    Exit;
  Result.IsCFF := True;
  P := SkipIndex(Cff + B[Cff + 2], Unused1, Unused2);    // INDEX des noms
  SkipIndex(P, Dict, DictEnd);                           // INDEX du Top DICT
  Operand := 0;
  CharsetOfs := 0;
  CharStringsOfs := 0;
  P := Dict;
  while P < DictEnd do
  begin
    Op := B[P];
    case Op of
      12:
        begin
          if B[P + 1] = 30 then
            Result.CIDKeyed := True;                     // ROS
          Inc(P, 2);
        end;
      0..11, 13..21:
        begin
          if Op = 15 then
            CharsetOfs := Operand
          else if Op = 17 then
            CharStringsOfs := Operand;
          Inc(P);
        end;
      28: begin Operand := SmallInt(BE(P + 1, 2)); Inc(P, 3); end;
      29: begin Operand := BE(P + 1, 4); Inc(P, 5); end;
      30:
        begin                                            // nombre réel
          repeat
            Inc(P);
          until ((B[P] and $F) = $F) or ((B[P] shr 4) = $F);
          Inc(P);
        end;
      32..246: begin Operand := Op - 139; Inc(P); end;
      247..250: begin Operand := (Op - 247) * 256 + B[P + 1] + 108; Inc(P, 2); end;
      251..254: begin Operand := -(Op - 251) * 256 - B[P + 1] - 108; Inc(P, 2); end;
    else
      Exit;                                              // octet réservé
    end;
  end;
  if (not Result.CIDKeyed) or (CharsetOfs <= 2) or (CharStringsOfs <= 0) then
    Exit;
  Result.GlyphCount := BE(Cff + CharStringsOfs, 2);
  P := Cff + CharsetOfs;
  Result.CharsetFormat := B[P];
  if Result.CharsetFormat > 2 then
    Exit;
  Inc(P);
  Result.IdentityCharset := True;
  G := 1;                                                // .notdef n'a pas d'entrée
  while G < Result.GlyphCount do
  begin
    if BE(P, 2) <> G then
      Result.IdentityCharset := False;
    case Result.CharsetFormat of
      0: Left := 0;
      1: Left := B[P + 2];
    else
      Left := BE(P + 2, 2);
    end;
    Inc(P, Result.CharsetFormat + 2);
    Inc(G, Left + 1);
  end;
end;
Un rapport avec CIDKeyed = True et IdentityCharset = False décrit exactement la police dont cet article parle : tout générateur qui place des indices de glyphe dans le flux de contenu sans tenir compte de ce charset dessinera de mauvais glyphes avec elle. Un résultat name-keyed, ou une police CID-keyed dont le charset se trouve déjà être l'identité, se rend correctement avec le même générateur. C'est ainsi qu'une police CJK d'un produit marche et pas la suivante. La boucle ne compare que le premier CID de chaque plage. C'est suffisant : une plage couvre des glyphes consécutifs portant des CIDs consécutifs, donc une plage qui démarre sur son propre indice de glyphe y reste jusqu'au bout
Les indices de glyphe traversent tout le dictionnaire de police
Un générateur PDF a rarement des CIDs sous la main. La table cmap et le moteur de mise en forme renvoient tous deux des indices de glyphe, si bien que la conception naturelle écrit ces indices comme codes Identity-H de 2 octets et fait tout le reste dépendre d'eux : le tableau de largeurs /W, le bitmap /CIDSet que PDF/A exige, et la CMap ToUnicode qui permet à l'extraction de retrouver le texte source. TrueType a une échappatoire. La table 117 offre CIDToGIDMap, mais seulement pour les CIDFonts de Type 2 ; un programme CFF vit dans une police CIDFontType0, qui n'a aucun moyen de rediriger un CID depuis le côté PDF. Cela écarte aussi une astuce que certains générateurs emploient avec TrueType — donner à un glyphe réutilisé un second CID "alias" au-delà de la fin de la police, pour que ToUnicode puisse attacher un texte différent à chaque usage. Dans une police CFF, cet alias ne sélectionne aucun glyphe, et mutool signale qu'il ne peut pas le rendre. Les polices qui mappent U+4E00 et U+2F00 (KANGXI RADICAL ONE) vers un seul contour sont le cas habituel. Si votre document a besoin que les deux s'extraient différemment, enveloppez l'occurrence dans un span de marked-content avec /ActualText (ISO 32000-1 §14.9.4), que le lecteur utilise à la place du mappage de la police
Réécrire le charset en place
Deux voies permettent de réconcilier les codes d'indice de glyphe avec un programme CID-keyed. L'une traduit chaque indice de glyphe dans le CID de la police avant de l'écrire, ce qui touche les codes du flux de contenu, les clés de /W, les positions de bits dans /CIDSet, les codes sources de ToUnicode et chaque subset à l'enregistrement. L'autre change la seule structure en désaccord, le charset, pour que la police réponde aux indices de glyphe comme le ferait un programme name-keyed. La seconde voie est la plus sûre. Le moteur de mise en forme, la table des largeurs, le subsetteur et le constructeur ToUnicode continuent tous de travailler en espace glyphe, et le seul code qui doit comprendre les CIDs est une courte routine qui passe une fois sur la copie embarquée de la police. PDFlibPas prend cette voie
La réécriture conserve le format du charset et sa longueur en octets. En format 0, chaque entrée est écrasée par son propre indice de glyphe. En formats 1 et 2, seul le premier CID de chaque plage change, et les comptes restent tels quels. Rien ne grossit ni ne rétrécit. Les décalages du Top DICT vers CharStrings, les Private DICTs, FDArray et FDSelect restent valides sans rien réencoder, et FDSelect — qui affecte les dictionnaires de hinting par indice de glyphe — garde chaque glyphe dans son FD d'origine. Les programmes name-keyed, les charsets prédéfinis, les tables CFF2 (elles n'ont pas de charset) et les programmes qui ne se parsent pas restent tranquilles. Trois chemins de code exécutent la réécriture :
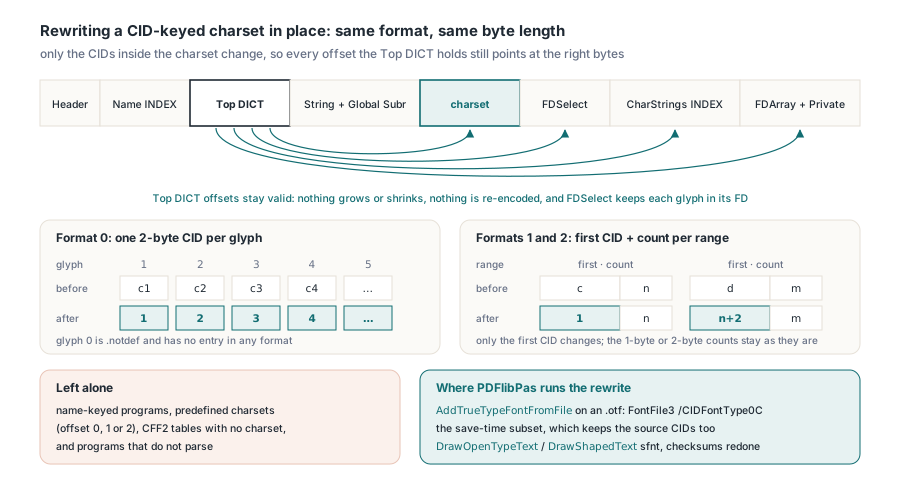
AddTrueTypeFontFromFilesur un.otfembarque la tableCFFnue commeFontFile3de sous-typeCIDFontType0C, charset déjà réécrit- Le subset à l'enregistrement garde les indices de glyphe d'origine mais aussi les CIDs sources, si bien que son charset est réécrit une seconde fois
- Le compagnon de mise en forme derrière
DrawOpenTypeTextetDrawShapedTextgarde le sfnt entier ; après la réécriture, le checksum de la tableCFFest recalculé, et lecheckSumAdjustmentde la tableheaddevient0xB1B0AFBAmoins la somme du fichier - Cet ajustement n'est défini que pour une police unique, si bien qu'une face tirée d'une collection ne reçoit que le checksum de table
uses
  SysUtils, PDFlibrary;

var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    // Un .otf à contours CFF est embarqué comme FontFile3 /CIDFontType0C ;
    // la copie embarquée reçoit un charset identité quand elle est CID-keyed
    FontID := Lib.AddTrueTypeFontFromFile('C:\Fonts\NotoSansSC-Regular.otf');
    if FontID = 0 then
      raise Exception.Create('the font file could not be read or parsed');
    Lib.SetTextSize(18);
    Lib.DrawText(56, 760, '季度报表:华东区销售汇总');
    Lib.DrawText(56, 730, '发票号码 2026-11-0187,金额 ¥12,480.00');
    if Lib.SaveToFile('noto-sc.pdf') <> 1 then
      raise Exception.CreateFmt('save failed, error %d', [Lib.LastErrorCode]);
  finally
    Lib.Free;
  end;
end;
Vérifiez le résultat en le rendant. L'extraction ne montrera pas le problème. pdftotext et tous les autres extracteurs lisent ToUnicode, qui est indexé par le code du flux de contenu et ne sait rien du contour que la police choisit pour lui, si bien qu'une page affichant de mauvais idéogrammes extrait quand même la bonne chaîne. mutool draw -r 150 -o page%d.png noto-sc.pdf montre ce que la page a vraiment l'air, et pour ce chemin DrawText, le pdffonts noto-sc.pdf de poppler doit lister la police comme CID Type 0C. Résultat attendu : les deux lignes se rendent en Noto Sans SC avec les glyphes que le texte source nomme, et la même sortie apparaît dans Ghostscript
Quelle forme d'embarquement exige PDF 1.6 ?
La forme OpenType. La table 126 de l'ISO 32000-1 liste un flux FontFile3 de sous-type CIDFontType0C comme fonctionnalité de PDF 1.3, tandis que le sous-type OpenType — le sfnt entier avec sa table CFF — n'apparaît qu'en PDF 1.6. Les nouveaux documents PDFlibPas démarrent en version 1.5, dans laquelle tient le chemin DrawText à CFF nu. Le premier appel DrawOpenTypeText, DrawShapedText ou écriture verticale avec une face CFF crée un compagnon OpenType et fait monter le document à 1.6 sur place, ce que GetPDFVersion signale immédiatement. Un verrou de version change la donne. Si LockSaveVersion a épinglé le document plus bas, la montée est refusée et SaveToFile renvoie 0 avec LastErrorCode 602, si bien qu'aucun fichier ne revendique une version que ses polices ne respectent pas. Quand un profil de livraison fixe la version sous 1.6 — PDF/A-1 étant le cas courant, puisqu'il repose sur PDF 1.4 —, posez le texte CJK via DrawText avec le .otf, ou servez-vous d'une déclinaison TrueType de la famille pour tout ce qui demande de la mise en forme
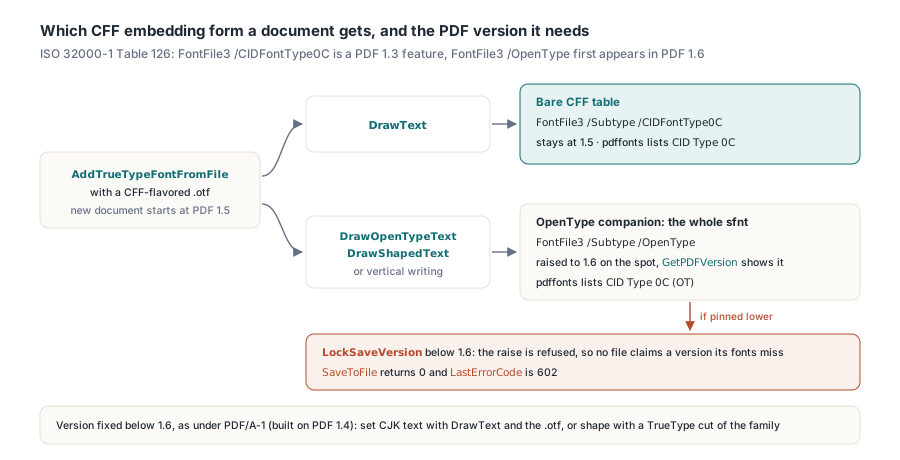
var
  Lib: TPDFlib;
  FontID: Integer;
begin
  Lib := TPDFlib.Create;
  try
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Writeln('before: ', Lib.GetPDFVersion);      // Attendu : 1.5
    if Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0) = 1 then
      Writeln('after: ', Lib.GetPDFVersion);     // Attendu : 1.6
    Lib.SaveToFile('shaped.pdf');  // Attendu dans pdffonts : CID Type 0C (OT)
  finally
    Lib.Free;
  end;

  Lib := TPDFlib.Create;
  try
    Lib.LockSaveVersion('1.5');
    FontID := Lib.AddTrueTypeFontFromFile('NotoSansSC-Regular.otf');
    Lib.DrawOpenTypeText(56, 760, FontID, 18, '《年度报告》第三章', 0);
    if Lib.SaveToFile('locked.pdf') = 0 then
      Writeln('save refused, error ', Lib.LastErrorCode);  // Attendu : 602
  finally
    Lib.Free;
  end;
end;
Des largeurs et un ToUnicode indexés par les mêmes numéros
Une fois le charset à l'identité, le CID, l'indice de glyphe et le code du flux de contenu ne font qu'un seul numéro. Les largeurs le suivent. L'ISO 32000-1 §9.7.4.3 indexe /W par CID lui-même, en groupes soit d'un CID de départ suivi d'un tableau de largeurs, soit d'un premier CID, d'un dernier CID et d'une largeur partagée, sans décalage /FirstChar du genre des polices simples. Tout CID que le tableau omet prend /DW, et la table 117 fixe le défaut de /DW à 1000. Zéro est faux. Un lecteur qui retombe sur 0 pour les CIDs non listés écrase une ligne d'idéogrammes sur elle-même. Pour un .otf chargé via AddTrueTypeFontFromFile, PDFlibPas écrit un tableau /W qui démarre au CID 0 et liste la chasse de chaque glyphe, à côté d'un /DW 1000 explicite. Côté lecture, le texte CJK qui s'extrait en charabia se trompe en général dans la moitié codespace du même pipeline, et un audit de police PDF/UA des largeurs, CharSet et CIDSet confronte ces tableaux au programme embarqué
ToUnicode a sa propre règle de numérotation. Une entrée bfrange ne stocke que la première chaîne de destination, et le §9.10.3 exige que son dernier octet ne soit pas poussé au-delà de 255 par la longueur de la plage, car un lecteur génère les destinations suivantes en n'incrémentant que ce dernier octet. Des glyphes consécutifs mappés vers U+4EFE, U+4EFF, U+4F00 et U+4F01 ont l'air d'une seule plage. Ils n'en sont pas un : un lecteur décodera le troisième en U+4E00. Le générateur de PDFlibPas fusionne des paires glyphe-vers-Unicode voisines en un bfrange seulement quand les codes sources et les destinations restent tous dans un même bloc de 256, et coupe la suite autrement. La composition CJK verticale passe par les mêmes polices compagnons, si bien que le texte japonais et chinois vertical hérite du charset identité et de ces plages ToUnicode sans appels supplémentaires
Chaque face que InspectOtfCharset signale comme CID-keyed avec un charset non identité est une où les codes d'indice de glyphe et la police se contredisent. Embarquée via PDFlibPas pour Delphi, une telle face garde ses contours, ses décalages et sa longueur de charset, et ce qui change, ce sont les CIDs de cette unique table, plus les checksums quand le sfnt entier est conservé