Oire ilmeni sivujenkopiointityökalussa, joka rakennettiin HotPDF Delphi Component -kirjaston päälle: kolmisivuisen asiakirjan sivun 1 pyytäminen tuotti johdonmukaisesti sivun 2 Indeksointilogiikan tarkistaminen ei paljastanut mitään vikaa Kutsu käytti nollapohjaista loogista indeksiä, aritmetiikka oli oikein, rajaehdot olivat kunnossa Silti väärä sivu tuli ulos joka kerta
Bugi ei ollut lainkaan kopiointikoodissa Se oli tavassa, jolla HotPDF rakensi sisäisen sivutaulukkonsa tiedostoa ladatessaan
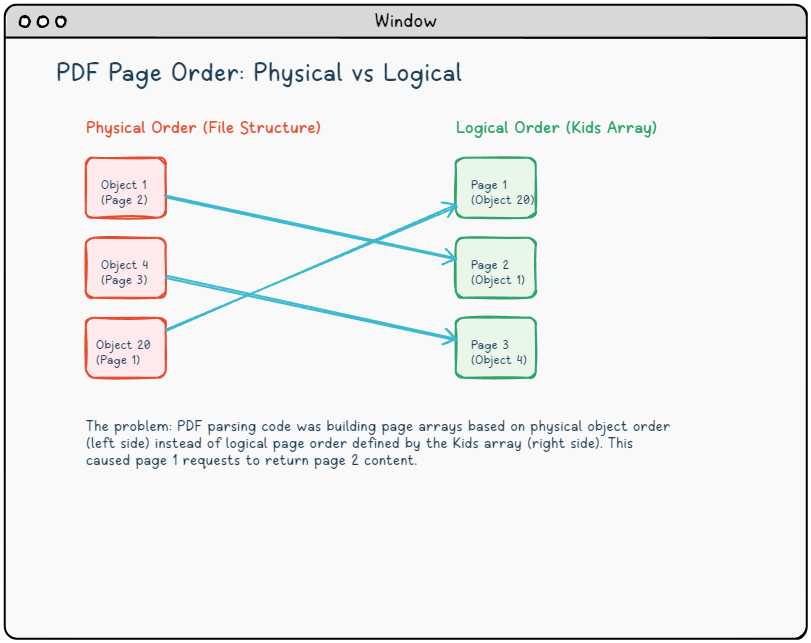
Kaksi järjestystä, yksi sekaannuksen lähde
PDF-tiedosto on kokoelma epäsuoria objekteja, joista jokainen tunnistetaan objektinumerolla Tiedostorakenne ei aseta noille numeroille mitään velvoitetta heijastaa lukujärjestystä Objekti 1 voi sisältää sivun 2; objekti 20 voi sisältää sivun 1 Se, mikä todella määrittää lukujärjestyksen, on sivupuu: hierarkia /Pages-sanakirjoja, joiden /Kids-taulukot listaavat sivuviittaukset siinä järjestyksessä, jossa katseluohjelman tulisi näyttää ne (ISO 32000-1 §7.7.3)
Bugin laukaisseessa asiakirjassa oli seuraava sivupuurakenne
{ Pages-puun juuri, objekti 16 }
16 0 obj
<<
  /Type /Pages
  /Count 3
  /Kids [20 0 R   { looginen sivu 1 }
         1 0 R    { looginen sivu 2 }
         4 0 R]   { looginen sivu 3 }
>>
endobj
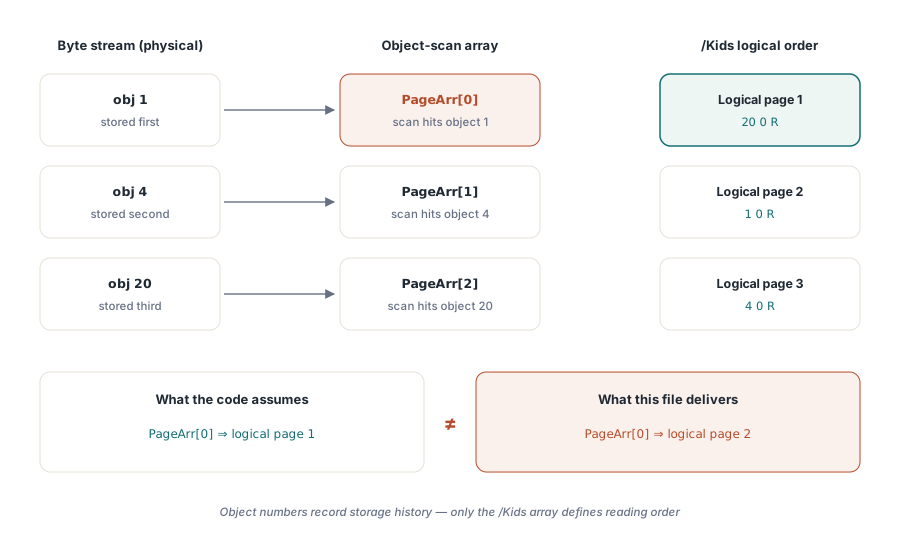
Tiedosto sattui listaamaan objektin 1 ja objektin 4 ennen objektia 20 tavuvirrassa Mikä tahansa jäsennin, joka kävi epäsuorat objektit läpi tiedostojärjestyksessä ja leimasi ne PageArr-taulukkoon löytäessään sivutyyppisiä sanakirjoja, päätyisi asettamaan objektin 1 indeksiin 0, objektin 4 indeksiin 1 ja objektin 20 indeksiin 2 Looginen sivu 1 sijaitsee kohdassa PageArr[2] Sivuindeksin 0 pyytäminen hakee sen sijaan loogisen sivun 2
Juuri näin molemmat HotPDF:n sisäiset jäsennyspolut toimivat Perinteinen polku, jota käytetään PDF 1.3/1.4 -tiedostoille, ja moderni polku, jota käytetään objektivirta-asiakirjoille (PDF 1.5+), rakensivat kumpikin PageArr-taulukon käymällä epäsuorat objektit läpi fyysisessä tiedostojärjestyksessä /Kids-ketjun seuraamisen sijaan
Hypoteesin vahvistaminen
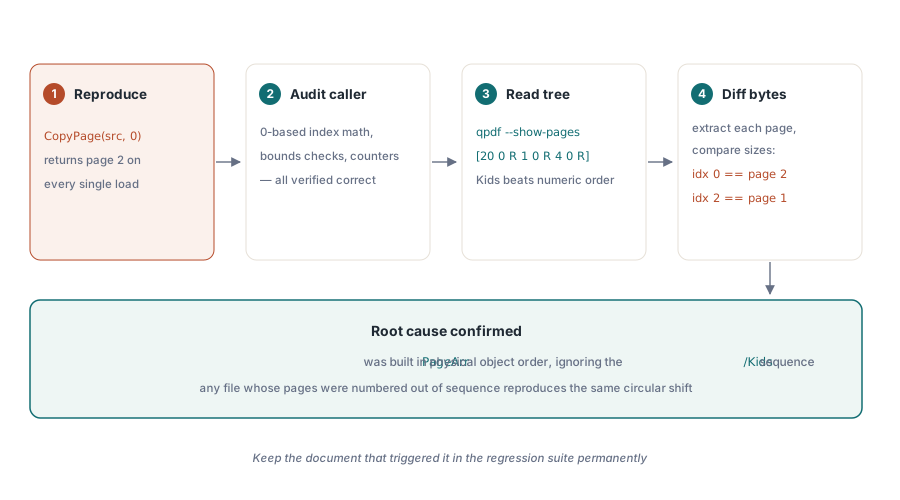
Ennen kuin mihinkään korjaukseen koskettiin, ristiriita piti todistaa eikä olettaa qpdf-komentorivityökalu tekee tästä suoraviivaista
{ komentokehote }
qpdf --show-pages input.pdf
{ Tuloste paljastaa Kids-järjestyksen: 20 0 R, sitten 1 0 R, sitten 4 0 R }

qpdf --show-object="16 0 R" input.pdf
{ Näyttää Pages-sanakirjan, jonka /Kids on lukujärjestyksessä }
Kunkin sivun erillinen poiminta ja tiedostokokojen tarkistaminen vahvisti kartoituksen: se, mitä PageArr[0] tuotti, oli loogiselle sivulle 2 kuuluva sisältö, ja PageArr[2] piti sisällään loogisen sivun 1 Kehämäinen siirtymä oli kiistaton todiste Tämä myös selitti, miksi ongelma ilmeni useissa eri lähdeasiakirjoissa: mikä tahansa PDF, jossa sivuobjekteilla sattui olemaan pienemmät objektinumerot kuin aiemmalla loogisella sivulla, laukaisisi sen
PDF-tiedostojen päätymiselle tähän tilaan on suoraviivainen syy Inkrementaaliset tallennukset liittävät päivitetyt objektit uusilla objektinumeroilla, jättäen vanhat paikat ristiviiteosataulukossa osoittamaan tyhjyyteen Muokkausohjelmat, jotka lisäävät kansisivun, lisäävät sen suurella objektinumerolla riippumatta sen sijainnista Kids-taulukossa Jotkin generaattorit kirjoittavat sivut yksinkertaisesti sisällön suoratoistolle sopivassa järjestyksessä eikä loogisessa sivujärjestyksessä PDF-formaatti ei vaadi niiltä muuta
Korjaus: seuraa Kids-taulukkoa
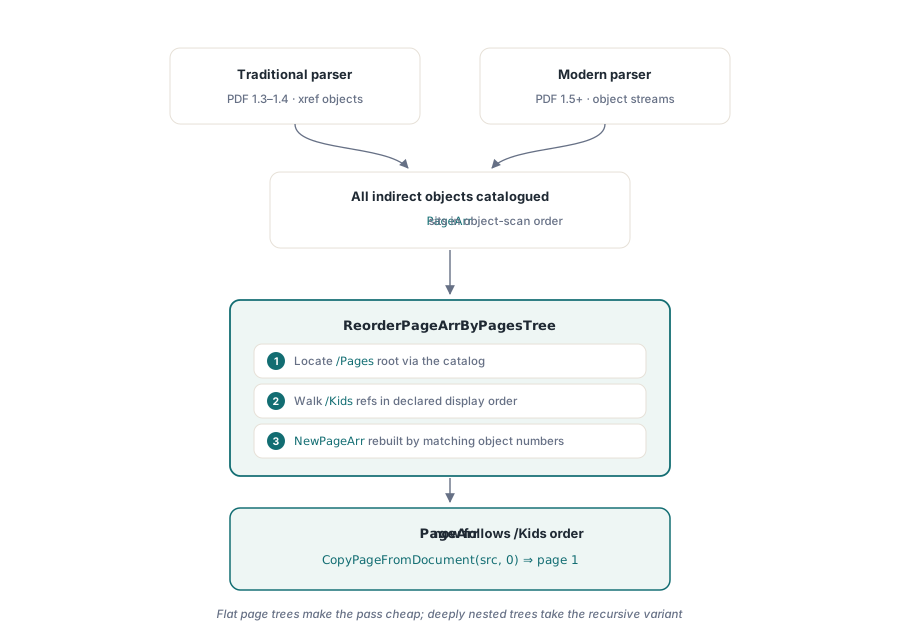
Oikea lähestymistapa on rakentaa PageArr kävelemällä /Kids-ketjua luettelojuuresta lähtien sen sijaan, että epäsuoria objekteja skannattaisiin Kun molemmat jäsennyspolut ovat suorittaneet ensimmäisen läpikäyntinsä, jälkikäsittelyvaihe ratkaisee loogisen järjestyksen
procedure THotPDF.ReorderPageArrByPagesTree;
var
  PagesObj  : THPDFDictionaryObject;
  KidsArray : THPDFArrayObject;
  NewPageArr: array of THPDFDictArrItem;
  I, J, PageIndex, KidsIndex: Integer;
  RefObj    : THPDFLink;
  PageObjNum: Integer;
  Found     : Boolean;
begin
  { Etsi juuren /Pages-sanakirja FRootIndex:in kautta }
  PagesObj := FindPagesRootFromCatalog;
  if PagesObj = nil then Exit;

  KidsIndex := PagesObj.FindValue('Kids');
  if KidsIndex < 0 then Exit;
  KidsArray := THPDFArrayObject(PagesObj.GetIndexedItem(KidsIndex));

  SetLength(NewPageArr, KidsArray.Items.Count);
  PageIndex := 0;

  for I := 0 to KidsArray.Items.Count - 1 do
  begin
    RefObj     := THPDFLink(KidsArray.GetIndexedItem(I));
    PageObjNum := RefObj.Value.ObjectNumber;

    Found := False;
    for J := 0 to Length(PageArr) - 1 do
    begin
      if PageArr[J].PageLink.ObjectNumber = PageObjNum then
      begin
        NewPageArr[PageIndex] := PageArr[J];
        Inc(PageIndex);
        Found := True;
        Break;
      end;
    end;
    { Ei-sivumuotoiset Kids-alkiot (välitason /Pages-solmut) eivät tuota osumaa; ohita }
  end;

  if PageIndex > 0 then
  begin
    SetLength(PageArr, PageIndex);
    for I := 0 to PageIndex - 1 do
      PageArr[I] := NewPageArr[I];
  end;
end;
Kutsu tehdään kunkin jäsennyspolun lopussa, sen jälkeen kun kaikki objektit on luetteloitu mutta ennen kuin mitään sivutoimintoa palvellaan
{ Perinteinen polku }
ListExtDictionary(THPDFDictionaryObject(IndirectObjects.Items[I]), FPageslink);
ReorderPageArrByPagesTree;
Break;

{ Moderni polku (objektivirrat) }
if TryParseModernPDF then
begin
  Result := ModernPageCount;
  ReorderPageArrByPagesTree;
  Exit;
end;
Uudelleenjärjestelyvaihe on O(n * m), jossa n on Kids-alkioiden määrä ja m on nykyisen PageArr-taulukon pituus, mutta jokaisella asiakirjalla, jonka sivupuu on litteä (kaikki lehdet syvyydellä 1, mikä kattaa valtaosan todellisista PDF-tiedostoista), molemmat ovat sama arvo ja kustannus on merkityksetön Syvästi sisäkkäiset sivupuut vaativat rekursiivisen läpikäynnin tässä esitetyn yksitasoisen lähestymistavan sijaan; tuotantototeutus käsittelee tuon tapauksen erikseen
CopyPageFromDocument-funktion käyttö korjauksen jälkeen
Kun ReorderPageArrByPagesTree on paikallaan, loogiset sivuindeksit toimivat odotetusti Korkeamman tason CopyPageFromDocument ottaa nollapohjaisen loogisen indeksin ja kopioi oikean sivun kohdeasiakirjaan
var
  Source, Dest: THotPDF;
begin
  Source := THotPDF.Create(nil);
  Dest   := THotPDF.Create(nil);
  try
    Source.LoadFromFile('source.pdf');

    Dest.FileName := 'extracted.pdf';
    Dest.BeginDoc;

    { Kopioi looginen sivu 0 (ensimmäinen käyttäjän näkemä sivu) }
    Dest.CopyPageFromDocument(Source, 0, 0);

    Dest.EndDoc;
  finally
    Source.Free;
    Dest.Free;
  end;
end;
CopyPageFromDocument kysyy sisäisesti sivupuun järjestyksen sen sijaan, että luottaisi raakaan PageArr-indeksiin, joten se toimii oikein myös asiakirjoja vasten, joissa fyysinen ja looginen järjestys eroavat toisistaan Eräajo-operaatioita varten InsertPagesFromDocument hyväksyy loogisten indeksien taulukon ja kopioi ne yhdellä ajolla
Mitä tämä paljastaa PDF-jäsennyksestä
PDF-määrittely on yksiselitteinen: looginen sivujärjestys määritellään sivupuun /Kids-taulukolla, ei objektinumeroilla tai tavusiirtymillä (ISO 32000-1 §7.7.3.2) Mikä tahansa jäsennin, joka käyttää oikotienä eri järjestystä, tuottaa oikeita tuloksia enemmistölle näkemistään asiakirjoista, koska useimmat generaattorit kirjoittavat sivut luonnollisessa järjestyksessä ja antavat peräkkäiset objektinumerot Bugi pysyy piilossa, kunnes joku lataa PDF:n, joka on muokattu inkrementaalisesti, järjestetty uudelleen toisella työkalulla tai tuotettu ohjelmistolla, joka valitsi erilaisen asettelun
Testaaminen vain itse tuotettuja PDF-tiedostoja vasten jättää tämän ongelmaluokan kokonaan huomiotta Sivujärjestyksen regressiokorjaus tarvitsee siksi korpuksen asiakirjoja eri lähteistä: inkrementaalisia tallennuksia, skannattuja asiakirjoja, joihin on lisätty kansisivuja, sekä PDF-tiedostoja, jotka on tuottanut ohjelmisto, joka linearisoi tai optimoi objektigraafin eri tavalla Asiakirja, joka laukaisi alkuperäisen bugin, tulisi säilyttää regressiotestisarjassa pysyvästi
HotPDF Delphi Component -sivu kattaa täyden rajapinnan sivutoiminnoille, mukaan lukien CopyPageFromDocument, InsertPagesFromDocument ja MovePage