Nimetyn nimen, joka viittaa kokonaiseen sarakkeeseen, Excel lukee yhdeksi soluksi kun se esiintyy skalaariasemassa: rivillä 7 oleva =Vertical+1 tarkoittaa nimen Vertical rivin 7 solua, ei koko aluetta. HotXLS Delphi Component soveltaa tuota implisiittistä leikkausta versiossa 2.382.4 kahdella tasolla, evaluoinnissa ja riippuvuuksien poiminnassa, koska lainamalli, jossa oli 4805 kaavaa, osoitti, ettei arvon saaminen oikein riitä. Kun riippuvuuskävelijä laajentaa nimen koko alueekseen, jatkokaava, joka ruokkii mitä tahansa tuon alueen solua, sulkee kehän jota ei ole olemassa, ja TXLSXWorkbook.Recalculate hylkää koko työkirjan
Kyseessä oleva malli on osakelainan lyhennystaulukko. Kun jokainen välimuistiin tallennettu arvo oli myrkytetty arvoon 777 ja täysi Recalculate ajettiin, molemmat moottoriarkkitehtuurit palauttivat 23, joka on lxErrorRef, kehäviittauksen virhekoodi. 3842 kaavaa 4805:stä ei täsmännyt riippumattoman odotuksen kanssa, B18:ssa oli #VALUE!, E18 oli yhä 777 ja J7:n maksujen lukumäärä oli lukenut paikkamerkit keskeneräisestä saldosarakkeesta. Yhden paluukoodin takana piili kolme erillistä vikaa, ja tämä artikkeli käy jokaisen läpi sen lähdekoodin kanssa, joka korjasi sen
Miksi skalaariviittaus sarakenimeen luo väärän kehän?
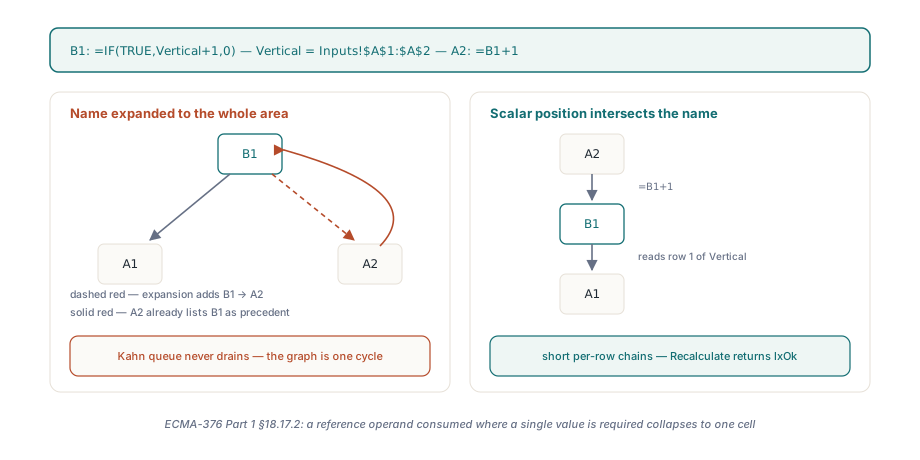
Koska riippuvuusgraafi tuntee vain reunoja, ja reuna kaavasta 480 rivin alueeseen on 480 reunaa, joista yksi osoittaa takaisin solun kautta, joka riippuu kaavasta. Tarkastele kaavaa =IF(TRUE,Vertical+1,0) solussa B1, kun Vertical on määritelty arvoksi Inputs!$A$1:$A$2, ja kaavaa =B1+1 solussa A2. Excel evaluoi B1:n arvoksi A1+1 ja A2:n arvoksi B1+1, suora ketju. Kävelijä, joka merkitsee B1:n riippuvaksi alueesta A1:A2, tekee A2:sta B1:n edeltäjän, A2 listaa jo B1:n edeltäjänään, eikä Kahn-jono, joka ajaa HotXLS:n inkrementaalista uudelleenlaskentaa, näe kummankaan solmun koskaan saavuttavan astelukua nolla. Tämä on se kuvio, josta lainamallit on tehty: jokainen kausirivi viittaa nimettyihin sarakkeisiin saldon, koron ja maksujen lukumäärän osalta, jokainen nimi kattaa koko aikataulun, ja jokainen rivi myös kirjoittaa noihin sarakkeisiin. Laajenna nimet, niin graafi on yksi valtava vahvasti kytketty komponentti. Evaluoi ne implisiittisellä leikkauksella, niin graafi on joukko lyhyitä ketjuja, yksi per rivi, mitä ECMA-376 Part 1 §18.17.2 kuvaa viiteoperandille, jota kulutetaan siellä missä vaaditaan yhtä arvoa
var
  Book: TXLSXWorkbook;
  Sheet: TXLSXWorksheet;
begin
  Book := TXLSXWorkbook.Create;
  try
    Sheet := Book.Sheets.Add('Inputs');
    Book.DefinedNames.Add('Vertical', 'Inputs!$A$1:$A$2');
    Book.DefinedNames.Add('Alias', '=Vertical');
    Sheet.Cells[1, 1].Value := 1;
    // Skalaariasema: Vertical kutistuu soluksi A1, koska kaava on rivillä 1
    Sheet.Cells[1, 2].Formula := '=IF(TRUE,Vertical+1,0)';
    Sheet.Cells[2, 1].Formula := '=B1+1';
    // Nimi, jonka määritelmä on toinen nimi, leikkaa silti, joten tämä on A2
    Sheet.Cells[2, 2].Formula := '=Alias';
    // Viiteluokan argumentti: koko alue summataan, ei leikkausta
    Sheet.Cells[3, 2].Formula := '=SUM(Vertical)';
    // Rivi 6 on alueen A1:A2 ulkopuolella, leikkaus on tyhjä ja IFERROR nappaa sen
    Sheet.Cells[6, 2].Formula := '=IFERROR(Vertical,42)';

    if Book.Recalculate = lxOk then
    begin
      // B1 = 2, A2 = 3, B2 = 3, B3 = 4, B6 = 42
      // Ennen versiota 2.382.4 tämä haara oli saavuttamaton: B1 -> A2 -> B1 oli kehä
    end;
  finally
    Book.Free;
  end;
end;
Miten HotXLS päättelee, että argumentti on skalaari?
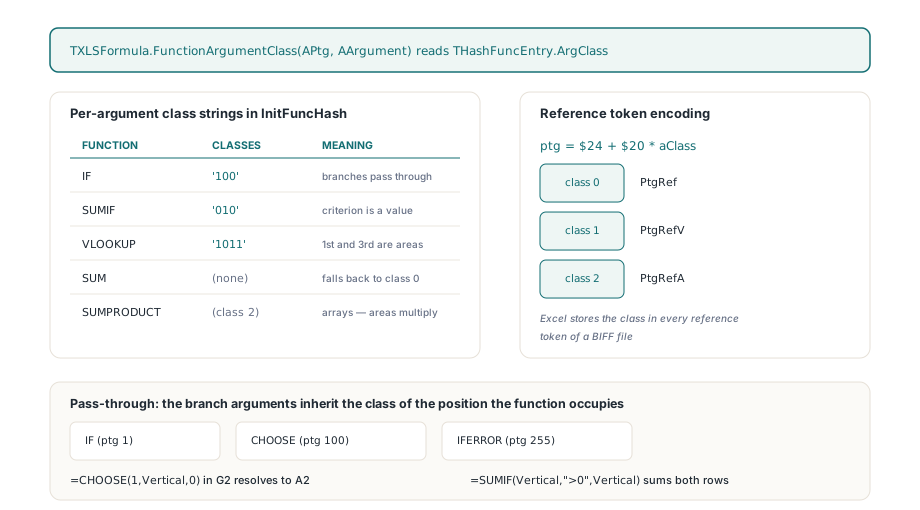
HotXLS lukee vastauksen funktiotaulukosta eikä argumentin muodosta. Jokainen TXLSFormula.InitFuncHash-taulukon merkintä rekisteröidään THashFunc.SetValue-kutsulla valinnaisen argumenttikohtaisen luokkamerkkijonon kanssa: 'IF' kantaa merkkijonoa '100', 'SUMIF' merkkijonoa '010', 'VLOOKUP' merkkijonoa '1011', eikä 'SUM' kanna mitään, joten kaikki sen argumentit putoavat funktiotason luokkaan 0. Uusi TXLSFormula.FunctionArgumentClass(APtg, AArgument) paljastaa tuon tavun THashFuncEntry.ArgClass-kentän kautta, ja tulos 1 tarkoittaa arvoluokkaa. Nämä ovat samat kolme luokkaa, jotka [MS-XLS] §2.2.2 antaa operanditokeneille, ja enkooderi on jo nojannut niihin: kirjoittaessaan viitettä se laskee ptg:n kaavalla $24 + $20 * aClass, mikä tuottaa luokalle 0 arvon PtgRef, luokalle 1 arvon PtgRefV ja luokalle 2 arvon PtgRefA. Excelin kirjoittama BIFF-tiedosto tallentaa tuon luokan jokaiseen viitetokeniin, joten moottori, jonka taulukko vastaa spesifikaatiota, osaa vastata kysymykseen argumentin skalaarisuudesta katsomatta dataa. SUMIF:n keskimmäinen argumentti on ehto, arvo; ensimmäinen ja kolmas ovat alueita, viitteitä. SUMPRODUCT on rekisteröity funktiotason luokalla 2, taulukko, minkä takia =SUMPRODUCT(Vertical,Vertical) kertoo yhä koko alueen
Kolme funktiota ei katso omaa taulukkomerkintäänsä minkään ensimmäistä argumenttia pidemmälle. IF (ptg 1), CHOOSE (ptg 100) ja IFERROR (ptg 255) päästävät läpi sen minkä valitsevatkin, joten niiden haarargumentit perivät sen luokan, jossa itse funktio sijaitsee. Tuo yksi sääntö on se, mikä antaa kaavan =CHOOSE(1,Vertical,0) G2:ssa ratketa soluksi A2 samalla kun sen vieressä oleva =SUMIF(Vertical,">0",Vertical) summaa yhä molemmat rivit, ja se on sääntö, jota lyhennystaulukko koettelee eniten, koska sen kausisolut nojaavat IF-funktioon testatakseen, onko laina yhä auki
Luokan kuljettaminen riippuvuuskävelyn läpi
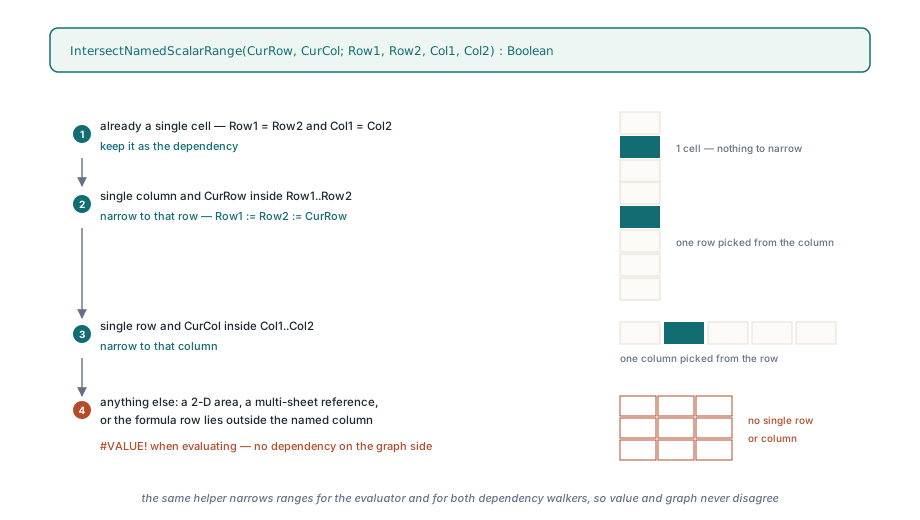
lxCalc.pas:n riippuvuudenpoimija on rekursiivinen Walk käännetyllä syntaksipuulla, ja se on olemassa kahdesti, kerran TXLSCalculator.ExtractDependencies-funktiossa työkirjakohtaiselle graafille ja kerran ExtractWorkspaceDependencies-funktiossa työkirjojen väliselle graafille. v2.382.4 antaa molemmille kävelijöille kaksi lisäparametria. AScalar alkaa arvona True kaavan juuressa, lasketaan uudelleen jokaiselle funktiolapselle FunctionArgumentClass-funktiosta ja välitetään muuttumattomana ptg:n 1, 100 ja 255 haarargumenteille. ANameRoot tulee arvoksi True vain kun kävelijä laskeutuu nimen käännettyyn määritelmään, ja se säilyy vain SA_GROUP-solmujen eli sulkujen läpi, joten nimeksi =A1:A2+1 määriteltyä ei sekoiteta pelkäksi alueeksi. Kun molemmat liput ovat True SA_RANGE-solmussa, AddResolvedRange kaventaa alueen samalla apufunktiolla, jota evaluaattori käyttää, ennen kuin se tallentaa riippuvuuden. Apufunktio on tarpeeksi lyhyt siteerattavaksi kokonaan
function IntersectNamedScalarRange(CurRow, CurCol: Integer;
  var Row1, Row2, Col1, Col2: Integer): Boolean;
begin
  Result := False;
  if (Row1 = Row2) and (Col1 = Col2) then Exit(True);   // on jo solu
  if (Col1 = Col2) and (CurRow >= Row1) and (CurRow <= Row2) then
  begin
    Row1 := CurRow; Row2 := CurRow;                     // yksittäinen sarake: otetaan tämä rivi
    Exit(True);
  end;
  if (Row1 = Row2) and (CurCol >= Col1) and (CurCol <= Col2) then
  begin
    Col1 := CurCol; Col2 := CurCol;                     // yksittäinen rivi: otetaan tämä sarake
    Result := True;
  end;
end;
Kaikki, minkä apufunktio hylkää — kaksiulotteinen alue, usean taulukkosivun viittaus tai kaava, jonka rivi on nimetyn sarakkeen ulkopuolella — tuottaa #VALUE!-arvon evaluointipuolella eikä yhtään riippuvuutta graafipuolella, mikä on se, mitä Excel tekee tyhjälle leikkaukselle. Evaluointipuoli asuu TXLSCalculator.GetValueItemName-funktiossa: se riisuu SA_GROUP-kehykset käännetyistä määritelmistä ja kutsuu GetRangeInfo-funktiota, jos juuri on SA_RANGE, leikkaa ja hakee yhden solun FGetValue-funktion kautta sen sijaan, että evaluoisi koko määritelmän. Ulkoiset viittaukset pysyvät vanhalla polulla, koska leikattavaa paikallista riviä ei ole. Siitä, mistä nimen tallennus ja näkyvyysalue tulevat, kerrotaan määriteltyjä nimiä ja taulukkosivujen välisiä kaavoja käsittelevässä artikkelissa; tässä oleellista on vain se, mitä moottori tekee kun nimi on ratkennut
Miksi MATCH puoliksi lasketun sarakkeen yli luki 777?
Koska MATCH:n hakutaulukkoargumentti on skannausviittaus, ja skannausviittaukset jätettiin tarkoituksella evaluointijärjestyksen ulkopuolelle. Hakuskannausta käsittelevä artikkeli esitteli TXLSDepRange.LookupScan-kentän ja päättyi osioon "Mitä menetät jättämällä skannausreunat järjestyksen ulkopuolelle": hakukaava voi ajautua ennen kuin jokainen sen alueen solu on laskettu uudelleen ja lukea vanhentuneita arvoja. Interaktiivisessa istunnossa se suppenee seuraavalla kierroksella. Myrkytetyn mallin eräajossa ei, ja PaymentCount, joka on määritelty arvoksi =MATCH(0.01,Balances,-1)+1, luki saldosarakkeessa yhä olevat 777-paikkamerkit ja palautti kausiluvun, joka ei voinut olla oikein
TXLSDepGraph.TopoOrder kohtelee nyt skannausreunoja pehmeinä järjestysreunoina. Kovana astelukuna se pitää rinnalla ScanInDeg-taulukkoa, joka laskee likaiset skannausedeltäjät solmua kohden ja vähentää niitä sitä mukaa kun ne on käsitelty, käyttäen ScanPrecedents-, ScanDependents- ja ScanPrecedentCount-listoja, jotka aiempi muutos jo tallensi. Jokaisella kierroksella Kahn-jono selaa valmisikkunansa läpi ensimmäiseen solmuun, jonka ScanInDeg on nolla, ja vaihtaa sen kärkeen; jos jokainen valmis solmu odottaa yhä skannausedeltäjää, kärki poistetaan stabiilissa järjestyksessä. Skannausreunat eivät koskaan päädy kovaan astelukuun, joten itsensä viittaava VLOOKUP oman sarakkeensa yli on yhä laillinen, mutta haku, joka voisi odottaa valmistuvaa edeltäjää, odottaa nyt. Tämän kiinnittävä regressiotesti LookupScan_WaitsForDirtyFormulaValues myrkyttää kolme saldosolua arvoon 777 ja odottaa PaymentCount-arvon palaavan arvona 3, kääntää sitten syötteen nollaksi ja odottaa kaavan =IFERROR(PaymentCount,99) näkevän #N/A-arvon ja palauttavan 99
Mistä neljän desimaalin katkaisu tuli?
Delphin Variant-aritmetiikasta, ja vain sisäkkäisissä asemissa. TXLSCalculator.GetValueItem-funktion binäärioperaattorit kopioivat jo ylätason +- tai --operaation kahteen Double-paikallismuuttujaan, joten =B1-A1 oli kunnossa. Kaavan =IF(TRUE,B1-A1,0) sisällä sama vähennyslasku ajettiin muodossa Value := Value - SubValue kahdella Variantilla, ja kun toinen operandi oli Int64-solun arvo ja toinen Double, havaitsimme tulokseksi Currency-tyypin, kiinteän desimaaliluvun jossa on neljä desimaalia, joten 1066.1854641400994 miinus 120 palasi neljään desimaaliin katkaistuna. Aikataulussa, jossa jokainen maksu ketjutetaan edelliseltä riviltä, tuo virhe kulkee satojen kausien läpi ennen kuin se saavuttaa loppusummat
// TXLSCalculator.GetValueItem, binääriaritmetiikan haara (lxCalc.pas)
if VarIsNull(Value) then Value := 0;
if VarIsNull(SubValue) then SubValue := 0;
// Sekamuotoinen Int64/Double-Variant-aritmetiikka voi ylentyä Currency-tyypiksi.
// Taulukkolaskennan on säilytettävä liukulukutarkkuus.
if VarIsNumeric(Value) then Value := Double(Value);
if VarIsNumeric(SubValue) then SubValue := Double(SubValue);
Vartija ajetaan ennen SA_ADD-, SA_SUB-, SA_MUL- ja SA_DIV-operaatioita yhtä lailla, ja regressiotesti Arithmetic_MixedInt64AndDoubleKeepsPrecision tallentaa arvon Int64(120) soluun A1 ja arvon 1066.1854641400994 soluun B1 ja tarkistaa sisäkkäisen erotuksen ja summan tarkkuudella 1E-10 sekä tulon ja osamäärän tarkkuuksilla 1E-8 ja 1E-12. HotXLS ei väitä tuntevansa kaikkia ylennyssääntöjä, joita RTL soveltaa sekatyyppisiin Variant-arvoihin eri kääntäjäversioilla; se väittää, että taulukkolaskenta on IEEE double, ja se tekee nyt molemmista operandeista double-tyyppisiä ennen kuin operaattori näkee ne, mikä poistaa kysymyksen
Mitä korjaus takaa ja mitä ei
Version 2.382.4 jälkeen molemmat moottoriarkkitehtuurit palauttavat myrkytetylle mallille lxOk, kaikki 4805 välimuistiin tallennettua arvoa täsmäävät riippumattoman rivi riviltä -odotuksen kanssa tarkkuudella 1E-7, ja väitteet siitä että välimuistit todella myrkytettiin, että lähdetiiviste on muuttumaton ja että jokainen kaava on yhä paikallaan pitävät. Yhtään iteraatiota ei otettu käyttöön eikä yhtään virhekoodia vaiennettu, jotta tähän päästiin. Aito kehä nimen kautta, =B1 solussa A1 kun B1 lukee yhä Vertical-nimeä, palauttaa yhä virheen, ja testi NamedScalarRanges_IntersectWithoutFalseCycles päättyy väittämään juuri sitä
Rajat kannattaa sanoa selvästi. Implisiittinen leikkaus koskee vain nimeä, jonka käännetty määritelmä on sulkujen riisumisen jälkeen yhden sarakkeen tai yhden rivin alue yhdellä taulukkosivulla; kaksiulotteinen nimi skalaariasemassa on #VALUE!, kuten Excelissäkin, ja funktio, jota taulukko ei tunne, saa luokan 0 FunctionArgumentClass-funktiosta, joten sen nimiargumentit laajennetaan yhä kokonaan. Pehmeä järjestys on mieltymys, ei tae: pelkän skannauksen varassa oleva kehä evaluoidaan yhä stabiilissa järjestyksessä ja se lukee sen mitä välimuistissa on, mikä on se käytös, jonka hakuskannausartikkeli hyväksyi tarkoituksella. Ja koko mallin tulos on vahvistettu riippumatonta odotusskriptiä eikä toista taulukkolaskentamoottoria vasten, koska viiteohjelmistopaketti ei saanut alkuperäisen mallin uudelleenlaskentaa valmiiksi 60 sekunnin budjetissa. HotXLS on natiivi Delphi- ja C++Builder-taulukkokomponentti, joka lukee, laskee uudelleen ja kirjoittaa XLS-, XLSX-, ODS- ja CSV-muotoja ilman asennettua Exceliä; nimen leikkaus, argumenttiluokkataulukko ja pehmeä skannausjärjestys pätevät joka formaattiin, koska laskentamoottori on yhteinen, ja nykyinen funktiokattavuus luetellaan HotXLS Delphi -taulukkokomponentin tuotesivulla