HotPDF Delphi Component pystyy etsimään ja korvaamaan tekstiä olemassa olevan PDF-tiedoston sisällä Delphistä ja C++Builderista. SearchLoadedPageText ja SearchLoadedDocumentText paikantavat merkkijonon jokaisen esiintymän glyfitason tarkkuudella, ja ReplaceLoadedPageText ja ReplaceLoadedDocumentText kirjoittavat osuneet tavut uudelleen paikallaan — edellyttäen, että jokainen korvaava merkki voidaan koodata uudelleen alkuperäisen fontin kautta, mikä on fyysinen rajoite, jota tämä artikkeli käsittelee rehellisesti sen sijaan, että piilottaisi sen alaviitteeseen
Tämän ominaisuuden takana oleva pyyntö on aina arkinen. Yritys vaihtaa nimensä, ja kolmetuhatta arkistoitua laskua kantaa yhä vanhaa nimeä. Sopimuspohja toimitettiin viimevuotisella vanhenemispäivällä. Tuotekoodi poistettiin käytöstä, ja jokainen sen mainitseva tuotelehti tarvitsee tilalle seuraajakoodin. Tekstinkäsittelyohjelmassa jokainen näistä on kolmenkymmenen sekunnin työ. PDF:ssä se on aidosti vaikea ongelma, ja sen ymmärtäminen miksi tekee eron rajapinnan hyvän käytön ja sellaisen vikailmoituksen välillä, joka on todellisuudessa spesifikaatioviittaus
Miksi tekstin korvaaminen PDF:ssä on niin vaikeaa?
Tekstin korvaaminen PDF:ssä on vaikeaa, koska PDF-sivu ei sisällä muokattavaa tekstiä — se sisältää sijoitettuja glyfejä. ISO 32000-1 §9.4:n tekstinnäyttömallin mukaan sisältövirta ajaa operaattoreita kuten Tj ja TJ, jotka piirtävät merkkikoodijonoja tekstimatriisin määräämiin koordinaatteihin. Nuo koodit eivät ole Unicodea; ne ovat indeksejä siihen koodaukseen, jonka sivun fontti ilmoittaa, ja takaisinmäppäys luettaviksi merkeiksi voi asua /ToUnicode-CMapissa, koodauksen erotaulukossa (difference array) tai CID-mäppäysketjussa. Kappaleobjektia ei ole, tekstin virtausta ei ole, eikä ole mitään takeita siitä, että yksi visuaalinen sana olisi edes tallennettu yhtenä merkkijonona
Korvaaminen lisää dekoodauksen päälle toisen vaikeuskerroksen: sinun on tiedettävä täsmälleen, mitkä alkuperäisen virran tavut tuottivat kunkin glyfin, jotta voit liittää uudet tavut juuri siihen väliin eikä mihinkään muuhun. Tekstin poimija voi heittää tavusijainnit pois heti kun se on saanut Unicoden ulos. Korvaaja ei voi. Siksi HotPDF jakoi työn kahteen julkaisuun — v2.251.0 rakensi siirtymien seurannan ja hakukerroksen, ja v2.252.0 rakensi uudelleenkirjoituskerroksen sen päälle
Tekstin löytäminen: glyfitason haku tavusiirtymien seurannalla
HotPDF:n SearchLoadedDocumentText löytää hakusanan jokaisen esiintymän vertaamalla sitä kunkin sivun purettuun Unicode-glyfijonoon, ei raakoihin virtatavuihin, joten osuma on osuma riippumatta siitä, miten fontti sen koodasi. Alla oleva infrastruktuuri esiteltiin versiossa v2.251.0: sisältövirran tokenisoija kirjaa StartOfs/EndOfs-tavuvälin jokaiselle merkkijono-operandille — mukaan lukien sen ( )- tai < >-erottimet — ja jokainen purettu glyfi kantaa TokenIndex/ItemIndex/ByteOffset-kolmikkoa, joka osoittaa takaisin täsmälleen siihen operandiin, TJ-taulukon alkioon ja koodiyksikköön, joka sen tuotti. Sama glyfitulkki toimii voimanlähteenä myös poimintarajapinnalle, jota kuvataan artikkelissa tekstin poiminta ladatusta PDF:stä Delphissä; haku vain säilyttää sen alkuperätiedon, jonka poiminta heittää pois
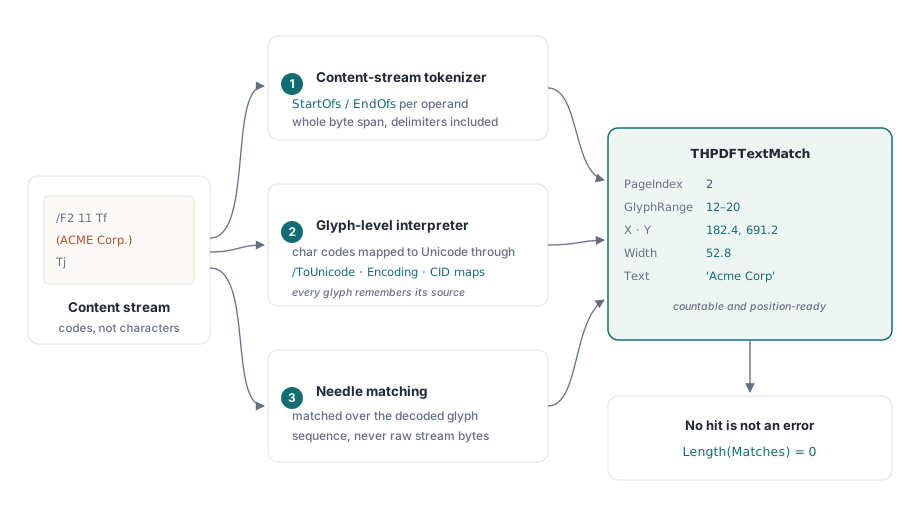
Jokainen osuma palautuu THPDFTextMatch-tietueena, joka kantaa sivuindeksiä, inklusiivista glyfiväliä, osuman käyttäjäavaruuden X/Y-alkupistettä ja leveyttä, lähdetokenin ja alkion indeksiä sekä itse osunutta tekstiä. Se riittää ajamaan korostuspeitteen, katselmointikäyttöliittymän tai korvausvaiheen. Haku, joka ei löydä mitään, palauttaa tyhjän taulukon epäonnistumisen sijaan, joten kutsumalli pysyy yksinkertaisena
var
  Pdf: THotPDF;
  Matches: THPDFTextMatchArray;
  I: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('invoices-2025.pdf') > 0 then
    begin
      if Pdf.SearchLoadedDocumentText('Acme Corp', False, Matches) then
        for I := 0 to Length(Matches) - 1 do
          WriteLn(Format('page %d at (%.1f, %.1f): "%s"',
            [Matches[I].PageIndex, Matches[I].X, Matches[I].Y,
             Matches[I].Text]));
    end;
  finally
    Pdf.Free;
  end;
end;
Yksi tietoinen suunnitteluvalinta ansaitsee huomion. Kun CaseSensitive on False, vertailu taittaa kirjainkoon vain ASCII-merkeille, ja se on tarkoituksellista: täysi Unicode-kirjainkoon taitto käyttäytyy eri tavoin niissä Delphi 5 - XE -työkaluketjuissa, joita HotPDF tukee, ja hakurajapinta, joka löytää eri osumia sen mukaan, mikä kääntäjä sovelluksesi käänsi, on huonompi kuin sellainen, jolla on dokumentoitu ja ennustettava raja. Latinalaiselle liiketoimintatekstille — nimille, koodeille, päivämäärille — ASCII-taitto kattaa käytännön tapaukset
Tekstin korvaaminen: käänteinen koodaus ja kirurginen liittäminen
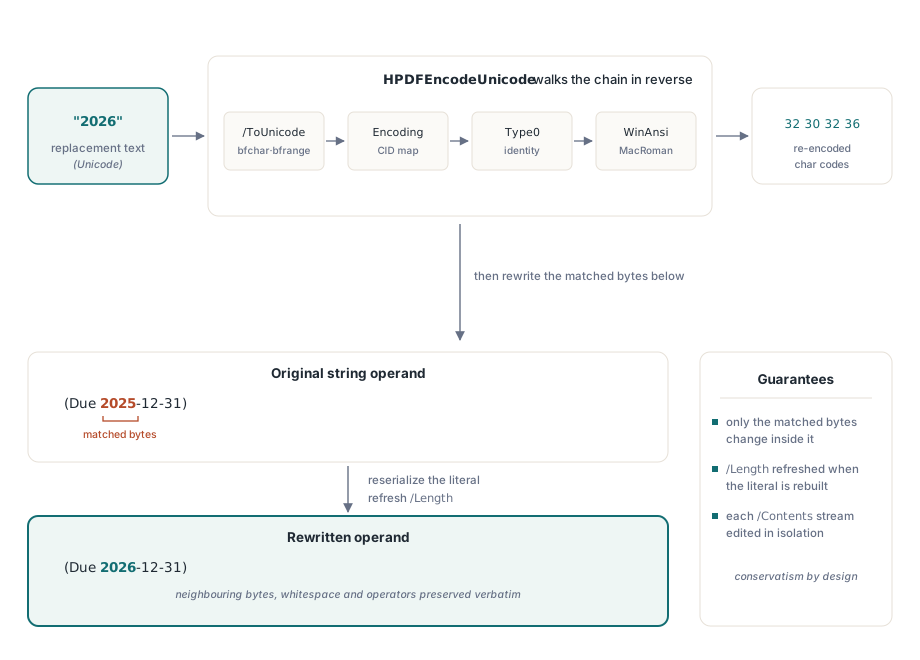
ReplaceLoadedDocumentText, joka lisättiin HotPDF v2.252.0:aan, kirjoittaa hakusanan jokaisen esiintymän uudelleen ajamalla dekoodauskoneistoa takaperin. Funktio HPDFEncodeUnicode on merkkikoodien purkajan käänteisoperaatio: se kävelee saman strategiaketjun käänteisessä järjestyksessä — /ToUnicode-haun bfchar ja bfrange, koodausvirran CID-mäppäyksen, Type0-identiteettimäppäykset sekä ennalta määritellyt WinAnsi- ja MacRoman-taulukot — muuttaakseen kunkin korvaavan merkin takaisin niiksi merkkikooditavuiksi, joita alkuperäinen fontti odottaa. Uudelleenkoodatut tavut sarjoitetaan sitten hyvin muodostetuksi merkkijonoliteraaliksi tai heksamerkkijonoksi, peilaten tokenisoijan omia suojaussääntöjä niin, että jäsennys- ja uudelleensarjoituskierros on vakaa
Liittäminen itsessään on kirurgista eikä kokonaisvaltaista. Vain se kooditavuväli, jonka osuma kattaa, korvataan merkkijono-operandin sisällä; saman operandin osumattomat tavut, tokenien välinen tyhjä tila ja kaikki ympäröivät operaattorit säilytetään sanatarkasti, tavu tavulta. Merkkijonon bca korvaaminen merkkijonossa abcabc tuottaa a + korvaus + bc, ei rikottua operandia. Korvaukset voivat olla hakusanaa lyhyempiä tai pidempiä — literaali sarjoitetaan uudelleen ja virran /Length päivitetään — ja monivirtaisen sivun jokainen /Contents-virta käsitellään erillään, joten sivu pysyy hyvin muodostettuna
var
  Pdf: THotPDF;
  ReplaceCount: Integer;
begin
  Pdf := THotPDF.Create(nil);
  try
    if Pdf.LoadFromFile('contract-draft.pdf') > 0 then
    begin
      if Pdf.ReplaceLoadedDocumentText('2025-12-31', '2026-12-31',
        True, ReplaceCount) then
        WriteLn(Format('%d operand rewrites performed', [ReplaceCount]));
      Pdf.SaveLoadedDocument('contract-final.pdf');
    end;
  finally
    Pdf.Free;
  end;
end;
Huomaa, mitä rajapinta ei tee: se ei ladota sivua uudelleen. PDF:ssä ei ole tekstin uudelleenvirtausta, joten korvaus, joka on visuaalisesti alkuperäistä leveämpi, vie yksinkertaisesti enemmän vaakatilaa ja voi ahtaa sitä, mikä on piirretty sen oikealle puolelle. Saman- tai lähes samanmittaiset korvaukset — päivämäärät, versiomerkkijonot, osanumerot, nimikorjaukset — ovat makein kohta. Kokonaisvaltainen uudelleensanoittaminen kuuluu lähdedokumenttiin, ei PDF-tiedostoon
Miksi tekstiä ei voi korvata merkeillä, joita fontin osajoukko ei koskaan sisältänyt?
Tekstiä ei voi korvata merkillä, jota upotettu fontin osajoukko ei koskaan sisältänyt, koska sitä tavusekvenssiä, joka valitsisi kyseisen merkin, ei yksinkertaisesti ole olemassa fontin mäppäystaulukoissa. Kun PDF-tuottaja upottaa osajoukkofontin, sen /ToUnicode-CMap ja koodausrakenteet kattavat vain ne glyfit, joita alkuperäinen dokumentti todella käytti. HPDFEncodeUnicode voi kääntää vain sellaisen mäppäyksen, joka on olemassa: jos dokumentti ei koskaan sisältänyt kirjainta E siinä fontissa, ei ole merkkikoodia, johon E voisi kääntyä. Tämä on tiedoston fyysinen ominaisuus, ei minkään tietyn kirjaston rajoitus — mikään työkalu ei voi loihtia glyfimäppäystä, jota ei koskaan upotettu
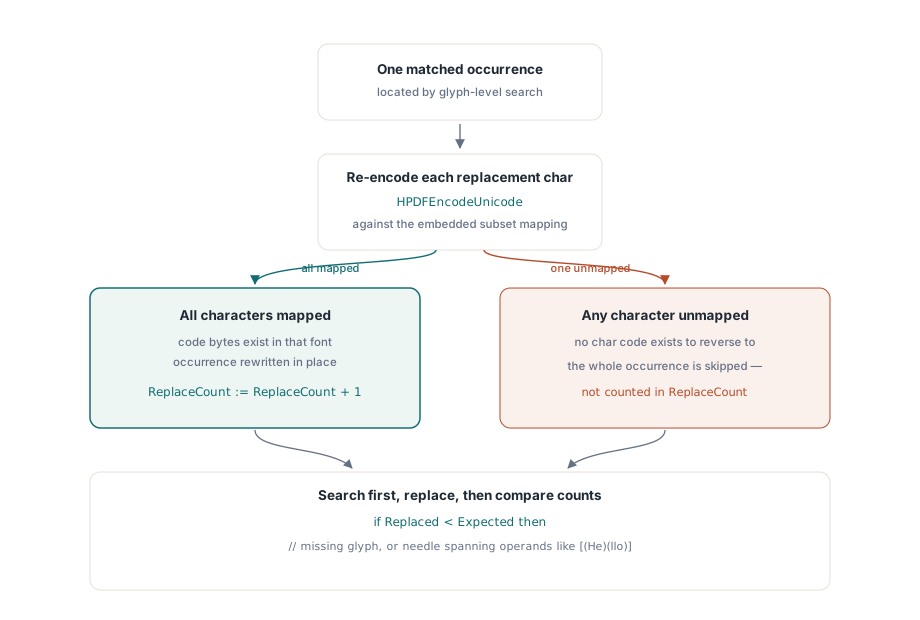
HotPDF käsittelee epäonnistumisen varovaisesti. Jos yksikin korvauksen merkki ei ole uudelleenkoodattavissa, koko kyseinen hakusanan esiintymä ohitetaan — ei poikkeusta, ei osittaista roskatekstiä, eikä esiintymää yksinkertaisesti lasketa ReplaceCount-arvoon. Käytännön seuraus: vertaa ReplaceCount-arvoa aiemman haun osumamäärään ja tulkitse vajaus signaaliksi. Yllä olevassa päivämääräesimerkissä numeron 6 on esiinnyttävä jossain dokumentin tekstissä samalla fontilla, jotta uudelleenkirjoitus onnistuu — laskussa todennäköisesti, yleisessä tapauksessa ei koskaan taattua. Kun tarvitsemasi merkit eivät yksinkertaisesti ole saatavilla ja tavoitteena on poistaa arkaluonteista tekstiä sen uudelleensanoittamisen sijaan, todellinen sisällön poisto on joka tapauksessa parempi työkalu; katso sitä reittiä varten ladattujen PDF-tiedostojen sensurointi ja uudelleenjärjestely Delphissä
var
  Matches: THPDFTextMatchArray;
  Expected, Replaced: Integer;
begin
  Pdf.SearchLoadedDocumentText('Acme Corp', True, Matches);
  Expected := Length(Matches);
  Pdf.ReplaceLoadedDocumentText('Acme Corp', 'Apex Corp', True, Replaced);
  if Replaced < Expected then
    WriteLn(Format('%d occurrence(s) skipped: characters missing ' +
      'from the font subset, or match spans multiple operands',
      [Expected - Replaced]));
end;
Tuon viestin toinen ohitusehto on se toinen dokumentoitu raja: hakusana, joka ulottuu useamman merkkijono-operandin yli — esimerkiksi Hello jaettuna [(He)(llo)] TJ -alkioihin — löytyy haulla, koska haku vertaa purettua glyfijonoa, mutta korvaus ohittaa sen, koska uudelleenkirjoittaminen operandirajojen yli vaatisi vierekkäisten tavuvälien yhdistämistä. Etsi-sitten-varmista tekee molemmat rajat näkyviksi hiljaisuuden sijaan
Mikä tiedostossa muuttuu, kun tallennat?
Korvattu /Contents-virta tallennetaan pakkaamattomana. FlateDecode-pakatut virrat puretaan muokkausta varten, ja kun HotPDF kirjoittaa uudelleenrakennetut tavut, se pudottaa virran /Filter-merkinnän ja päivittää /Length-arvon sen sijaan, että pakkaisi uudelleen. Syntyvä PDF on täysin validi ja piirtyy normaalisti valtavirran katseluohjelmissa; kompromissina on suurempi tiedosto jokaista muokattua virtaa kohti. Tuhansia dokumentteja käsittelevässä eräputkessa varaudu tuohon kasvuun tai aja erillinen pakkausajo myöhemmässä vaiheessa. Se, miten uudelleenkirjoitetut objektit toimivat tallennettaessa yhdessä dokumentin ristiviittausrakenteen kanssa, on oma aiheensa, jota käsitellään artikkelissa objektivirrat ja inkrementaaliset päivitykset HotPDF:ssä
Kaikki muu tiedostossa jätetään rauhaan. Koskemattomat virrat säilyttävät pakkauksensa, fontteja ja kuvia ei kirjoiteta uudelleen, ja operanditason liittäminen tarkoittaa, että muokatutkin virrat poikkeavat alkuperäisestä vain siellä, mihin osuma osui. Tuo varovaisuus on tarkoituksellista: mitä enemmän kirjasto kirjoittaa ladatusta dokumentista uudelleen, sitä enemmän sillä on tilaisuuksia rikkoa jokin tuottajan erikoisuus, jota se ei osannut ennakoida
Tekstin haku ja korvaus liittyvät poiminnan, sensuroinnin ja sivujen renderöinnin seuraan HotPDF:n ladatun dokumentin työkalupakissa, ja kaikkia ajaa sama sisältövirran tulkki, joka on käytettävissä Delphi 5:stä nykyisiin RAD Studio -julkaisuihin ilman ulkoisia riippuvuuksia. Täydellinen rajapintaviite ja kokeiluversion lataus löytyvät HotPDF Delphi Component -tuotesivulta